网络体系
前面几篇讲过,Service 能给一组 Pod 提供固定入口。但「Pod 拿到 IP 之后,跨节点的两个 Pod 究竟是怎么通起来的」一直没展开。这篇把 K8s 的网络体系讲透:网络模型定下的规矩、CNI 插件怎么实现这张网、kube-proxy 怎么做 Service 转发,最后给一套网络排障的标准流程。
Kubernetes 网络模型
Kubernetes 不规定网络的具体实现,但定下了三条必须满足的硬性要求:
- 每个 Pod 都有独立的 IP 地址:Pod 内的所有容器共享这一个 IP 和网络命名空间,对外就像一台独立的主机。
- Pod 与 Pod 之间可以直接通信,无需 NAT:不管两个 Pod 在不在同一台节点上,都能用对方的 IP 直接访问。
- 节点与 Pod 之间也可以直接通信,无需 NAT:宿主机可以直接访问本机和其他节点上 Pod 的 IP。
三条合起来就一个意思:整个集群在效果上是一张扁平的大网,每个 Pod 都像直接插在这张网里的真实机器,IP 全网唯一、全网可达。
这套要求和 Docker 单机网络的差别非常大:
| 对比项 | Docker 单机(默认 bridge) | Kubernetes 集群网络 |
|---|---|---|
| IP 分配 | 宿主机私有网段(默认 172.17.0.0/16),只在本机有意义 | 全集群统一规划的 Pod 网段,每个 Pod IP 全局唯一 |
| 跨主机通信 | 默认不通,要靠 -p 端口映射 + 宿主机 IP | 天然互通,直接用 Pod IP 访问 |
| NAT | 容器出宿主机全靠 NAT(端口映射、masquerade) | 集群内 Pod 通信不做 NAT |
| 端口管理 | 宿主端口要自己分配,容易冲突 | Pod 各有独立 IP,端口随便用 |
Docker 靠端口映射把多个容器挤在一个宿主 IP 上,规模一大,「哪台机器的哪个端口是什么服务」根本没法管。K8s 干脆规定每个 Pod 一个全网可达的 IP,从根上消灭端口冲突和服务发现问题——代价是把「怎么实现这张大网」这个难题留给了网络插件,也就是下面要讲的 CNI。
CNI
CNI(Container Network Interface)是一套接口规范,定义了容器运行时和网络插件之间该怎么对话。K8s 自己不实现网络,只要求插件按规范提供几个操作,最核心的两个是:
- ADD:创建 Pod 时调用,负责给 Pod 配网——分配 IP、创建 veth 对、接上网桥、写好路由。
- DEL:删除 Pod 时调用,把 ADD 分配的资源全部回收。
(规范里还有 CHECK、VERSION 等操作,日常打交道最多的还是 ADD 和 DEL。)
节点上和 CNI 相关的两个固定位置:
| 位置 | 存放内容 |
|---|---|
/etc/cni/net.d/ | CNI 配置文件(.conf / .conflist),按文件名排序取第一个生效 |
/opt/cni/bin/ | CNI 插件的二进制文件(bridge、host-local、loopback 等) |
一份典型的配置文件长这样(以 bridge 插件为例):
{
  "cniVersion": "1.0.0",
  "name": "mynet",
  "type": "bridge",
  "bridge": "cni0",
  "ipMasq": true,
  "ipam": {
    "type": "host-local",
    "subnet": "10.244.0.0/16"
  }
}
创建 Pod 时,kubelet 与 CNI 的调用链是这样的:
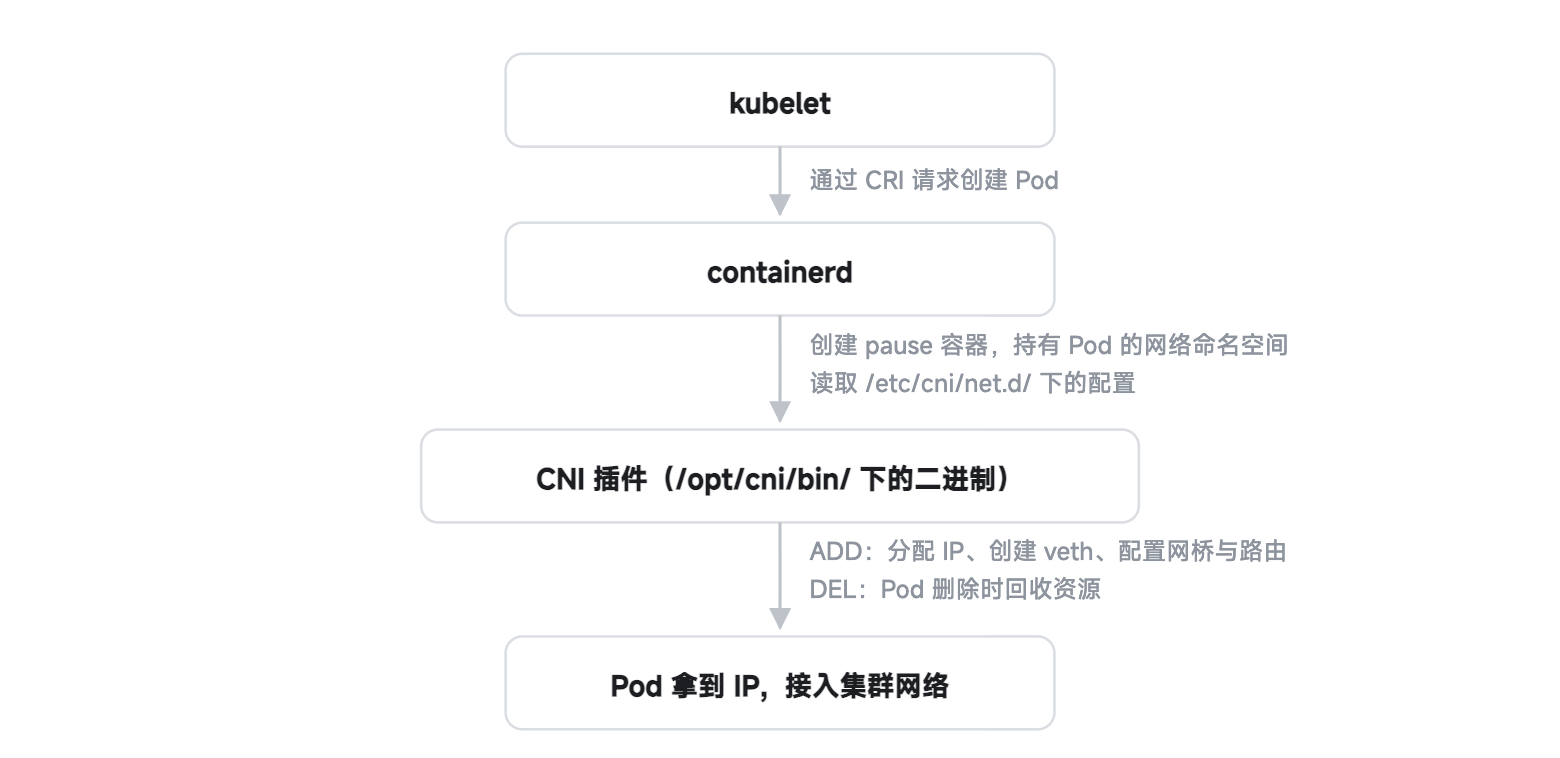
kubelet 不直接配网,它只是「在创建和删除 Pod 时调用 CNI 插件」。所以排查 Pod 拿不到 IP 的问题,先去节点上看 /etc/cni/net.d/ 有没有配置、CNI 插件的 Pod(DaemonSet)健不健康。
Flannel
Flannel 是最老牌、最简单的 CNI 插件,定位非常明确:把网络打通,别的都不管。
它的默认后端是 VXLAN 覆盖网络,原理一句话:把 Pod 发出的报文整个封装进 UDP 包(4789 端口),借宿主机的三层网络运到对端节点,再拆封还原——只要节点之间三层可达,Pod 网络就能通,对底层网络几乎零要求。
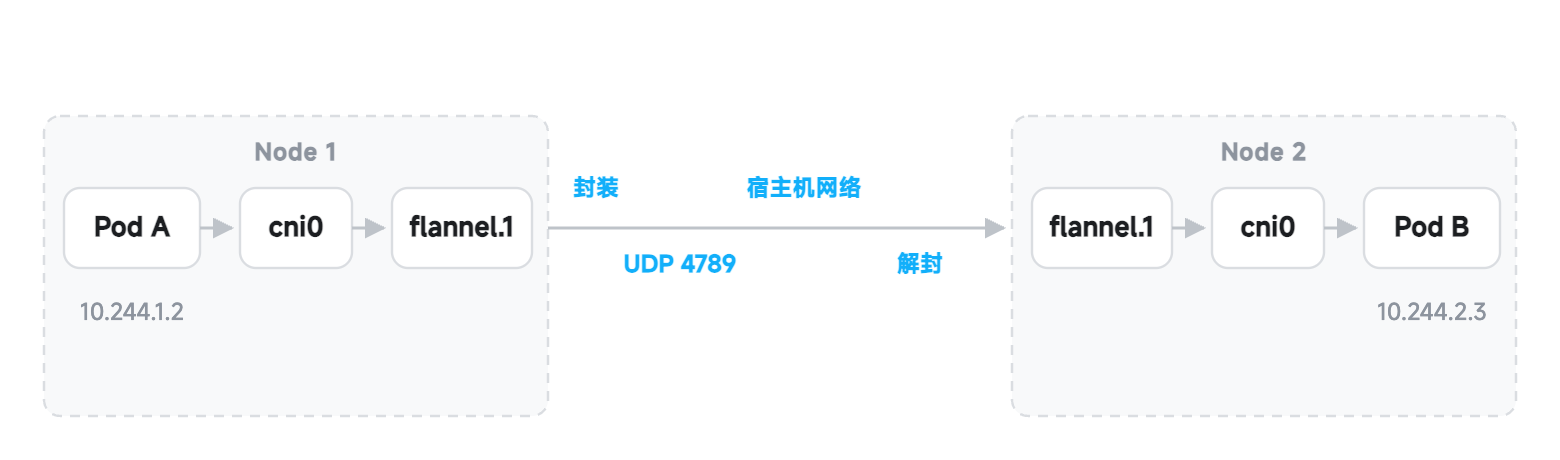
部署就是一条命令:
kubectl apply -f https://github.com/flannel-io/flannel/releases/latest/download/kube-flannel.yml
代价也很直白:
- 功能少:不支持 NetworkPolicy,没有任何流量治理能力。
- 有开销:VXLAN 封包拆包要消耗 CPU,报文还要多出 50 字节头部。
Flannel 还有个 host-gw 后端:不封包,直接在宿主机上写「目标 Pod 网段 → 对端节点 IP」的路由。性能接近 Calico,但要求所有节点在同一个二层网络里,云上基本用不了,了解一下即可。
Calico
Calico 的思路和 Flannel 完全不同:不封包,把集群当成纯三层网络来路由。
每个节点上的 Calico 组件(Felix + BIRD)通过 BGP 协议互相通告「我这台节点上有哪个 Pod 网段」,于是每台宿主机都有完整的 Pod 路由表,Pod 报文不经过任何封装,直接按路由转发,性能接近物理网络。
Calico 的另外两个招牌能力:
- 完整支持 NetworkPolicy:K8s 的 NetworkPolicy 资源本身只是一份声明,需要 CNI 插件来执行,Calico 是最早、最常用的实现者,还提供自己扩展的 GlobalNetworkPolicy。
- IPIP / VXLAN 模式可选:BGP 要求节点间三层可达,跨网段(比如云上跨 VPC)时可以打开 IPIP 或 VXLAN 封包模式,还能按子网混合使用,非常灵活。
Calico 的 BGP 是节点之间自建的私有对等关系,不需要机房交换机支持 BGP,也不用你手工维护邻居配置——装好它自己就跑起来了。
Cilium
Cilium 是新一代 CNI 的代表,核心卖点是用 eBPF 做数据面:不再依赖 iptables 规则链,而是在内核里挂载 eBPF 程序,转发、负载均衡、策略判断全部在内核中一次完成。
三大特征:
- eBPF 数据面:绕过 iptables 长链,Service 数量再大也不掉性能(eBPF 的细节后面专门有一节)。
- 可替代 kube-proxy:Service 的负载均衡也由 eBPF 实现,集群里可以不装 kube-proxy。
- Hubble 可观测:基于 eBPF 事件天生就能看到每一条流量,提供服务依赖图、流量日志、丢包可视化,开箱即用。
网络策略方面,Cilium 在支持 K8s NetworkPolicy 之外还能做到 L7 层(比如「只允许 GET /api 这个路径」),这是 iptables 系方案做不到的。
三种主流 CNI 的对比:
| 对比项 | Flannel | Calico | Cilium |
|---|---|---|---|
| 数据面 | VXLAN 覆盖网络(另有 host-gw) | BGP 纯三层路由(可选 IPIP/VXLAN 封包) | eBPF 内核程序 |
| 部署难度 | 最简单,一条命令 | 中等 | 中等偏上 |
| NetworkPolicy | 不支持 | 支持 | 支持,可扩展到 L7 |
| 性能 | 一般(封包有开销) | 好(不封包时接近物理网络) | 好,大规模下优势明显 |
| 可观测性 | 无 | 一般 | Hubble,开箱即用 |
| 能否替代 kube-proxy | 否 | 否 | 可以 |
| 适合场景 | 入门、小规模集群 | 生产主流、需要网络策略 | 大规模、重性能与可观测 |
学习或小规模集群用 Flannel 最省事;要用 NetworkPolicy 就选 Calico,它是生产环境的老牌稳妥方案;集群规模大、看重性能和可观测性,或者干脆想去掉 kube-proxy,选 Cilium——这也是目前社区新建集群的主流风向。
kube-proxy
先划清边界:kube-proxy 只负责 Service 转发,不管 Pod 网络。
它的职责是:watch API Server 里 Service 和 Endpoint 的变化,然后在每个节点上维护转发规则,让「访问 ClusterIP / NodePort」的流量能被送到后端 Pod 上。至于 Pod 和 Pod 之间通不通,那是 CNI 的事,和 kube-proxy 无关。
kube-proxy 的转发实现经历了三代演进:
| 模式 | 工作方式 | 优点 | 缺点 | 现状 |
|---|---|---|---|---|
| userspace | kube-proxy 自己监听端口,在用户态做反向代理 | 实现简单 | 流量在内核态和用户态之间来回拷贝,性能差 | 早已淘汰 |
| iptables | kube-proxy 只写 iptables DNAT 规则,转发在内核态完成 | 无用户态拷贝,够快 | 规则随 Service 数量线性增长,大规模变慢 | 目前默认 |
| ipvs | 把转发交给内核 IPVS 模块 | 哈希表查找 O(1),调度算法丰富 | 节点需加载 ipvs 内核模块 | 大规模推荐 |
遇到「Pod 互 ping 不通」就去翻 kube-proxy 日志,是新手常走的弯路——Pod 直连流量根本不经过 kube-proxy。只有访问 Service IP 不通时,才轮到 kube-proxy 登场。
iptables
iptables 模式下,kube-proxy 为每个 Service 生成一组规则链,一次 ClusterIP 访问的 DNAT 流程是:
- 报文先进入
KUBE-SERVICES链,按「目的 IP + 端口」匹配到对应 Service 的KUBE-SVC-xxx链。 KUBE-SVC-xxx链里有若干条KUBE-SEP-yyy规则(每个后端 Pod 一条),用 statistic 模块按概率随机挑一条跳转。KUBE-SEP-yyy链执行 DNAT,把目的地址改写成后端 Pod 的 IP 和端口。
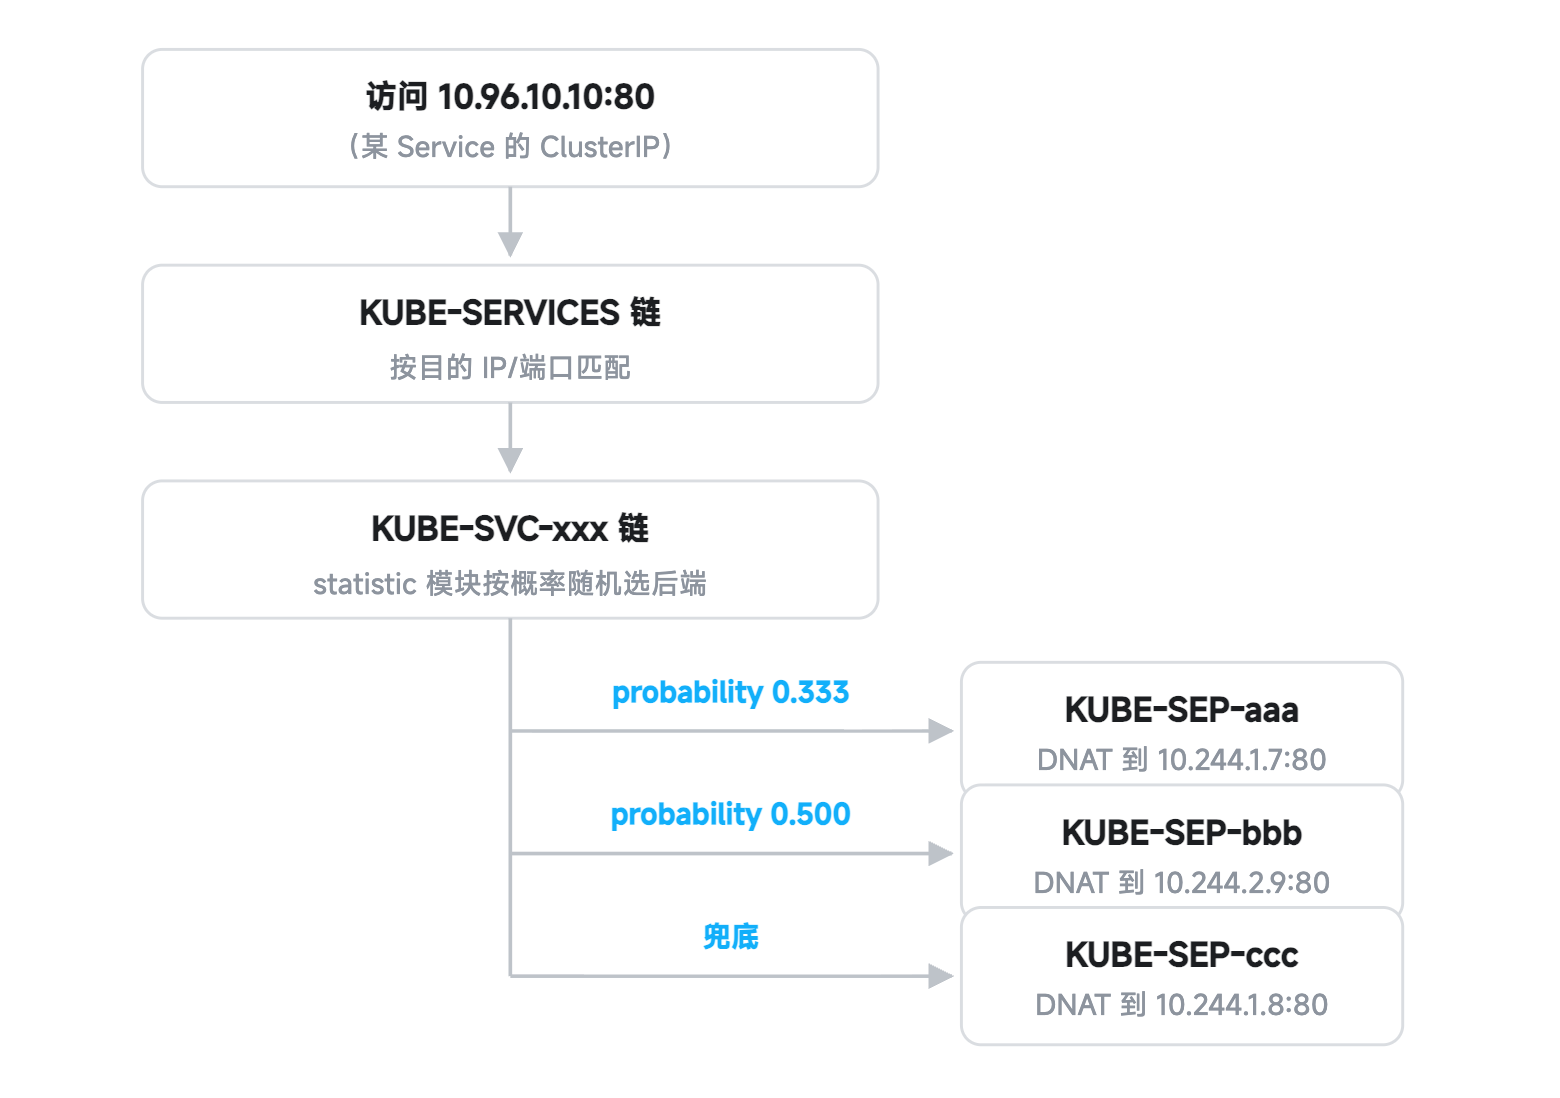
在节点上可以直接查看这些规则:
# 查看所有 Service 的入口规则
iptables -t nat -L KUBE-SERVICES

# 查看某个 Service 的后端分配(链名从上面的输出里找)
iptables -t nat -L KUBE-SVC-JD5MR3NA4I4DYORP
Chain KUBE-SVC-JD5MR3NA4I4DYORP (1 references)
target        prot opt source     destination
KUBE-SEP-AAAA  all  --  anywhere   anywhere   statistic mode random probability 0.33333333349
KUBE-SEP-BBBB  all  --  anywhere   anywhere   statistic mode random probability 0.50000000000
KUBE-SEP-CCCC  all  --  anywhere   anywhere   /* default/web */
两个要点:
- 这里的负载均衡是随机 + 概率,不是轮询;规则自上而下顺序匹配,所以概率依次写成 1/3、1/2、1(兜底),数学上才是均匀分配。
- 规则数量约等于「Service 数 × 后端数」,每个报文都要沿链顺序匹配。Service 上到几千条后,转发变慢、规则更新也慢——这正是 IPVS 模式要解决的问题。
这些链由 kube-proxy 全权维护,手动插入或修改的规则很快会被它刷掉。想调整行为,应该改 kube-proxy 的配置,而不是改 iptables。
IPVS
IPVS(IP Virtual Server)是内核自带的四层负载均衡模块(也就是 LVS 的内核部分)。kube-proxy 切到 IPVS 模式后,不再铺一串串 iptables 链,而是把「Service → 后端」的映射写进 IPVS 的哈希表——查找复杂度 O(1),和 Service 数量彻底脱钩。
它还提供多种真实的调度算法(通过 --ipvs-scheduler 指定):
| 算法 | 含义 | 适用场景 |
|---|---|---|
rr | 轮询(默认) | 大多数场景 |
lc | 最少连接,新请求发给连接数最少的后端 | 长连接、后端性能不均 |
sh | 源地址哈希,同一客户端固定到同一后端 | 需要会话保持 |
dh / sed / nq | 目的哈希 / 最短期望延迟 / 不排队 | 特殊场景,了解即可 |
切换方法(kubeadm 部署的集群):
kubectl edit configmap kube-proxy -n kube-system
在 data.config.conf 里把模式改掉:
data:
  config.conf: |
    apiVersion: kubeproxy.config.k8s.io/v1alpha1
    kind: KubeProxyConfiguration
    mode: "ipvs"          # 默认是 iptables
    ipvs:
      scheduler: "rr"
重启生效并验证:
kubectl rollout restart daemonset kube-proxy -n kube-system
ipvsadm -Ln    # 能看到 Service IP 与后端的映射,即切换成功
前提是节点已加载 ip_vs、ip_vs_rr 等内核模块,并安装 ipvsadm 方便观察(多数现代发行版开箱即用,也可以 modprobe ip_vs 手动加载)。
Service 数量到几百上千、或者感到 Service 访问延迟随规模上涨时,就该切 IPVS。小集群用默认的 iptables 模式完全够,不必为新而新。
eBPF
eBPF 是 Linux 内核内置的一套可编程沙箱:不用改内核源码、不用加载内核模块,就能把一段经过验证器安全检查的小程序,挂到内核的各种事件点(网卡收发包、系统调用、函数入口……)上执行。
它在云原生圈火起来,主要靠两点:
- 可编程内核:数据面逻辑直接写在内核事件点上,既有内核级的性能,又有接近用户态的开发效率;内核版本够新就能用,不用换内核。
- 绕过 iptables 长链:转发、负载均衡、策略判断全部用 eBPF map(内核里的哈希表)完成,O(1) 查找,没有链式遍历——Service 规模再大性能也稳。
顺带的好处是天生可观测:程序就挂在事件现场,流量、丢包、延迟顺手就能统计导出。
在 Cilium 里,eBPF 几乎包办了所有事:
- Pod 间转发和 NetworkPolicy 执行,由挂在网卡上的 eBPF 程序完成;
- Service 负载均衡也走 eBPF,所以能整个替代 kube-proxy;
- Hubble 直接消费 eBPF 事件,输出服务依赖图和流量日志。
eBPF 是内核的通用能力:安全领域有 Falco、Tetragon,性能分析有 bcc、bpftrace。Cilium 只是把它在网络方向的用法做到了极致,顺带带火了整个生态。
Service Mesh(简介)
Service Mesh 解决的是「服务间通信治理」问题:把负载均衡、重试、熔断、mTLS 加密、灰度发布、调用链观测这些公共能力,从业务代码里剥离出来,统一下沉到基础设施层。
做法是给每个 Pod 注入一个 Sidecar 代理(最常用 Envoy):Pod 的进出流量先经过 sidecar,由它执行各种治理策略,业务进程完全无感知。所有 sidecar 由一个控制平面统一管理和下发配置。
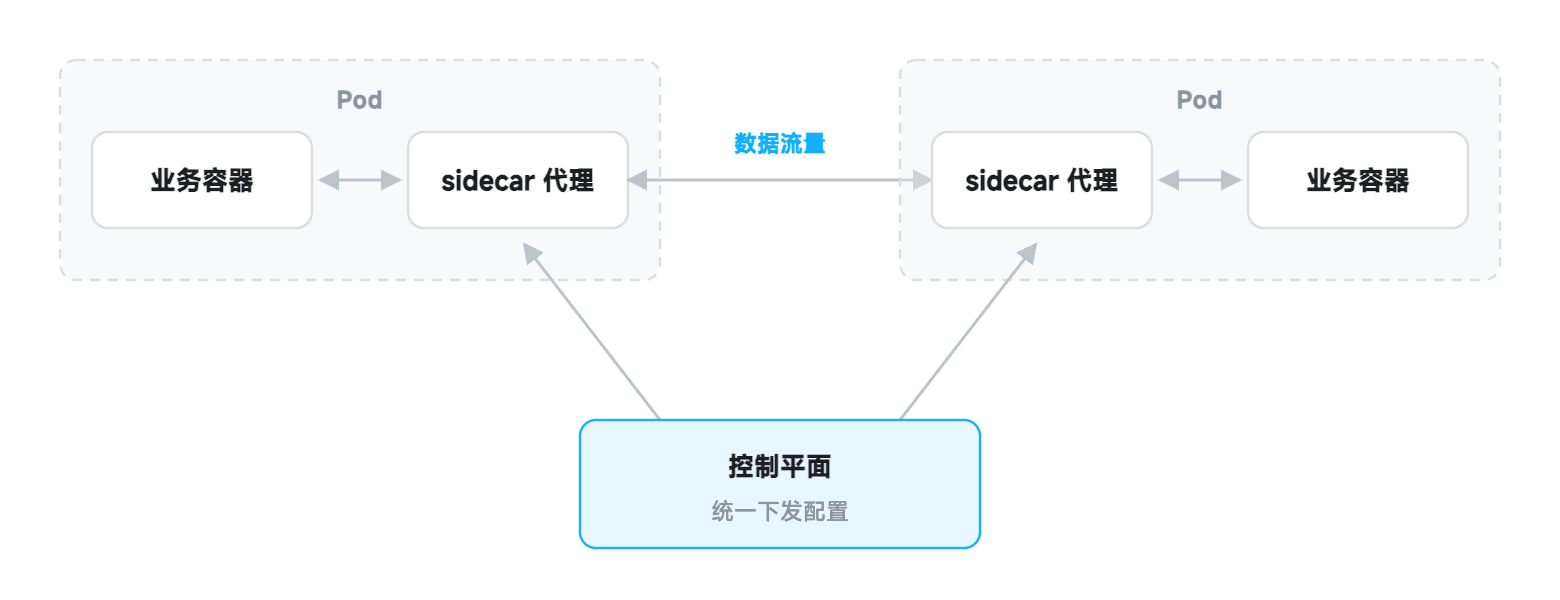
两个代表项目:
- Istio:功能最全,Envoy sidecar + 强大的控制平面,流量治理细到 API 级别,学习和运维成本也最高。
- Linkerd:sidecar 用 Rust 实现,主打轻量、简单、资源占用低。
什么时候不需要它:
- 服务数量不多(几个到十几个),Ingress + Service 就能管好,没必要再叠一层。
- 只需要其中一两项能力(比如只要 mTLS,或只要灰度发布),有更轻量的专项方案。
- 团队没有余力维护多一层基础设施——每个 Pod 多跑一个代理,CPU、内存、排障复杂度的上涨都是实打实的。
Mesh 治理的是「几十上百个微服务互相调用」的场面;服务规模没到那个量级,它带来的复杂度往往超过收益。
网络排障
K8s 网络问题看着玄,但按「从近到远、从 Pod 到 Service 再到插件」的顺序排,绝大多数都能定位。下面是一套可以直接照做的流程。
1. 先查 DNS 解析
进 Pod 里解析服务名和集群内置域名:
kubectl exec -it <pod名> -- nslookup <服务名>
kubectl exec -it <pod名> -- nslookup kubernetes.default
解析失败就去查 CoreDNS:
kubectl -n kube-system get pods -l k8s-app=kube-dns
kubectl -n kube-system logs -l k8s-app=kube-dns --tail=50
2. 测 Pod 到 Pod 连通性
先看 Pod 都分布在哪些节点、IP 是什么:
kubectl get pods -o wide
分别挑同节点和跨节点的 Pod 互测:
kubectl exec -it <pod名> -- ping -c 3 <对端Pod IP>
- 同节点通、跨节点不通 → 问题大概率在 CNI 或底层网络:路由缺失、VXLAN 不通、云安全组没放行。
- 同节点也不通 → 节点本地网络栈或 CNI agent 出问题,看第 4 步。
3. 测 Service 转发
kubectl get svc <服务名>
kubectl get endpoints <服务名>
curl <ClusterIP>:<端口>
- endpoints 为空是最常见的情况:Service 的 selector 和 Pod 的 label 对不上,或者 Pod 还没 Ready。用
kubectl describe svc <服务名>对比两边标签即可。 - endpoints 正常但 ClusterIP 不通 → 查 kube-proxy:
kubectl -n kube-system logs -l k8s-app=kube-proxy --tail=50
4. 看 CNI 组件是否健康
CNI 插件以 DaemonSet 形式跑在每个节点上,它出问题时症状往往很「玄学」(时通时断、部分节点不通):
kubectl -n kube-system get pods -o wide | grep -E 'calico|flannel|cilium'
有 Pod 处于 CrashLoopBackOff 或频繁重启,就先翻它的日志;也可以对比各节点上插件 Pod 的状态,看问题是不是集中在某台节点。
5. 检查 NetworkPolicy 是否误伤
kubectl get networkpolicy -A
kubectl describe networkpolicy <名称> -n <命名空间>
NetworkPolicy 是白名单语义:一旦某个 Pod 被任何一条策略选中,没被明确放行的流量就全部被拒。排障时可以先把可疑策略临时删掉验证,定位后再加回来并补齐放行规则。
6. 排查 MTU 不匹配
这是最隐蔽的一类:小包通、大包丢,表现为 TCP 能握手但传数据就卡死。
原因在封装开销:VXLAN 头部占 50 字节,所以 Flannel 默认把 Pod 网络的 MTU 设为 1450(1500 - 50)。云上环境尤其容易踩坑:
- 有的云 VPC 宿主机 MTU 是 1450,再叠一层 VXLAN 就只剩 1400;
- 有的云内网开巨帧(MTU 9000),CNI 没跟着调,报文封装后超出路径 MTU,被中间设备静默丢弃。
验证方法:
# 查看各网卡 MTU(在节点和 Pod 里都可以执行)
ip link

# 用「禁止分片」的 ping 探测路径最大 MTU
ping -M do -s 1472 <对端IP>    # 1472 + 28(包头) = 1500
ping -M do -s 8972 <对端IP>    # 巨帧环境
哪一档开始不通,说明路径 MTU 就在那之下。修复方式是把 CNI 的 MTU 调成「宿主机 MTU - 封装开销」(VXLAN 减 50,IPIP 减 20)。
各家云、各种网络互联方式(VPC 对等、专线、混合云)的 MTU 都不一样。装 CNI 之前先用上面的 ping 方法实测一遍路径 MTU,比事后抓包定位省事得多。
走完这六步还定位不了的话,再祭出终极大法:在节点上抓包(tcpdump),看报文到底走到了哪一跳、在哪一跳消失——但绝大多数问题,其实都倒在前六步里了。