配置与安全
前面几篇解决了「应用怎么跑起来、怎么暴露服务、数据怎么存」,这篇讲剩下的两件大事:配置怎么管、安全怎么搞。前半部分的 ConfigMap 和 Secret 负责把配置从镜像里剥离出来,后半部分从 ServiceAccount、RBAC 一路讲到准入控制和多租户——内容有点多,但都是生产集群绕不开的基本功。
ConfigMap
ConfigMap 用来把非敏感的配置数据以键值对的形式存进集群,Pod 启动时再注入进去。这样同一个镜像可以在开发、测试、生产环境挂不同的配置,不用为每个环境单独打镜像。
ConfigMap 只适合放不敏感的配置:数据库地址、日志级别、特性开关之类。密码、Token 这类敏感信息要交给下一节的 Secret。另外单个 ConfigMap 大小上限是 1 MiB,别拿它当文件仓库用。
三种创建方式
方式一:命令行字面量,适合临时塞几个键值对:
kubectl create configmap app-config \
  --from-literal=LOG_LEVEL=debug \
  --from-literal=DB_HOST=mysql.default.svc.cluster.local
方式二:从文件创建,适合现成的配置文件,键默认取文件名:
# 键为文件名 nginx.conf,值为整个文件内容
kubectl create configmap nginx-conf --from-file=nginx.conf

# 也可以自定义键名
kubectl create configmap nginx-conf --from-file=my-key=nginx.conf
方式三:YAML 声明式创建,能纳入 Git 管理,是生产环境推荐的方式:
apiVersion: v1
kind: ConfigMap
metadata:
  name: app-config
data:
  LOG_LEVEL: debug
  DB_HOST: mysql.default.svc.cluster.local
  app.properties: |
    server.port=8080
    spring.profiles.active=prod
data 下的值都是字符串,多行配置用 | 块标量保留换行。kubectl apply -f 提交后,可以用 kubectl get cm app-config -o yaml 回查内容。
两种消费方式
方式一:环境变量注入。用 envFrom 把 ConfigMap 里所有键一次性灌进容器环境变量:
apiVersion: v1
kind: Pod
metadata:
  name: app-env
spec:
  containers:
    - name: app
      image: busybox:1.36
      command: ["sh", "-c", "env | grep -E 'LOG_LEVEL|DB_HOST'"]
      envFrom:
        - configMapRef:
            name: app-config
只想取单个键的话,用 env 搭配 configMapKeyRef:
      env:
        - name: LOG_LEVEL
          valueFrom:
            configMapKeyRef:
              name: app-config
              key: LOG_LEVEL
方式二:Volume 挂载。把每个键变成挂载目录下的一个文件:
apiVersion: v1
kind: Pod
metadata:
  name: app-volume
spec:
  containers:
    - name: app
      image: busybox:1.36
      command: ["sh", "-c", "cat /etc/config/app.properties"]
      volumeMounts:
        - name: config
          mountPath: /etc/config
  volumes:
    - name: config
      configMap:
        name: app-config
两种方式的对比如下:
| 对比项 | 环境变量 | Volume 挂载 |
|---|---|---|
| 注入形式 | 键值对变成环境变量 | 每个键变成挂载目录下的一个文件 |
| 更新后是否同步进容器 | 不同步,启动那一刻就固定了 | kubelet 会定期同步(有几十秒级延迟) |
| 适合场景 | 少量、简单的开关型配置 | 整份配置文件、需要热更新的配置 |
更新 ConfigMap 不会重建 Pod
这是新手最常踩的坑:改了 ConfigMap,Pod 不会自动重建。
- 用环境变量注入的配置:容器启动那一刻就定死了,之后改 ConfigMap 毫无效果,必须重建 Pod。
- 用 Volume 挂载的配置:kubelet 会异步把新内容同步进容器(默认同步周期加上缓存,可能延迟一两分钟),但应用得自己重新读文件才生效,而多数应用启动时读一次就不管了。
所以最常见的做法是改完配置手动滚一次:
kubectl rollout restart deployment/my-app
更优雅的办法是把 ConfigMap 内容的哈希写进 Pod 模板注解(Helm 里常见的 checksum/config 注解就是这个思路),内容一变 Pod 模板就跟着变,滚动更新自动触发。
immutable:不可变 ConfigMap
Kubernetes 1.21 起可以给 ConfigMap 加 immutable: true,把它彻底钉死:
apiVersion: v1
kind: ConfigMap
metadata:
  name: app-config-v1
immutable: true
data:
  LOG_LEVEL: debug
钉死之后任何修改都会被拒绝,想改配置只能新建一个 ConfigMap(名字带上版本后缀)再让工作负载换引用。好处有两个:一是防止误改配置酿成线上事故;二是 kubelet 不用再 watch 它,集群里 ConfigMap 很多时能明显减轻 API Server 的压力。
Secret
Secret 和 ConfigMap 用法几乎一样,区别是它专门存敏感信息:密码、Token、TLS 证书、镜像仓库凭据等。结构上同样是键值对,只是 data 里的值要求是 base64 编码后的字符串。
三种常用类型
Secret 的 type 字段决定用途和必填的键:
| type | 用途 | 关键字段 |
|---|---|---|
| Opaque | 通用类型,任意键值对(默认值) | 自定义 |
| kubernetes.io/tls | 存 TLS 证书和私钥 | tls.crt、tls.key |
| kubernetes.io/dockerconfigjson | 存镜像仓库登录凭据 | .dockerconfigjson |
对应的创建命令:
# 通用 Secret
kubectl create secret generic db-secret \
  --from-literal=username=admin \
  --from-literal=password='S3cret!'

# TLS Secret
kubectl create secret tls web-tls --cert=tls.crt --key=tls.key

# 镜像仓库凭据
kubectl create secret docker-registry regcred \
  --docker-server=registry.example.com \
  --docker-username=bot \
  --docker-password='S3cret!'
stringData:免去手工 base64
写 YAML 时用 stringData 字段可以直接填明文,API Server 写入时会自动转成 base64 存进 data,之后 stringData 字段本身消失:
apiVersion: v1
kind: Secret
metadata:
  name: db-secret
type: Opaque
stringData:
  username: admin
  password: S3cret!
回查时 data 里是编码后的值,一条 echo 'xxxx' | base64 -d 就能解出明文。Secret 的消费方式和 ConfigMap 完全一致——envFrom、secretKeyRef、Volume 挂载,这里不再重复。
这一点必须划重点:base64 不是加密,是编码,任何人拿到 data 里的值,一条命令就能还原明文。Secret 的「安全」体现在别的地方:API 层可以用 RBAC 做更细的权限管控、etcd 可以配静态加密、Secret 只被分发到需要它的 Pod 所在节点、容器内以 tmpfs 内存文件系统挂载不落盘。
所以别把「用了 Secret」当成安全终点:集群里能 list secrets 的人等于拿到了所有明文,etcd 磁盘被人拷走也等于全部泄露。真正的防护要靠 RBAC 收敛权限、下面讲的 etcd 静态加密,必要时再接外部密钥管理系统(Vault、云厂商 KMS)。
etcd 静态加密(Encryption at Rest)
默认情况下 Secret 只是 base64 编码后明文躺在 etcd 里。Kubernetes 提供了 Encryption at Rest 机制:给 API Server 配一份加密配置,数据写进 etcd 之前先在内存里加密,读出时再解密。
# /etc/kubernetes/encryption.yaml
apiVersion: apiserver.config.k8s.io/v1
kind: EncryptionConfiguration
resources:
  - resources:
      - secrets
    providers:
      - aescbc:
          keys:
            - name: key1
              secret: <base64 编码的 32 字节密钥>
      - identity: {}
然后在 API Server 启动参数里挂上它并重启:
--encryption-provider-config=/etc/kubernetes/encryption.yaml
几个要点:
- providers 按顺序尝试解密,但加密永远用第一个。轮换密钥时把新密钥放最前面,旧密钥留在后面解密存量数据,全部重写后再删掉旧的。
identity提供者是「不加密」,放在最后兜底,保证迁移期间旧的明文数据还能读。- 生产环境更推荐
kms提供者,对接云厂商 KMS 或 Vault,密钥不出密钥管理系统,比静态写死的aescbc密钥更稳。 - 配置生效后,已存在的 Secret 还是明文,需要执行
kubectl get secrets --all-namespaces -o json | kubectl replace -f -全部重写一遍,触发加密落盘。
ServiceAccount
前面讲的是「人怎么管集群」——kubectl 用 kubeconfig 里的用户身份。ServiceAccount(简称 SA)解决的是另一个问题:Pod 里的程序访问 API Server 时用什么身份。比如应用要列出同 namespace 的 Pod、CI 容器要 apply 资源,都得有一个集群内部身份。
每个 namespace 创建时自带一个 default SA,Pod 不指定 serviceAccountName 就用它:
apiVersion: v1
kind: Pod
metadata:
  name: sa-demo
spec:
  serviceAccountName: my-sa   # 不指定则为 default
  containers:
    - name: app
      image: nginx:1.27
Token 自动挂载
只要 Pod 关联了 SA,kubelet 会自动把一份访问 API Server 的凭据投射进容器:
/var/run/secrets/kubernetes.io/serviceaccount/
├── ca.crt        # 集群 CA 证书,用于验证 API Server
├── namespace     # 当前所在 namespace
└── token         # 调用 API 的 Bearer Token
1.24 之前这份 Token 是以 Secret 形式永久存在的(不过期、一直有效),泄露风险很大;1.24 起改为通过 TokenRequest API 签发有时效、绑定 Pod 的临时 Token,由 kubelet 定期轮换,安全性好了很多。测试时也可以用 kubectl create token my-sa 手动申请一个短时 Token。
加固:关掉自动挂载
绝大多数业务 Pod 根本不需要访问 API Server,挂着 Token 等于白送攻击者一把钥匙。按最小权限原则,建议默认关掉:
apiVersion: v1
kind: Pod
metadata:
  name: no-token
spec:
  automountServiceAccountToken: false
  containers:
    - name: app
      image: nginx:1.27
也可以在 SA 层面设置,影响所有使用它的 Pod:
apiVersion: v1
kind: ServiceAccount
metadata:
  name: default
automountServiceAccountToken: false
真正需要访问 API 的 Pod(比如各类控制器),再单独建 SA、按需授权——授权方式就是下一节的 RBAC。
RBAC
RBAC(Role-Based Access Control,基于角色的访问控制)是 Kubernetes 主流的鉴权方式,回答的问题是:谁(Subject)能对什么资源(Resource)做什么操作(Verb)。kubeadm、kind 等主流安装方式默认都启用了它(API Server 参数 --authorization-mode=RBAC)。
四件套的关系
RBAC 就四个对象:两个负责「定义权限」,两个负责「绑定权限」。
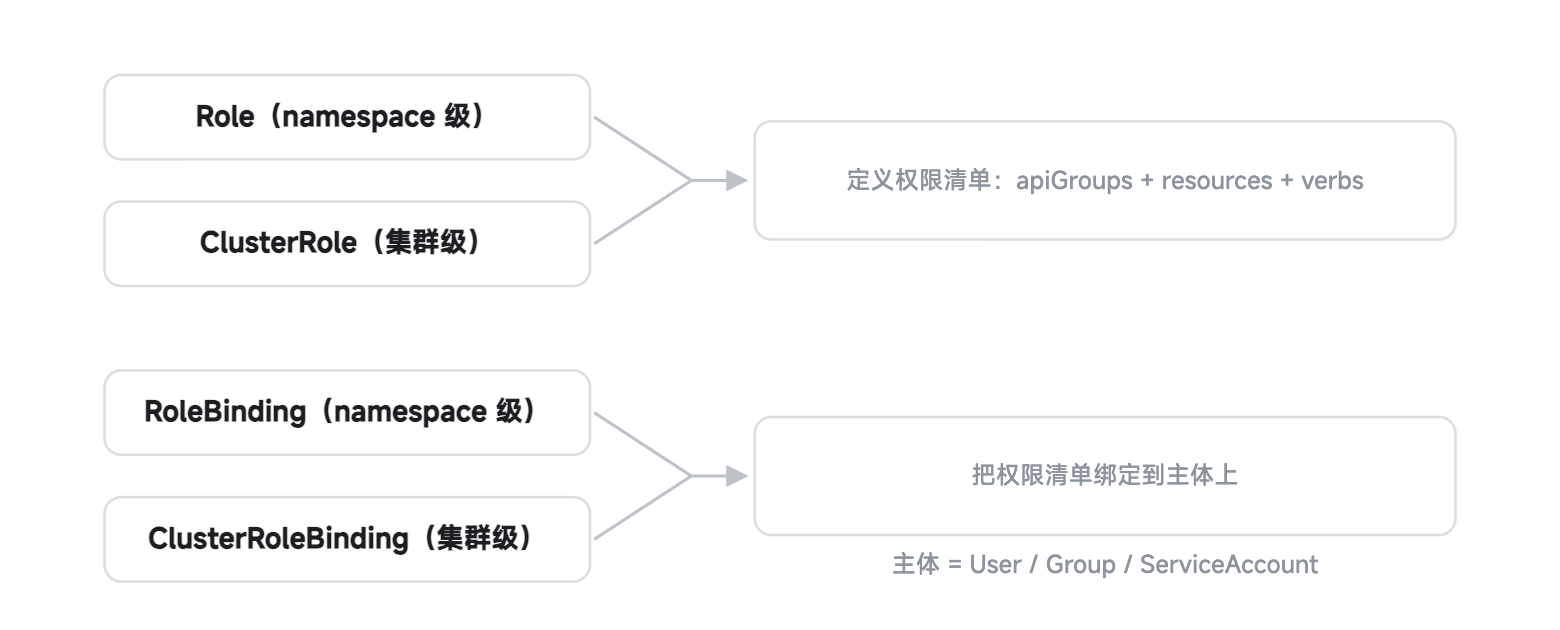
| 对象 | 作用范围 | 说明 |
|---|---|---|
| Role | 单个 namespace | 定义该 namespace 内的权限清单 |
| ClusterRole | 整个集群 | 定义集群级资源(nodes、pv 等)或可复用的权限模板 |
| RoleBinding | 单个 namespace | 把 Role(或 ClusterRole)授予主体,只在该 namespace 生效 |
| ClusterRoleBinding | 整个集群 | 把 ClusterRole 授予主体,集群范围生效 |
常见的三种组合:
- Role + RoleBinding:授予某 namespace 内权限,最常见的用法。
- ClusterRole + RoleBinding:权限只在某个 namespace 生效,但清单复用集群级模板,比如内置的
view、edit。 - ClusterRole + ClusterRoleBinding:授予整个集群的权限,威力最大,要格外谨慎。
权限怎么写:apiGroups、resources、verbs
Role 的核心是 rules 列表,每条规则三个要素:
apiGroups:资源所属的 API 组。核心组(pods、services、configmaps、secrets 等)写空字符串"";deployments、statefulsets 属于"apps";ingresses 属于"networking.k8s.io"。resources:资源名,全小写复数,如pods、deployments。可以精确到子资源,如pods/log。verbs:允许的动作,常见有get、list、watch、create、update、patch、delete。写["*"]表示全部,慎用。
拿不准某个资源属于哪个组、支持哪些动词时,直接查:
kubectl api-resources -o wide
输出里的 APIGROUP 和 VERBS 两列就是答案。
完整示例:给 SA 授 namespace 内只读
目标:在 demo namespace 里建一个 SA,只允许它查看该 namespace 下的 Pod,别的什么都不让做。
# 1. 建 namespace 和 ServiceAccount
apiVersion: v1
kind: Namespace
metadata:
  name: demo
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: pod-reader
  namespace: demo
---
# 2. 定义权限:只能读 Pod
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  name: pod-reader
  namespace: demo
rules:
  - apiGroups: [""]
    resources: ["pods"]
    verbs: ["get", "list", "watch"]
---
# 3. 绑定:把 Role 授给 SA
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: read-pods
  namespace: demo
subjects:
  - kind: ServiceAccount
    name: pod-reader
    namespace: demo
roleRef:
  kind: Role
  name: pod-reader
  apiGroup: rbac.authorization.k8s.io
roleRef 指向权限清单,subjects 列出被授予的对象(可以一次写多个)。注意 roleRef 创建后不可修改,想换权限只能删掉 Binding 重建。
用 kubectl auth can-i 验证
授权写得对不对,别靠猜,直接问 API Server:
kubectl auth can-i list pods --as=system:serviceaccount:demo:pod-reader -n demo
kubectl auth can-i delete pods --as=system:serviceaccount:demo:pod-reader -n demo
yes
no
--as 用来模拟某个身份——SA 的完整用户名是 system:serviceaccount: 加上 namespace 和名字,管理员排查权限问题全靠它。换 namespace 或加 -A 参数,还能对比不同范围下的结果。
Admission Controller
一个请求打到 API Server,完整链路是这样的:
请求 → 认证(你是谁)→ 鉴权(你能不能做,如 RBAC)→ 准入控制(请求合不合规矩、要不要改写)→ 校验 → 写入 etcd
准入控制器(Admission Controller)是写库前的最后一道关卡:RBAC 说「你有权创建 Pod」,准入控制还可以进一步说「但你这个 Pod 没写资源限额,拒绝」,或者「我帮你补上默认的 storageClassName」。
Mutating vs Validating
准入控制器分两型,执行顺序是先改后验:
| 类型 | 能否修改请求对象 | 典型用途 |
|---|---|---|
| Mutating(变更型) | 能 | 注入默认值、自动加 Sidecar、改写字段 |
| Validating(校验型) | 不能,只能放行或拒绝 | 强制规范、校验字段合法性 |
先跑完所有 Mutating(此时对象可能已被改写),再跑 Validating 对最终结果做校验。任何一个环节拒绝,整个请求就失败。
常用内置准入控制器
API Server 自带三十多个准入控制器,常见安装默认启用了一批,最常用的几个:
| 准入控制器 | 作用 |
|---|---|
| NamespaceLifecycle | 拒绝在不存在的 namespace 里建资源,防止误删正在使用的 namespace |
| ServiceAccount | 自动给 Pod 关联默认 SA 并投射 Token |
| LimitRanger | 配合 LimitRange 对象,给没写 requests/limits 的容器补默认值,并检查是否超限 |
| ResourceQuota | 配合 ResourceQuota 对象,检查 namespace 配额,超了拒绝 |
| PodSecurity | 即下一节要讲的 Pod Security Admission,按安全级别校验 Pod |
查看当前启用了哪些(kubeadm 集群可以直接看静态 Pod 清单的启动参数):
grep admission /etc/kubernetes/manifests/kube-apiserver.yaml
Webhook 扩展
内置控制器不够用,也不用改 API Server 代码:通过 MutatingAdmissionWebhook 或 ValidatingAdmissionWebhook,把请求转发给自己写的 HTTP 服务做改写或校验即可——Istio 的 Sidecar 自动注入、各公司的「强制打标签」策略都是这么做的。知道有这条路就行,真落地时一般直接用成熟的策略引擎(如 Kyverno、OPA Gatekeeper),不必手写 Webhook 服务。
Pod Security
PSP 已废弃
老资料里经常出现 PodSecurityPolicy(PSP):一套功能强大但极其难用的集群级 Pod 安全策略。官方在 1.21 将它标记废弃,1.25 已彻底移除。再看到 PSP 相关的内容,直接跳过,别学。
Pod Security Admission
PSP 的接班人是内置的 Pod Security Admission(PSA),思路从「灵活的复杂策略」换成「三档固定级别」,开箱即用:
| 级别 | 严格程度 | 大致要求 |
|---|---|---|
| privileged | 最宽松 | 不限制,任何东西都能跑 |
| baseline | 适中 | 禁止提权、hostNetwork、hostPID、hostPath 等明显危险的配置,日常业务够用 |
| restricted | 最严格 | 在 baseline 之上再要求 runAsNonRoot、禁 capabilities、seccomp 等,对应完整的安全加固标准 |
启用方式是给 namespace 打 label,三种模式可以叠加:
kubectl label namespace demo \
  pod-security.kubernetes.io/enforce=baseline \
  pod-security.kubernetes.io/warn=restricted \
  pod-security.kubernetes.io/audit=restricted
三种模式的分工:
enforce:违反就拒绝创建,真正干活的模式。warn:放行但给客户端返回警告(kubectl 输出里能看到),适合灰度期观察。audit:放行并记进审计日志,事后追溯用。
别一上来就 enforce=restricted,存量业务大概率起不来。正确节奏:先挂 warn 和 audit 观察一段时间,把违规的 workload 改干净,最后再切 enforce。label 还可以带版本后缀(如 enforce-version: v1.31)钉住检查标准,避免集群升级后规则悄悄变严。
NetworkPolicy
默认情况下 Kubernetes 里所有 Pod 之间互通,任何一个 Pod 被攻破,攻击者就能在集群内横向移动。NetworkPolicy 是 K8s 提供的 L3/L4 网络防火墙:按 Pod 维度声明「谁能访问我、我能访问谁」。
NetworkPolicy 只是一份声明,真正执行它的是 CNI 网络插件。常见插件的支持情况:
| CNI 插件 | 支持 NetworkPolicy |
|---|---|
| Calico | ✅ 完整支持 |
| Cilium | ✅ 完整支持,还提供 L7 扩展 |
| Flannel | ❌ 不支持(只负责打通网络) |
| Weave | ✅ 支持 |
用 Flannel 的集群写了 NetworkPolicy 不会报任何错,但策略完全不生效——这是最常见的「假安全感」。要么换 Calico 或 Cilium,要么用 Flannel 加 Calico 组合的 Canal 方案。
一个具体例子
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: web-policy
  namespace: demo
spec:
  podSelector:
    matchLabels:
      app: web          # 策略作用的 Pod
  policyTypes:
    - Ingress           # 声明本策略包含入站规则
  ingress:
    - from:
        - podSelector:  # 只允许带 app=frontend 标签的 Pod 访问
            matchLabels:
              app: frontend
      ports:
        - protocol: TCP
          port: 80
关键字段:
podSelector:选中被管控的 Pod。写空{}表示选中该 namespace 的全部 Pod。policyTypes:声明策略管Ingress(入站)、Egress(出站)还是两者。只要有 NetworkPolicy 选中某 Pod 并声明了某个方向,该方向就默认拒绝白名单之外的所有流量。ingress[].from:允许的来源,可以用podSelector(同 namespace 的 Pod)、namespaceSelector(整个 namespace 的 Pod)、两者组合,或ipBlock指定网段。egress[].to:允许的出站目标,写法与 from 对称。
注意 from 列表中多个元素之间是或的关系,而同一个元素里的多个 selector 是与的关系——新手常在这里把白名单写宽。
实践:先默认全拒,再逐步放行
安全基线的标准姿势:进 namespace 先一刀切全拒,再按需开白名单:
# 默认拒绝所有入站和出站流量
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-all
  namespace: demo
spec:
  podSelector: {}
  policyTypes:
    - Ingress
    - Egress
切完会发现 DNS 也断了,所以通常紧接着放行 kube-dns 的 UDP/53 出站,再按「frontend 调 web、web 调 db」的链路一条条补放行规则。规则宁缺毋滥,每加一条都问自己一句:这条流量真的有业务需要吗?
SecurityContext
SecurityContext 定义 Pod 和容器的权限与访问控制:以什么用户跑、能不能提权、文件系统可不可写、带哪些 Linux capabilities。它分两层:
| 层级 | 字段位置 | 作用范围 |
|---|---|---|
| Pod 级 | spec.securityContext | 对 Pod 内所有容器生效 |
| 容器级 | containers[].securityContext | 只对当前容器生效,会覆盖 Pod 级的同名字段 |
加固模板
一份符合 restricted 级别的加固模板长这样:
apiVersion: v1
kind: Pod
metadata:
  name: hardened
spec:
  securityContext:                  # Pod 级
    runAsNonRoot: true
    runAsUser: 1000
    fsGroup: 2000
    seccompProfile:
      type: RuntimeDefault
  containers:
    - name: app
      image: nginx:1.27
      securityContext:              # 容器级
        allowPrivilegeEscalation: false
        readOnlyRootFilesystem: true
        capabilities:
          drop: ["ALL"]
      volumeMounts:
        - name: tmp
          mountPath: /tmp
  volumes:
    - name: tmp
      emptyDir: {}
逐条解释关键字段:
runAsNonRoot: true:禁止以 root(UID 0)启动,镜像默认用户是 root 时直接拒绝运行。它要求镜像或配置里能确定一个非 root 用户,所以搭配runAsUser: 1000更稳。readOnlyRootFilesystem: true:容器根文件系统只读,攻击者拿到 shell 也改不了程序文件、写不了后门。代价是应用写临时文件会失败,所以挂一个emptyDir到/tmp兜底。allowPrivilegeEscalation: false:禁止进程获得比父进程更高的权限,直接废掉 setuid 类提权路径。只要开了 runAsNonRoot,这条就该配上。capabilities: drop: ["ALL"]:Linux capabilities 把 root 的权限拆成了细粒度的项(比如NET_RAW能伪造数据包、SYS_ADMIN几乎等于 root)。业务容器一项都用不到,先全部 drop,真有需要再按需add个别项。seccompProfile: RuntimeDefault:启用容器运行时自带的默认 seccomp 配置,拦掉一批危险系统调用,属于白捡的加固。
SecurityContext 不是万能的:镜像里如果内置了 setuid 程序,或者应用逻辑必须用 root 跑,runAsNonRoot 会直接让 Pod 起不来。选镜像时优先用官方的非 root 变体(如 bitnami 的 non-root 系列、distroless 镜像),从源头减少和加固策略的冲突。
ImagePullSecrets
私有镜像仓库要求认证,kubelet 拉镜像用的凭据就由 ImagePullSecrets 提供。
创建仓库凭据
kubectl create secret docker-registry regcred \
  --docker-server=registry.example.com \
  --docker-username=bot \
  --docker-password='S3cret!' \
  --docker-email=bot@example.com
这条命令生成的正是前面提到的 kubernetes.io/dockerconfigjson 类型 Secret,内容等价于 Docker 客户端的 config.json。
两种挂载方式
方式一:挂在 Pod(或工作负载的 Pod 模板)上,影响范围明确:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: app
spec:
  template:
    spec:
      imagePullSecrets:
        - name: regcred
      containers:
        - name: app
          image: registry.example.com/team/app:v1
方式二:挂在 ServiceAccount 上,让该 SA 下所有 Pod 自动带上凭据,适合团队统一用私有仓库的场景:
kubectl patch serviceaccount default \
  -p '{"imagePullSecrets": [{"name": "regcred"}]}' \
  -n demo
方式一精确,但每个工作负载都要写一遍;方式二省事,但作用面大——该 SA 的所有 Pod 都能拿到这份凭据。多团队共用集群时,按 namespace 隔离 SA、各挂各的凭据。
谁能在某 namespace 里读到这个 Secret,谁就拿到了仓库的登录凭据。仓库侧务必使用只读、权限最小化的机器人账号,别拿管理员账号来拉镜像。
TLS
Kubernetes 集群内部通信全程走 HTTPS,背后是一整套证书体系。kubeadm 装集群时会自动签好,但心里要有一张地图。
集群内证书体系
kubeadm 安装时会在 /etc/kubernetes/pki/ 下生成一套 CA 和证书:
/etc/kubernetes/pki/
├── ca.crt / ca.key             # 集群根 CA
├── apiserver.crt               # API Server 的服务端证书
├── apiserver-kubelet-client.*  # API Server 访问 kubelet 的客户端证书
├── front-proxy-ca.*            # 聚合层(扩展 apiserver)专用 CA
├── sa.key / sa.pub             # ServiceAccount Token 的签名密钥对
└── etcd/                       # etcd 自己的一套 CA 和证书
关键角色:
- 集群 CA:一切的信任根。API Server、kubelet、各组件的证书都由它签发;kubeconfig 里的
certificate-authority-data就是它,用来验证「我连的是真的 API Server」。 - API Server 证书:6443 端口的服务端证书。签发时 SAN 里必须包含所有可能的访问地址(内外网 IP、
kubernetes.default.svc等),否则客户端会报证书域名不匹配。 - kubelet 证书:每个节点 10250 端口的服务端证书,API Server 反向访问 kubelet(
kubectl logs、exec都走这条路)时要验证它;kubelet 还持有客户端证书,用于向 API Server 注册和汇报状态。 - 这套证书默认有效期一年,
kubeadm certs check-expiration可以查看到期时间,kubeadm certs renew all手动续期,用 kubeadm 升级集群时也会自动续。
cert-manager:应用证书自动化
集群组件的证书 kubeadm 管,应用的证书(比如 Ingress 的 HTTPS 证书)就靠 cert-manager——它是事实标准的证书自动化控制器:
- 用
Issuer(单 namespace 可用)或ClusterIssuer(集群可用)描述证书从哪来:Let's Encrypt 等 ACME 服务、私有 CA、自签名。 - 创建
Certificate资源(或直接给 Ingress 加注解)声明「我要某域名的证书」,cert-manager 自动完成申请、域名验证、签发,结果存成kubernetes.io/tls类型的 Secret 供 Ingress 引用。 - 到期前自动续期,彻底告别「证书忘了续、全站挂掉」的事故。
apiVersion: cert-manager.io/v1
kind: ClusterIssuer
metadata:
  name: letsencrypt
spec:
  acme:
    server: https://acme-v02.api.letsencrypt.org/directory
    email: ops@example.com
    privateKeySecretRef:
      name: letsencrypt-key
    solvers:
      - http01:
          ingress:
            class: nginx
之后给 Ingress 加上注解 cert-manager.io/cluster-issuer: letsencrypt,新站点的 HTTPS 证书就全自动了。
多租户实践
把前面的内容串起来:一个集群要安全地给多个团队(租户)用,标准做法是以 namespace 为隔离边界,组合拳层层设防。假设给 team-a 团队开一个租户空间,整套清单长这样。
1. Namespace:隔离边界
kubectl create namespace team-a
一切隔离的基础,也是后面所有策略的作用域。
2. RBAC:只给本 namespace 的管理权
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: team-a-admin
  namespace: team-a
subjects:
  - kind: Group
    name: team-a
    apiGroup: rbac.authorization.k8s.io
roleRef:
  kind: ClusterRole
  name: admin
  apiGroup: rbac.authorization.k8s.io
直接用内置的 admin、edit、view ClusterRole 搭配 RoleBinding,不用从头写规则。注意内置 admin 允许操作 Role 和 RoleBinding,意味着租户能在自己地盘里继续授权别人,介意的话自己裁剪一份。
3. ResourceQuota:防止一个团队吃光集群
apiVersion: v1
kind: ResourceQuota
metadata:
  name: team-a-quota
  namespace: team-a
spec:
  hard:
    requests.cpu: "20"
    requests.memory: 40Gi
    limits.cpu: "40"
    limits.memory: 80Gi
    pods: "50"
配额用完后创建新 Pod 会被准入控制直接拒绝,报错信息里会写明哪一项超额。
4. LimitRange:给不设限额的容器补默认值
光配 Quota 有个副作用:只要 Quota 管了 CPU 和内存,之后每个容器都必须显式写 requests/limits,否则创建被拒。用 LimitRange 给没写的容器兜底:
apiVersion: v1
kind: LimitRange
metadata:
  name: team-a-limits
  namespace: team-a
spec:
  limits:
    - type: Container
      default:                # 没写 limits 时的默认值
        cpu: 500m
        memory: 512Mi
      defaultRequest:         # 没写 requests 时的默认值
        cpu: 100m
        memory: 128Mi
      max:                    # 单容器上限
        cpu: "2"
        memory: 4Gi
5. NetworkPolicy:租户间网络隔离
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: team-a-isolation
  namespace: team-a
spec:
  podSelector: {}
  policyTypes:
    - Ingress
  ingress:
    - from:
        - podSelector: {}    # 只允许同 namespace 内的 Pod 互访
配上以后其他 namespace 默认一概进不来,有跨团队协作需求再单独开口子。
6. Pod Security:统一安全基线
kubectl label namespace team-a \
  pod-security.kubernetes.io/enforce=baseline \
  pod-security.kubernetes.io/warn=restricted
组合拳总览
| 层 | 对象 | 解决的问题 |
|---|---|---|
| 隔离边界 | Namespace | 资源命名隔离与策略作用域 |
| 权限 | RBAC(RoleBinding + 内置 ClusterRole) | 租户只能管自己的地盘 |
| 资源 | ResourceQuota | 防止一个租户吃光集群总量 |
| 资源 | LimitRange | 防止单容器狮子大开口,补默认值 |
| 网络 | NetworkPolicy | 防止租户间横向访问 |
| 安全基线 | Pod Security Admission | 危险配置的 Pod 直接拒建 |
| 身份 | ServiceAccount + 最小权限 | Pod 访问 API 的身份收敛 |
这套配齐,一个「带护栏」的租户空间就成型了:团队在自己的 namespace 里有充分的自由,又碰不到别人、拖不垮集群。