集群安装与生命周期管理
集群不是装完就万事大吉的,它有一整个生命周期:安装、升级、扩缩容、证书续期、备份恢复、节点维护,最后到退役。这篇笔记按顺序记录两件事:怎么把集群装起来(kubeadm 为主,二进制部署讲思路),以及装完之后怎么把它养活(升级、证书、etcd 备份、扩缩容、维护窗口)。
示例环境:Ubuntu 22.04 + containerd 1.7 + Kubernetes v1.30,三台虚拟机。命令以 Debian/Ubuntu 系为准,CentOS/Rocky 系把 apt 换成 dnf、包名基本一样,差异处会单独说明。
文中所有版本号(v1.30.4、Calico v3.28 等)都是写笔记时的稳定版示例,实际操作时替换成你要装的版本即可,流程完全一样。
kubeadm
kubeadm 是官方出的集群引导工具,定位是「把搭集群这件事标准化」:生成证书、写各组件的 kubeconfig、把控制平面组件以静态 Pod 的形式跑起来、发放入集群的 token。它不装容器运行时、不装 CNI 网络插件,这两块要自己准备。
一条 kubeadm init 实际做了这些事:
- 在
/etc/kubernetes/pki/下生成整套 CA 和组件证书 - 在
/etc/kubernetes/下生成 admin.conf、kubelet.conf 等 kubeconfig 文件 - 在
/etc/kubernetes/manifests/下写静态 Pod 清单,kubelet 据此拉起 etcd、apiserver、controller-manager、scheduler - 创建 bootstrap token 和集群配置 ConfigMap,供后续节点 join 使用
下面是从零到可用的完整流程。
节点规划
| 主机名 | IP | 角色 | 最低配置 |
|---|---|---|---|
| k8s-master | 172.16.1.10 | control plane | 2C4G |
| k8s-node1 | 172.16.1.11 | worker | 2C4G |
| k8s-node2 | 172.16.1.12 | worker | 2C4G |
Pod 网段(示例用 192.168.0.0/16)和 Service 网段(默认 10.96.0.0/12)不能和宿主机网段、公司内网网段冲突,否则路由会乱,问题非常难排查。示例里宿主机用 172.16.1.0/24,和两个网段都错开了;如果你的内网恰好占了 192.168.0.0/16,就把 Pod 网段换成 10.244.0.0/16 之类。
第一步:系统准备(所有节点)
设置主机名和 hosts 解析:
# 各节点分别设置自己的主机名,以 master 为例
sudo hostnamectl set-hostname k8s-master

# 所有节点都写入同样的解析记录
cat <<EOF | sudo tee -a /etc/hosts
172.16.1.10 k8s-master
172.16.1.11 k8s-node1
172.16.1.12 k8s-node2
EOF
关闭 swap(kubelet 默认拒绝在开启 swap 的机器上工作):
# 立即关闭
sudo swapoff -a

# 永久关闭:注释掉 fstab 里的 swap 行,防止重启后恢复
sudo sed -i '/ swap / s/^/#/' /etc/fstab
加载内核模块,开启 iptables 桥接和转发:
# 开机自动加载 overlay 和 br_netfilter 模块
cat <<EOF | sudo tee /etc/modules-load.d/k8s.conf
overlay
br_netfilter
EOF

# 立即加载
sudo modprobe overlay
sudo modprobe br_netfilter

# 内核参数:让 iptables 能看到经过网桥的流量,开启转发
cat <<EOF | sudo tee /etc/sysctl.d/k8s.conf
net.bridge.bridge-nf-call-ip6tables = 1
net.bridge.bridge-nf-call-iptables = 1
net.ipv4.ip_forward = 1
EOF

# 生效
sudo sysctl --system
另外三件小事:
- 软件源:把 Ubuntu 基础 apt 源换成阿里云,后面装前置包、打补丁都快得多:
# 备份后一键替换(22.04 是 jammy,其他版本对应更换代号)
sudo cp /etc/apt/sources.list /etc/apt/sources.list.bak
sudo sed -i 's|http://archive.ubuntu.com|https://mirrors.aliyun.com|g; s|http://security.ubuntu.com|https://mirrors.aliyun.com|g' /etc/apt/sources.list
sudo apt-get update
- 时间同步:集群各节点时间必须一致(证书校验、etcd 都依赖时间),用
timedatectl确认 NTP 已开启,或装 chronyd。 - 防火墙:学习环境直接
sudo ufw disable(CentOS 是sudo systemctl disable --now firewalld)省事;生产环境按端口放行,控制平面需要 6443、2379-2380、10250、10257、10259,worker 需要 10250 和 NodePort 范围 30000-32767。
第二步:安装容器运行时 containerd(所有节点)
kubeadm 只认 CRI 接口的运行时,现在主流选择就是 containerd。Ubuntu 上最省事的方式是添加 apt 源装 containerd.io,国内直接用阿里云的 Docker CE 镜像源:
# 添加阿里云 Docker CE 镜像源(只为装 containerd.io,不装 Docker 本体)
sudo apt-get update
sudo apt-get install -y ca-certificates curl gnupg
sudo install -m 0755 -d /etc/apt/keyrings
curl -fsSL https://mirrors.aliyun.com/docker-ce/linux/ubuntu/gpg | sudo gpg --dearmor -o /etc/apt/keyrings/docker.gpg
echo "deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/keyrings/docker.gpg] https://mirrors.aliyun.com/docker-ce/linux/ubuntu $(. /etc/os-release && echo $VERSION_CODENAME) stable" | sudo tee /etc/apt/sources.list.d/docker.list
sudo apt-get update
sudo apt-get install -y containerd.io
装完必须改两处配置(原因见本文「containerd」一节):
# 生成默认配置
sudo mkdir -p /etc/containerd
containerd config default | sudo tee /etc/containerd/config.toml

# 1. 打开 SystemdCgroup,和 kubelet 的 cgroup 驱动保持一致
sudo sed -i 's/SystemdCgroup = false/SystemdCgroup = true/' /etc/containerd/config.toml

# 2. pause 沙箱镜像换成国内可拉取的地址
sudo sed -i 's|sandbox_image = ".*"|sandbox_image = "registry.aliyuncs.com/google_containers/pause:3.9"|' /etc/containerd/config.toml

sudo systemctl restart containerd
sudo systemctl enable containerd
pause 版本随 Kubernetes 版本变化(v1.30 对应 3.9,v1.31 起是 3.10)。装好 kubeadm 后可以执行 sudo kubeadm config images list 查看这个版本期望的完整镜像清单,containerd 里的 sandbox_image 保持和清单里的 pause 一致,避免 init 预拉取一套、运行时又拉另一套。
第三步:安装 kubeadm、kubelet、kubectl(所有节点)
Kubernetes 官方 apt 源(pkgs.k8s.io)国内拉不动,直接用阿里云的镜像仓库。K8s 的 apt 源按 minor 版本分仓库,这里以 v1.30 为例:
curl -fsSL https://mirrors.aliyun.com/kubernetes-new/core/stable/v1.30/deb/Release.key | sudo gpg --dearmor -o /etc/apt/keyrings/kubernetes-apt-keyring.gpg
echo 'deb [signed-by=/etc/apt/keyrings/kubernetes-apt-keyring.gpg] https://mirrors.aliyun.com/kubernetes-new/core/stable/v1.30/deb/ /' | sudo tee /etc/apt/sources.list.d/kubernetes.list
sudo apt-get update
sudo apt-get install -y kubelet kubeadm kubectl

# 锁定版本,防止 apt upgrade 顺手把集群组件升了
sudo apt-mark hold kubelet kubeadm kubectl
在海外机器或有代理的环境,把上面两条里的地址换成官方源 https://pkgs.k8s.io/core:/stable:/v1.30/deb/ 即可,其余命令不变。
- kubelet:每个节点都要跑,真正干活的,负责拉起 Pod。
- kubeadm:只在装集群、升集群、加节点时用,平时不运行。
- kubectl:命令行客户端,只需要装在你要执行命令的机器上(一般就是 master)。
第四步:初始化控制平面(只在 master 执行)
sudo kubeadm init \
  --apiserver-advertise-address=172.16.1.10 \
  --pod-network-cidr=192.168.0.0/16 \
  --service-cidr=10.96.0.0/12 \
  --kubernetes-version=v1.30.4 \
  --image-repository=registry.aliyuncs.com/google_containers \
  --cri-socket=unix:///run/containerd/containerd.sock
几个关键参数:
| 参数 | 作用 |
|---|---|
apiserver-advertise-address | apiserver 对外宣告的地址,填 master 本机 IP |
pod-network-cidr | Pod 网段,要和后面装的 CNI 插件默认值一致(Calico 默认 192.168.0.0/16,Flannel 默认 10.244.0.0/16) |
service-cidr | Service 网段,默认 10.96.0.0/12,一般不用改 |
kubernetes-version | 明确指定版本,避免拉错 |
image-repository | 镜像仓库,国内换成阿里云镜像,不然拉不动 registry.k8s.io |
cri-socket | 告诉 kubeadm 容器运行时的 socket 地址,用 containerd 就要显式指定 |
初始化成功会输出类似内容:
Your Kubernetes control-plane has initialized successfully!

To start using your cluster, you need to run the following as a regular user:

  mkdir -p $HOME/.kube
  sudo cp -i /etc/kubernetes/admin.conf $HOME/.kube/config
  sudo chown $(id -u):$(id -g) $HOME/.kube/config

Then you can join any number of worker nodes by running the following on each as root:

kubeadm join 172.16.1.10:6443 --token abcdef.0123456789abcdef \
        --discovery-token-ca-cert-hash sha256:3b5a5c...(省略)
最后那行 join 命令是 worker 节点入集群的凭证,复制保存。token 有效期 24 小时,过期了也没关系,用 kubeadm token create --print-join-command 重新生成(见「节点扩容」一节)。
如果 init 失败或想重来,先重置再执行:
sudo kubeadm reset --cri-socket unix:///run/containerd/containerd.sock
sudo rm -rf /etc/cni/net.d $HOME/.kube
第五步:配置 kubectl 凭证(在 master 执行)
init 的输出里已经给了这三条命令,照抄即可:
mkdir -p $HOME/.kube
sudo cp -i /etc/kubernetes/admin.conf $HOME/.kube/config
sudo chown $(id -u):$(id -g) $HOME/.kube/config
验证:
kubectl get nodes
NAME         STATUS     ROLES           AGE   VERSION
k8s-master   NotReady   control-plane   2m    v1.30.4
此时节点是 NotReady,因为还没装网络插件,属于正常现象。
第六步:安装 CNI 网络插件(在 master 执行)
没有 CNI,Pod 之间不通,节点也不会 Ready。Calico 和 Flannel 二选一即可。
Calico(推荐,功能全,支持网络策略):
kubectl create -f https://raw.githubusercontent.com/projectcalico/calico/v3.28.1/manifests/tigera-operator.yaml
kubectl create -f https://raw.githubusercontent.com/projectcalico/calico/v3.28.1/manifests/custom-resources.yaml
Calico 默认 Pod 网段就是 192.168.0.0/16,和 init 时的 --pod-network-cidr 一致,不用改。国内拉不动 raw.githubusercontent.com 的话,先在本机把两个 yaml 下载下来,scp 上去再 kubectl create -f。
Flannel(简单够用,只提供基础网络):
kubectl apply -f https://github.com/flannel-io/flannel/releases/latest/download/kube-flannel.yml
注意 Flannel 默认网段是 10.244.0.0/16,如果用它,第四步 init 时的 --pod-network-cidr 就要写成 10.244.0.0/16。
装完观察插件 Pod 起来没有:
kubectl get pods -n kube-system
kubectl get nodes
等所有系统 Pod Running,节点状态变成 Ready:
NAME         STATUS   ROLES           AGE   VERSION
k8s-master   Ready    control-plane   8m    v1.30.4
第七步:worker 节点加入集群(在各 worker 执行)
在两个 worker 上执行 init 输出里保存的 join 命令,记得补 cri-socket:
sudo kubeadm join 172.16.1.10:6443 --token abcdef.0123456789abcdef \
  --discovery-token-ca-cert-hash sha256:3b5a5c...(省略) \
  --cri-socket=unix:///run/containerd/containerd.sock
回 master 验证:
kubectl get nodes -o wide
NAME         STATUS   ROLES           AGE   VERSION   INTERNAL-IP    CONTAINER-RUNTIME
k8s-master   Ready    control-plane   20m   v1.30.4   172.16.1.10   containerd://1.7.20
k8s-node1    Ready    <none>          10m   v1.30.4   172.16.1.11   containerd://1.7.20
k8s-node2    Ready    <none>          10m   v1.30.4   172.16.1.12   containerd://1.7.20
三个节点全部 Ready,单控制平面集群搭建完成。跑个 nginx 冒烟测试一下:
kubectl create deployment nginx --image=nginx:1.27 --replicas=2
kubectl expose deployment nginx --port=80 --type=NodePort
kubectl get svc nginx
二进制部署
二进制部署是指不走 kubeadm,自己下载每个组件的二进制文件,自己签证书,自己写 systemd 服务,一个组件一个组件地启动集群。Kubernetes 早期的「Kubernetes the Hard Way」就是这条路。
和 kubeadm 的区别
| 对比项 | kubeadm | 二进制部署 |
|---|---|---|
| 自动化程度 | 一条 init 命令搞定证书、配置、启动 | 全部手工,几十步 |
| 证书管理 | 自动签发、可一键续期 | 用 cfssl/openssl 自己签,续期也要自己来 |
| 升级 | kubeadm upgrade 标准化流程 | 逐组件替换二进制、改配置 |
| 定制能力 | 有边界,受 kubeadm 约定限制 | 完全自由,参数、路径、CA 策略都能定 |
| 学习价值 | 知其然 | 知其所以然,每个组件怎么连的都清清楚楚 |
| 出问题概率 | 低,流程经过大量验证 | 高,证书 CN/SAN 错一点就连不通 |
什么时候用二进制
- 学习目的:想彻底搞懂 apiserver 怎么连 etcd、kubelet 怎么向 apiserver 注册,手搓一遍比看十篇文档有用。
- 生产定制:要对接公司已有的 PKI/CA 体系、要放在离线环境里逐包审计、组件参数有特殊要求,kubeadm 的约定满足不了。
日常生产和测试环境用 kubeadm 就够了,没必要为装而装。
需要部署的组件清单
| 类别 | 组件 | 说明 |
|---|---|---|
| 证书 | CA、etcd CA、front-proxy CA、sa 密钥对 | 先签 CA,再逐组件签服务端/客户端证书,CN 和 SAN 必须按组件身份填对 |
| etcd | etcd | 独立集群,3 节点,存储全部集群数据 |
| 控制平面 | kube-apiserver | 集群入口,指向 etcd,带一大堆证书和准入参数 |
| 控制平面 | kube-controller-manager | 各类控制器 |
| 控制平面 | kube-scheduler | 调度器 |
| 节点 | kubelet | 每个节点都要,配 bootstrap kubeconfig 实现证书自动签发 |
| 节点 | kube-proxy | 每个节点都要,负责 Service 转发规则 |
| 运行时 | containerd | 同 kubeadm 方案 |
| 插件 | CNI、CoreDNS | 网络插件和集群 DNS,以 yaml 形式部署 |
大致顺序:签证书 → 起 etcd 集群 → 起 apiserver → 起 controller-manager 和 scheduler → 各节点起 kubelet、kube-proxy → kubectl certificate approve 审批 kubelet 的证书请求 → 部署 CNI 和 CoreDNS。
kubeasz(Ansible 剧本)、Kubespray、Sealos 都是二进制思路的自动化封装,适合想绕开 kubeadm 又不想纯手工的场景。
高可用架构
单控制平面集群里 master 一挂,虽然已有业务 Pod 还在跑,但整个集群失去管理能力:不能调度、不能扩缩、kubectl 全部失灵。生产环境必须做高可用(HA)。
两种 etcd 拓扑
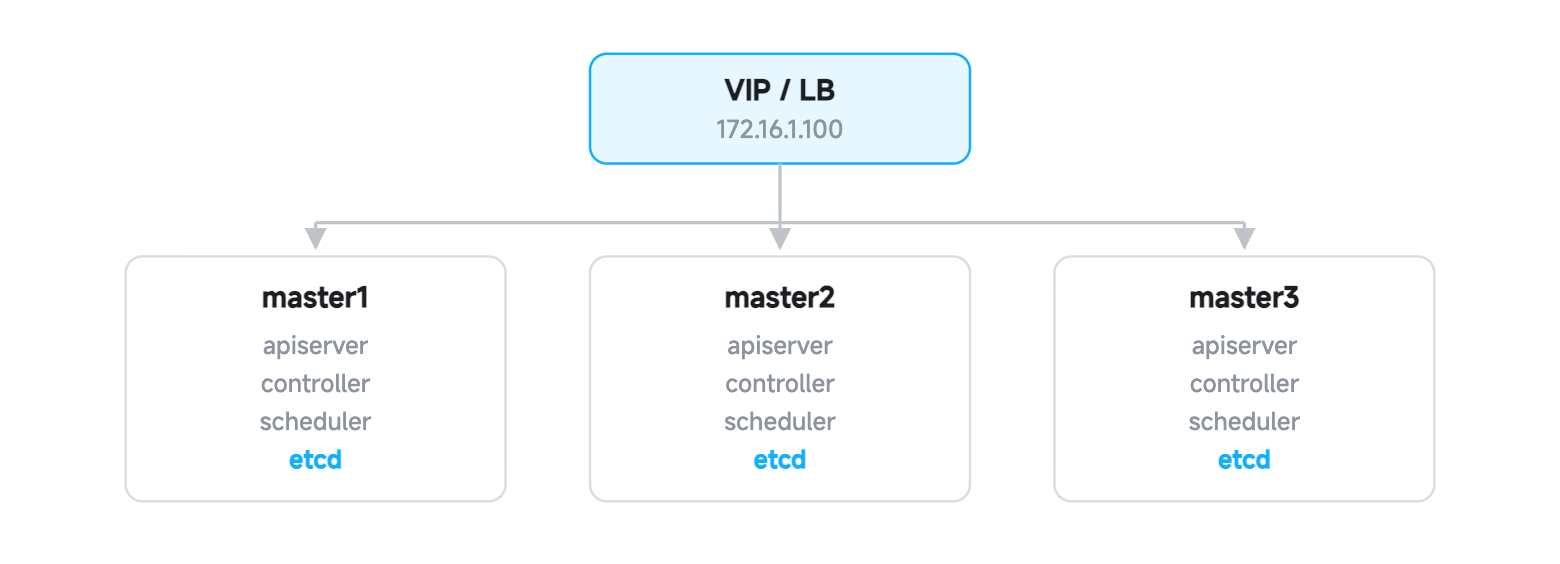
Stacked etcd(堆叠式):etcd 和控制平面组件跑在同一批节点上,kubeadm 默认就是这种方式。
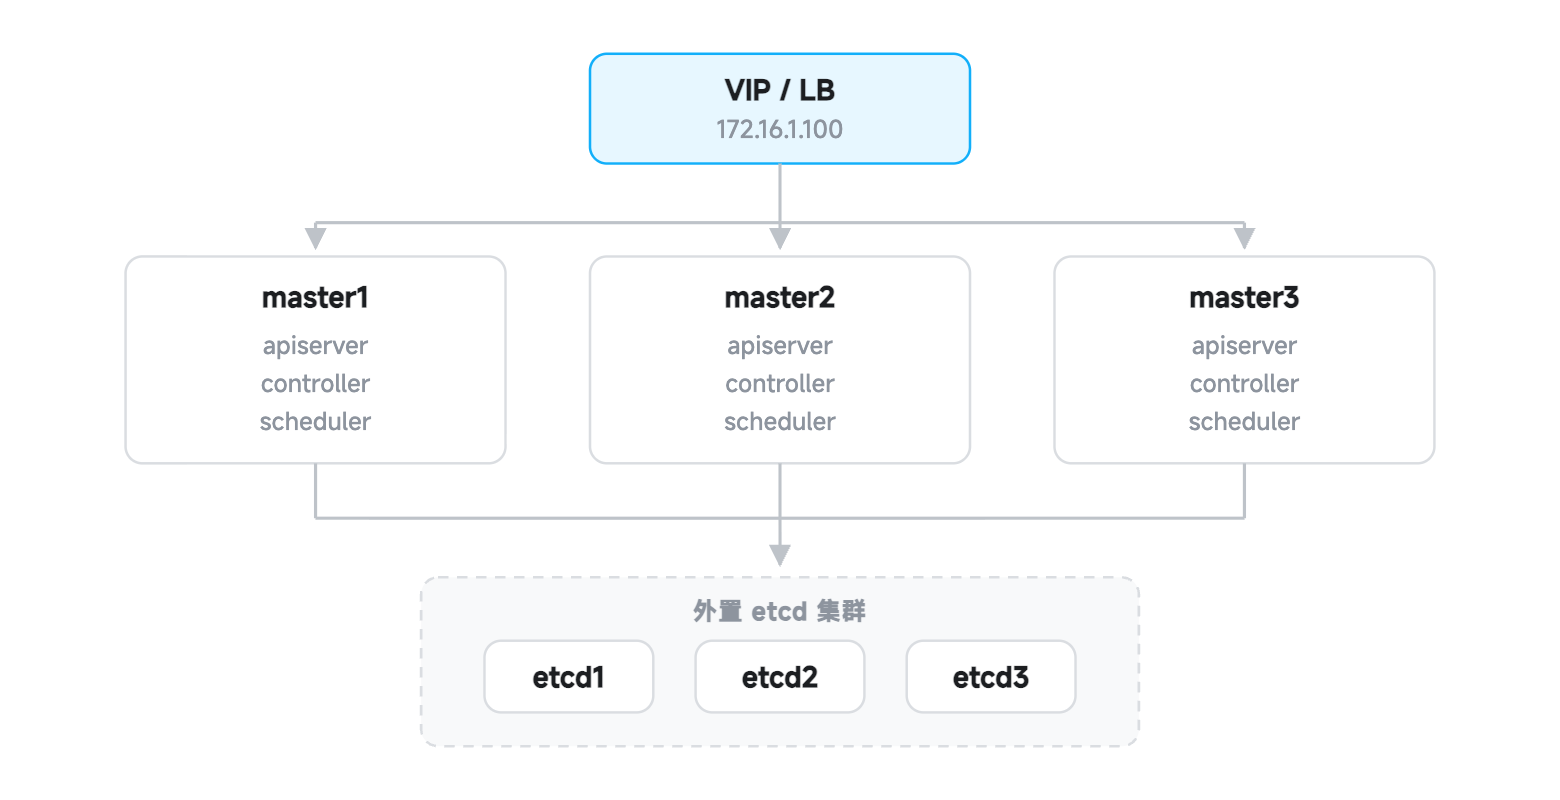
External etcd(外置式):etcd 单独一组节点,控制平面节点只跑 K8s 组件。
| 对比项 | Stacked etcd | External etcd |
|---|---|---|
| 机器数量 | 3 台搞定 | 至少 6 台(3 控制平面 + 3 etcd) |
| 故障影响 | 挂一台 master 同时损失一个控制平面和一个 etcd 成员 | 故障域隔离,互不影响 |
| 运维复杂度 | 低,kubeadm 原生支持 | 高,etcd 集群要单独部署维护 |
| 适用场景 | 中小规模集群 | 大规模、对稳定性要求高的集群 |
APIServer 前面挂负载均衡
多个 apiserver 是对等的,但需要给集群一个统一入口,这个入口还不能是单点。经典方案是 haproxy + keepalived:
- haproxy 装在每个 master 上,监听一个端口(如 8443),把流量轮询转发到三台 apiserver 的 6443,带健康检查,自动剔除挂掉的 apiserver。
- keepalived 负责维护一个虚拟 IP(VIP,如 172.16.1.100),通过 VRRP 在 master 节点间漂移;挂一台,VIP 漂到另一台,入口不中断。
haproxy 配置片段:
frontend k8s-apiserver
    bind *:8443
    mode tcp
    default_backend k8s-masters

backend k8s-masters
    mode tcp
    balance roundrobin
    option tcp-check
    server master1 172.16.1.10:6443 check fall 3 rise 2
    server master2 172.16.1.20:6443 check fall 3 rise 2
    server master3 172.16.1.30:6443 check fall 3 rise 2
keepalived 关键配置(主节点):
vrrp_instance VI_1 {
    state MASTER
    interface eth0
    virtual_router_id 51
    priority 100
    virtual_ipaddress {
        172.16.1.100/24
    }
}
LB 就绪后,init 时用 --control-plane-endpoint 指向 VIP,加 --upload-certs 把控制平面证书上传到集群(有效期 2 小时),供后续 master 加入时下载:
# 第一台 master
sudo kubeadm init \
  --control-plane-endpoint="172.16.1.100:8443" \
  --upload-certs \
  --pod-network-cidr=192.168.0.0/16 \
  --cri-socket=unix:///run/containerd/containerd.sock

# 第二、三台 master 用带 --control-plane 的 join 命令加入
sudo kubeadm join 172.16.1.100:8443 --token xxx \
  --discovery-token-ca-cert-hash sha256:xxx \
  --control-plane --certificate-key xxx \
  --cri-socket=unix:///run/containerd/containerd.sock
之后所有组件(kubelet、kubectl、worker 节点)都只认 VIP,不再直接连任何一台 master。
云厂商有现成的负载均衡(SLB/CLB),直接买一个 TCP 四层 LB 指向三台 master 的 6443,就不需要自己搞 keepalived 了。
为什么是 3 节点起步
高可用的数学基础是 etcd 的 Raft 协议:写入必须得到**多数派(quorum)**确认,法定人数为 (n/2)+1。
| etcd 节点数 | 法定人数 | 可容忍故障数 |
|---|---|---|
| 1 | 1 | 0 |
| 2 | 2 | 0 |
| 3 | 2 | 1 |
| 4 | 3 | 1 |
| 5 | 3 | 2 |
| 6 | 4 | 2 |
| 7 | 4 | 3 |
看点在两个地方:
- 2 节点没有任何意义:quorum 是 2,挂一台就失去多数派,和单点一样脆弱。
- 偶数节点浪费:4 节点和 3 节点一样只能容忍 1 台故障,却多维护一台机器,还多一份网络分区的概率。
所以控制平面/etcd 永远用奇数:3 台起步(容忍 1 台故障),规模大、要求高再上 5 台(容忍 2 台)。一般不超过 7 台,节点太多 Raft 协商本身的开销会拖慢写入。
containerd
containerd 是容器运行时,kubelet 通过 CRI(Container Runtime Interface)gRPC 接口调用它来拉镜像、起容器。装集群时真正需要操心的就是它的配置文件 /etc/containerd/config.toml,有三个要点。
要点一:SystemdCgroup 必须为 true
kubeadm 部署的集群里,kubelet 默认用 systemd 作为 cgroup 驱动;如果 containerd 还在用默认的 cgroupfs,两套 cgroup 管理混在一起,轻则 kubelet 起不来报驱动不一致,重则节点莫名其妙 NotReady。kubeadm init 的预检会直接拦下这个错误。
默认生成的配置里这一项是 false,必须改:
containerd config default | sudo tee /etc/containerd/config.toml
sudo sed -i 's/SystemdCgroup = false/SystemdCgroup = true/' /etc/containerd/config.toml
sudo systemctl restart containerd
对应配置位置:
[plugins."io.containerd.grpc.v1.cri".containerd.runtimes.runc.options]
  SystemdCgroup = true
要点二:pause 沙箱镜像替换
每个 Pod 的第一个容器其实是 pause(沙箱容器),负责持有 Pod 的网络命名空间。默认地址 registry.k8s.io/pause:3.9 国内拉不到,改成阿里云镜像:
[plugins."io.containerd.grpc.v1.cri"]
  sandbox_image = "registry.aliyuncs.com/google_containers/pause:3.9"
版本号用 sudo kubeadm config images list 查当前 Kubernetes 版本对应的 pause 版本,两者保持一致。
要点三:镜像加速与私有仓库
containerd 1.5 之后推荐用 config_path 目录方式配置镜像加速,每个仓库一个目录:
[plugins."io.containerd.grpc.v1.cri".registry]
  config_path = "/etc/containerd/certs.d"
比如给 Docker Hub 配加速,创建 /etc/containerd/certs.d/docker.io/hosts.toml:
server = "https://docker.io"

[host."https://docker.m.daocloud.io"]
  capabilities = ["pull", "resolve"]
私有仓库的自签名证书、HTTP 明文仓库、认证信息,同样在这个目录下按仓库名建目录配置。改完 sudo systemctl restart containerd 生效。
老的 registry.mirrors 表写法(直接在 config.toml 里写 mirrors 列表)目前仍兼容,但官方推荐迁移到 certs.d 目录方式,新环境直接用新方式。
日常调试用 crictl
集群里没有 Docker CLI,排查节点上的容器用 crictl。先写个配置省得每次敲 endpoint:
# /etc/crictl.yaml
runtime-endpoint: unix:///run/containerd/containerd.sock
image-endpoint: unix:///run/containerd/containerd.sock
timeout: 10
常用命令:
crictl ps                 # 看运行中的容器
crictl ps -a              # 包括已退出的
crictl images             # 看镜像
crictl logs <容器ID>      # 看容器日志
crictl inspect <容器ID>   # 看容器详情
crictl rmi --prune        # 清理无用镜像
nerdctl 是 containerd 的 Docker 风格 CLI,命令和 docker 几乎一样(nerdctl ps、nerdctl run),运维习惯 docker 的话可以装一个。
RuntimeClass
一个集群里可以共存多种容器运行时,RuntimeClass 就是用来选「这个 Pod 用哪种运行时跑」的机制。最典型的场景:默认用 runc(普通容器),对安全性要求高的多租户业务用 gVisor(runsc,用户态内核拦截系统调用)或 Kata Containers(轻量虚拟机)。
工作流程
- 在节点上装好备选运行时(比如 gVisor 的 runsc)。
- 在 containerd 的 config.toml 里注册这个运行时:
[plugins."io.containerd.grpc.v1.cri".containerd.runtimes.runsc]
  runtime_type = "io.containerd.runsc.v1"
- 创建 RuntimeClass 资源,
handler就是上面注册的运行时名字:
apiVersion: node.k8s.io/v1
kind: RuntimeClass
metadata:
  name: gvisor
handler: runsc
- Pod 里通过
runtimeClassName引用:
apiVersion: v1
kind: Pod
metadata:
  name: nginx-gvisor
spec:
  runtimeClassName: gvisor
  containers:
    - name: nginx
      image: nginx:1.27
不写 runtimeClassName 的 Pod 走集群默认运行时(runc),互不影响。
只有部分节点装了 gVisor 时,可以在 RuntimeClass 里加 scheduling.nodeSelector 限制这类 Pod 只调度到装了 runsc 的节点,避免调度到没装的节点上起不来。
集群升级
Kubernetes 每 4 个月左右发一个 minor 版本,每个版本维护约 14 个月,不及时升级就会失去补丁支持。kubeadm 集群的升级有固定套路。
版本偏差策略(升级前必看)
- 不能跨 minor 版本升级:1.29 → 1.30 → 1.31 一个一个来,不允许 1.29 直接跳 1.31。
- 先升控制平面,再升工作节点:kubelet 可以比 apiserver 低最多 3 个 minor 版本,但反过来不行。
- kubectl 和 apiserver 相差 1 个 minor 以内。
- 备份 etcd(见下文「ETCD 备份恢复」),升级翻车还能回滚。
- 查插件兼容性:CNI(Calico/Flannel)、CoreDNS、ingress-controller 对新版本的支持矩阵,必要时先升插件。
升级控制平面(以 1.29.6 → 1.30.4 为例)
# 1. 解锁并升级 kubeadm(先升它,用新版 kubeadm 来执行升级)
sudo apt-mark unhold kubeadm
sudo apt-get update && sudo apt-get install -y kubeadm=1.30.4-1.1
sudo apt-mark hold kubeadm

# 2. 查看升级计划,确认目标版本和要做的动作
sudo kubeadm upgrade plan

# 3. 执行升级(拉新镜像、滚动重启静态 Pod)
sudo kubeadm upgrade apply v1.30.4

# 4. 腾空节点,准备升级 kubelet
kubectl drain k8s-master --ignore-daemonsets

# 5. 升级 kubelet 和 kubectl
sudo apt-mark unhold kubelet kubectl
sudo apt-get install -y kubelet=1.30.4-1.1 kubectl=1.30.4-1.1
sudo apt-mark hold kubelet kubectl

# 6. 重启 kubelet,恢复调度
sudo systemctl daemon-reload
sudo systemctl restart kubelet
kubectl uncordon k8s-master
多控制平面集群里,后续 master 用 sudo kubeadm upgrade node(不是 apply)走第 2、3 步,其余相同。
升级工作节点
# 在 master 上:腾空节点,把业务 Pod 赶走
kubectl drain k8s-node1 --ignore-daemonsets --delete-emptydir-data

# 在被升级的节点上:
sudo apt-mark unhold kubeadm && sudo apt-get install -y kubeadm=1.30.4-1.1 && sudo apt-mark hold kubeadm
sudo kubeadm upgrade node
sudo apt-mark unhold kubelet kubectl && sudo apt-get install -y kubelet=1.30.4-1.1 kubectl=1.30.4-1.1 && sudo apt-mark hold kubelet kubectl
sudo systemctl daemon-reload && sudo systemctl restart kubelet

# 在 master 上:恢复调度
kubectl uncordon k8s-node1
一台一台滚动升,升一台验证一台,业务靠副本和 PDB 保证不中断。
kubectl get nodes # 确认所有节点 VERSION 都已到 v1.30.4
证书更新
kubeadm 签的组件证书(apiserver、etcd、front-proxy 等)有效期只有一年(根 CA 是十年)。到期不续,apiserver 直接不可用,kubectl 报证书过期错误,集群瘫痪——这是 kubeadm 集群最经典的「一年之痒」。
检查过期时间
sudo kubeadm certs check-expiration
CERTIFICATE                EXPIRES                  RESIDUAL TIME   CERTIFICATE AUTHORITY   EXTERNALLY MANAGED
admin.conf                 Jun 10, 2026 09:12 UTC   364d                                    no
apiserver                  Jun 10, 2026 09:12 UTC   364d            ca                      no
apiserver-etcd-client      Jun 10, 2026 09:12 UTC   364d            etcd-ca                 no
apiserver-kubelet-client   Jun 10, 2026 09:12 UTC   364d            ca                      no
...
CERTIFICATE AUTHORITY   EXPIRES                  RESIDUAL TIME   EXTERNALLY MANAGED
ca                      Jun 08, 2035 09:12 UTC   9y              no
etcd-ca                 Jun 08, 2035 09:12 UTC   9y              no
front-proxy-ca          Jun 08, 2035 09:12 UTC   9y              no
建议把这条命令放进季度巡检,剩余时间少于 90 天就安排续期。
一键续期全部证书
sudo kubeadm certs renew all
续期只更新 /etc/kubernetes/pki/ 下的证书文件和 admin.conf 等 kubeconfig 里的证书,正在运行的控制平面组件不会自动加载新证书,必须重启静态 Pod 才生效:
# 方法一(优雅):停掉静态 Pod 的容器,kubelet 会自动用新证书重建
sudo crictl ps | grep -E 'kube-apiserver|kube-controller-manager|kube-scheduler|etcd'
sudo crictl stop <容器ID>     # 逐个停,kubelet 会自动拉起

# 方法二(简单粗暴):维护窗口内直接重启节点
sudo reboot
重启后再 check-expiration 确认 RESIDUAL TIME 都回到了 364 天左右,并验证 kubectl 可用。
kubeadm certs renew 只对 kubeadm 自己管理的 CA 签发的证书有效(check-expiration 输出里 EXTERNALLY MANAGED 为 no 的那些)。如果证书是公司 CA 体系签的(yes),续期要走对应的 CSR 流程。
ETCD 备份恢复
集群的全部状态(所有资源对象、配置、密钥)都在 etcd 里,节点可以重装,etcd 数据丢了集群就没了。备份 etcd 是集群运维的第一要务。
备份命令
etcd 在 kubeadm 集群里是静态 Pod,宿主机上不一定有 etcdctl。两种方式任选:
# 方式一:宿主机装了 etcdctl
sudo ETCDCTL_API=3 etcdctl snapshot save /backup/etcd-snapshot-$(date +%Y%m%d%H%M).db \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key

# 方式二:没有 etcdctl,直接 exec 进 etcd 容器用里面的
kubectl exec -n kube-system etcd-k8s-master -- etcdctl snapshot save /tmp/snapshot.db \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key
四个参数的含义:endpoints 指定连哪个 etcd;cacert 验证服务端身份;cert 和 key 是客户端证书,证明自己有权限操作。kubeadm 集群这三样都在 /etc/kubernetes/pki/etcd/ 下,直接引用即可。
验证快照完好:
sudo ETCDCTL_API=3 etcdctl --write-out=table snapshot status /backup/etcd-snapshot-202610231000.db
+----------+----------+------------+------------+
|   HASH   | REVISION | TOTAL KEYS | TOTAL SIZE |
+----------+----------+------------+------------+
| a1b2c3d4 |    98765 |       1234 |     8.2 MB |
+----------+----------+------------+------------+
定时备份
快照备份是在线的,不影响集群运行,放心加 crontab。建议每天一次,保留最近 7 到 14 天,并同步一份到集群外的存储(对象存储、另一台机器),防止 master 磁盘整个挂掉连备份一起丢。
# crontab -e,每天凌晨 2 点备份,顺便清理 14 天前的旧备份
0 2 * * * ETCDCTL_API=3 /usr/bin/etcdctl snapshot save /backup/etcd-$(date +\%Y\%m\%d).db --endpoints=https://127.0.0.1:2379 --cacert=/etc/kubernetes/pki/etcd/ca.crt --cert=/etc/kubernetes/pki/etcd/server.crt --key=/etc/kubernetes/pki/etcd/server.key
15 2 * * * find /backup -name "etcd-*.db" -mtime +14 -delete
快照只含 etcd 数据。恢复集群还需要 /etc/kubernetes/pki/ 下的 CA 证书,建议把这个目录也一起备份(tar 打包即可,注意权限保密)。
恢复(单控制平面示例)
恢复是把快照数据灌回一个全新的 etcd 数据目录。期间 apiserver 必须停掉:
# 1. 移走静态 Pod 清单,kubelet 会停掉 apiserver 和 etcd
sudo mv /etc/kubernetes/manifests /etc/kubernetes/manifests.bak

# 2. 从快照恢复出新数据目录
sudo ETCDCTL_API=3 etcdctl snapshot restore /backup/etcd-snapshot-202610231000.db \
  --data-dir=/var/lib/etcd-restore

# 3. 替换 etcd 数据目录(旧目录先留档)
sudo mv /var/lib/etcd /var/lib/etcd.bak
sudo mv /var/lib/etcd-restore /var/lib/etcd

# 4. 恢复清单,kubelet 拉起 etcd 和 apiserver
sudo mv /etc/kubernetes/manifests.bak /etc/kubernetes/manifests

# 5. 等一两分钟后验证
kubectl get nodes
stacked HA 集群里,三个 etcd 成员必须用同一个快照恢复,并且 restore 时要带 --name、--initial-cluster、--initial-advertise-peer-urls 等参数重建集群成员关系。只恢复一个成员、其余成员还带着旧数据,集群会脑裂。多成员恢复流程较长,动手前先读官方文档「Restoring an etcd cluster」。
节点扩容
业务量涨了,加一台 worker 是常规操作。流程就是「装环境 + join」:
# 1. 新节点(k8s-node3,172.16.1.13)按「kubeadm」一节的前三步准备好:
#    系统准备 → 装 containerd(记得改 SystemdCgroup 和 sandbox_image)→ 装 kubelet/kubeadm
#    版本和集群保持一致

# 2. 在 master 上重新生成 join 命令(token 有效期 24 小时,过期重新生成)
kubeadm token create --print-join-command
kubeadm join 172.16.1.10:6443 --token 7f3a2b.c9d8e1f0a1b2c3d4 --discovery-token-ca-cert-hash sha256:3b5a5c...(省略)
# 3. 在新节点上执行(补上 cri-socket)
sudo kubeadm join 172.16.1.10:6443 --token 7f3a2b.c9d8e1f0a1b2c3d4 \
  --discovery-token-ca-cert-hash sha256:3b5a5c...(省略) \
  --cri-socket=unix:///run/containerd/containerd.sock

# 4. 回 master 验证
kubectl get nodes
# 可选:给节点打个 worker 标签,让 ROLES 列好看点
kubectl label node k8s-node3 node-role.kubernetes.io/worker=
HA 集群里加控制平面节点,join 时加 --control-plane --certificate-key,证书 key 过期的话先在 master 上用 sudo kubeadm init phase upload-certs --upload-certs 重新上传生成。
节点缩容
缩容(下线节点)比扩容讲究,绝不能直接关机释放,否则节点一直挂在 NotReady,被驱逐的 Pod 没人重建,控制平面节点还会拖垮 etcd quorum。标准流程是「先 drain,再 delete」:
# 1. 驱逐节点上的业务 Pod(Pod 会被调度到其他节点重建)
kubectl drain k8s-node2 --ignore-daemonsets --delete-emptydir-data

# 2. 从集群中删除节点记录
kubectl delete node k8s-node2

# 3. 在被下线的节点上清理现场,归还一台干净的机器
sudo kubeadm reset --cri-socket unix:///run/containerd/containerd.sock
sudo rm -rf /etc/cni/net.d $HOME/.kube
两个 drain 参数的含义:
| 参数 | 作用 |
|---|---|
--ignore-daemonsets | DaemonSet 的 Pod(calico-node、kube-proxy 等)驱逐不掉,只能忽略 |
--delete-emptydir-data | 连使用 emptyDir 的 Pod 一起删(emptyDir 数据随 Pod 删除丢失,确认能接受再用) |
旧版本这个参数叫 --delete-local-data,1.20 之后改名。
如果是 stacked etcd 的 HA 集群要下线一台 master,必须先从 etcd 集群里移除它的成员身份,否则剩下的 etcd 会一直等它投票:
kubectl exec -n kube-system etcd-k8s-master -- etcdctl member list \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key

# 找到待下线节点的 member ID,然后
kubectl exec -n kube-system etcd-k8s-master -- etcdctl member remove <成员ID> \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key
摘完成员再走 drain、delete、reset 流程。
Node Maintenance
节点要升级内核、打补丁、换硬件,就得进入维护状态。kubectl 提供三个命令管理节点的可调度性,经常混,先分清楚:
| 命令 | 作用 | 对已有 Pod 的影响 |
|---|---|---|
kubectl cordon <节点> | 标记为不可调度 | 无影响,已运行的 Pod 原地不动,新 Pod 不会再调度上来 |
kubectl drain <节点> | 驱逐节点 | 先 cordon,再把节点上的业务 Pod 优雅驱逐走(在其他节点重建) |
kubectl uncordon <节点> | 恢复调度 | 无影响,只是重新允许新 Pod 调度上来 |
典型维护操作序列:
# 1. 驱逐业务(drain 自带 cordon,不用先单独 cordon)
kubectl drain k8s-node1 --ignore-daemonsets --delete-emptydir-data

# 2. 确认业务 Pod 已在其他节点 Running
kubectl get pods -A -o wide | grep k8s-node1

# 3. 做维护:升级内核、打补丁、重启、换硬件……
sudo apt-get upgrade -y
sudo reboot

# 4. 机器回来后恢复调度
kubectl uncordon k8s-node1

# 5. 验证节点 Ready
kubectl get nodes
- PDB(PodDisruptionBudget):如果业务配了 PDB 且剩余副本不满足要求,drain 会卡在驱逐那一步。这是 PDB 在保护你,别直接上
--force硬闯,先看kubectl get pdb确认是不是副本数不够。 - 裸 Pod:不受任何控制器管理的 Pod(直接用 kubectl run 出来的)被驱逐后不会自动重建,drain 会警告并跳过,需要
--force才删,删了就没了。
Cluster 生命周期管理
把前面所有内容串起来,一个集群从生到死的完整生命周期和各阶段要点:
| 阶段 | 关键动作 | 对应章节 |
|---|---|---|
| 规划 | 定规模、选 HA 拓扑、规划网段(Pod/Service/宿主机不冲突)、选版本 | 高可用架构 |
| 创建 | 系统准备、装运行时、init/join、装 CNI、验证 Ready | kubeadm、containerd |
| 接入业务 | 部署应用、配 ingress、配监控告警、备首个 etcd 快照 | — |
| 日常运维 | 定时备份 etcd、巡检证书有效期、监控节点资源 | ETCD 备份恢复、证书更新 |
| 升级 | 备份 → 逐 minor 升控制平面 → 逐台升 worker → 验证插件 | 集群升级 |
| 扩容 | 新节点装环境、生成 token、join、打标签 | 节点扩容 |
| 缩容/维护 | drain → 维护或 delete → uncordon 或 reset | Node Maintenance、节点缩容 |
| 退役 | 迁移业务 → 最终备份归档 → 逐节点下线 → 释放资源 | 见下 |
退役(集群下线) checklist:
- 确认业务已全部迁走,DNS、LB 后端不再指向这个集群。
- 做最后一次 etcd 快照,连同
/etc/kubernetes/pki/打包归档到集群外(合规要求下备份要保留若干年)。 - 逐节点执行 drain、delete、
kubeadm reset清理。 - 释放虚拟机/物理机,清理 DNS 记录、负载均衡配置、监控对象、堡垒机授权。
- 销毁或归档集群的 CA 私钥——它还能签发这个集群的合法证书,泄露等于留后门。
创建靠 kubeadm,活着靠备份和巡检,长大靠 join,变老靠逐版本升级,离开前记得最后备份一次。