存储系统
容器本身的文件系统是临时的:容器一删,里面写的数据就没了。Docker 系列里我们用 volume 和 bind mount 解决单机持久化,到了 Kubernetes 问题更复杂——Pod 会重建、会被调度到别的节点,数据必须能「跟着走」。这篇从最简单的 Pod 级 Volume 讲起,一路到 PV/PVC、StorageClass 动态供给、CSI 插件体系,最后用一个完整可跑的 StatefulSet 示例收尾。
Volume
K8s 的 Volume 和 Docker 的 volume 名字像、用法像,但最核心的差异在生命周期归属:
| 对比项 | Docker volume | Kubernetes Volume |
|---|---|---|
| 生命周期归属 | 独立于容器,容器删了 volume 还在 | 跟着 Pod 走:Pod 在卷就在,Pod 删卷就删 |
| 容器重启 | 重新挂载即可 | 同一 Pod 内的容器崩溃重启,卷里的数据原样保留 |
| 管理方 | Docker Engine | kubelet(在节点上创建和挂载) |
| 数据持久化 | 落在宿主机目录,天然持久 | 取决于卷类型:emptyDir 随 Pod 消失,持久化要靠 PV/PVC |
一句话:K8s Volume 的生命周期跟 Pod 走,不跟容器走。Pod 里的容器无论重启多少次,看到的都是同一份卷;但只要 Pod 没了(删除、驱逐、节点故障后重建),emptyDir 这类 Pod 级卷就随之消失。想让数据跨过 Pod 重建仍然存在,就得用后面的 PV/PVC 体系,把存储的生命周期从 Pod 上解耦出去。
常用卷类型速查:
| 类型 | 生命周期 | 典型用途 |
|---|---|---|
| emptyDir | 跟 Pod | 临时缓存、Pod 内容器间共享目录 |
| hostPath | 跟节点 | 系统级 agent 读写宿主机文件(日志、监控) |
| configMap / secret | 跟 Pod | 把配置、密钥以文件形式注入容器 |
| downwardAPI / projected | 跟 Pod | 把 Pod 自身信息、多来源数据投射成文件 |
| nfs | 独立于 Pod | 多节点共享的网络存储 |
| persistentVolumeClaim | 独立于 Pod | 对接 PV/PVC 体系,业务数据持久化的标准做法 |
| csi | 独立于 Pod | 直接引用 CSI 驱动提供的卷(一般较少直接用) |
emptyDir
emptyDir 是最简单的卷:Pod 被调度到节点时,kubelet 在节点上创建一个空目录挂进 Pod(「empty」就是指初始为空)。它有两个要点:
- Pod 级共享:同一个 Pod 里的多个容器可以同时挂载同一个 emptyDir,是容器间共享文件的标准方式(比如主容器写日志、Sidecar 收集日志)。
- 随 Pod 生灭:容器崩溃重启,emptyDir 数据还在;但 Pod 被删除、驱逐或在其他节点重建,emptyDir 就彻底消失,不可恢复。
一个两容器共享 emptyDir 的例子:
apiVersion: v1
kind: Pod
metadata:
  name: cache-demo
spec:
  containers:
    - name: writer
      image: busybox:1.36
      command: ['sh', '-c', 'while true; do date >> /cache/tick.log; sleep 5; done']
      volumeMounts:
        - name: cache
          mountPath: /cache
    - name: reader
      image: busybox:1.36
      command: ['sh', '-c', 'while true; do tail -n 3 /cache/tick.log; sleep 10; done']
      volumeMounts:
        - name: cache
          mountPath: /cache
  volumes:
    - name: cache
      emptyDir: {}
注意 volumes 定义在 Pod 层(和 containers 平级),容器里用 volumeMounts 按名字引用——这是所有卷类型的通用写法,后面不再重复说明。
medium: Memory 内存盘
把 medium 设为 Memory,emptyDir 就从节点磁盘变成 tmpfs 内存盘:
  volumes:
    - name: cache
      emptyDir:
        medium: Memory
        sizeLimit: 256Mi
读写速度极快,适合对 IO 敏感的临时数据。但代价是:
- 占用的是节点内存,而且计入容器的内存用量——写太多会把容器顶到 memory limit,触发 OOMKilled。
- 建议配合
sizeLimit限定上限。 - 节点重启,内存盘内容自然清空(反正它本来就活不过 Pod)。
只放「丢了不心疼」的数据:缓存、临时计算空间、checkpoint、容器间传递文件。凡是需要持久化的业务数据,直接跳到本篇的 PV/PVC 部分。
hostPath
hostPath 把节点文件系统上的文件或目录直接挂进 Pod,相当于 K8s 版的 bind mount:
apiVersion: v1
kind: Pod
metadata:
  name: hostpath-demo
spec:
  containers:
    - name: app
      image: busybox:1.36
      command: ['sh', '-c', 'ls /host-logs | head; sleep 3600']
      volumeMounts:
        - name: host-logs
          mountPath: /host-logs
          readOnly: true
  volumes:
    - name: host-logs
      hostPath:
        path: /var/log
        type: Directory
type 字段控制挂载前的检查行为:
| type 取值 | 行为 |
|---|---|
| DirectoryOrCreate | 目录不存在就自动创建(权限 0755),存在则直接使用 |
| Directory | 目录必须已存在,否则 Pod 启动失败 |
| FileOrCreate | 文件不存在就自动创建(权限 0644),存在则直接使用 |
| File | 文件必须已存在 |
| Socket | UNIX socket 必须已存在 |
| CharDevice | 字符设备必须已存在 |
| BlockDevice | 块设备必须已存在 |
建议始终显式写 type:不写就等同于「不检查」,路径不存在或类型不符时要到容器读写时才报错,排查很绕。
hostPath 有两大硬伤。一是数据绑死在节点上:Pod 重新调度到别的节点,同名路径下是另一份内容,多副本应用每个副本看到的数据都不一样。二是安全风险大:挂载 docker.sock、containerd.sock 或根目录这类路径,等于把节点 root 权限拱手让给容器,容器逃逸直奔宿主机。
它合理的场景基本只有 DaemonSet 形态的系统组件:日志采集器读 /var/log、监控 agent 读 /proc、/sys,CNI/CSI 插件管理节点目录。业务应用的持久化数据不要用 hostPath,单节点学习集群(kind、minikube)里凑合用一下可以,生产环境请走 PV/PVC。
ConfigMap Volume
ConfigMap 除了以环境变量注入,更常用的方式是挂载为卷:每个 key 变成挂载目录下的一个文件,value 是文件内容。
先准备一个 ConfigMap,再挂进 Pod:
apiVersion: v1
kind: ConfigMap
metadata:
  name: app-config
data:
  app.properties: |
    server.port=8080
    log.level=info
  welcome.txt: |
    hello kubernetes
---
apiVersion: v1
kind: Pod
metadata:
  name: config-demo
spec:
  containers:
    - name: app
      image: busybox:1.36
      command: ['sh', '-c', 'while true; do cat /etc/config/app.properties; sleep 30; done']
      volumeMounts:
        - name: config
          mountPath: /etc/config
  volumes:
    - name: config
      configMap:
        name: app-config
容器里会看到 /etc/config/app.properties 和 /etc/config/welcome.txt 两个文件。卷定义里还可以用 items 只挑部分 key、自定义文件名,用 defaultMode 指定文件权限(默认 0644)。
更新传播有延迟
修改 ConfigMap 之后,已挂载到 Pod 里的文件会自动更新,但不是即时的。延迟来自两段:kubelet 的 Pod 同步周期(默认 1 分钟),加上 kubelet 内部 ConfigMap 缓存的 TTL(默认也是 1 分钟),所以最坏情况下要等约两分钟才能看到新内容(新版本 kubelet 改用 watch 缓存后延迟明显缩短,但仍非实时)。
另外两个容易忽略的点:
- 应用要重新读文件才生效。很多程序只在启动时读一次配置,文件更新了它也不知道,需要程序自己 watch 文件变化,或者干脆滚动重启 Pod。
- 以环境变量注入的 ConfigMap 完全不更新,只能重建 Pod。
subPath 挂载不自动更新的经典坑
如果只想要 ConfigMap 里的某一个文件,常见写法是用 subPath 挂单个文件:
      volumeMounts:
        - name: config
          mountPath: /etc/nginx/nginx.conf
          subPath: nginx.conf
坑在于:用 subPath 挂载的文件,ConfigMap 更新后内容不会跟着变。原因是整目录挂载时,K8s 通过符号链接的原子切换来推送更新;而 subPath 是对单个文件做 bind mount,绕开了这套机制,文件被「钉死」在旧版本上。
要么挂载整个目录(不用 subPath),让应用从目录里读文件;要么接受「更新配置就滚动重启 Pod」的运维方式,很多 Helm Chart 会给 Deployment 加 ConfigMap 内容的 checksum 注解,配置一变就触发重建,就是这个思路。
Secret Volume
Secret 卷和 ConfigMap 卷的用法几乎一模一样:
  volumes:
    - name: tls
      secret:
        secretName: my-tls-secret
        defaultMode: 0400
同样是每个 key 一个文件,同样有更新传播延迟,subPath 不更新的坑也完全一样。区别在于数据本身:
- Secret 的
data字段要求 value 是 base64 编码(也可以用stringData写明文,提交时自动编码)。注意 base64 只是编码不是加密,任何能读 Secret 的人一条命令就能解码;真正的保护靠 RBAC 限制访问,以及给 etcd 开启静态加密。 - Secret 卷在节点上用 tmpfs(内存文件系统)存储,不落盘,Pod 删除即清除,比普通目录更适合放密钥。
- 权限通常收得更紧,比如
defaultMode: 0400只允许属主读。
密码、证书这类敏感数据优先用卷挂载:环境变量会在 kubectl describe pod、crash 日志里直接暴露,卷挂载的文件则不会。配置类和密钥类数据的注入方式选择,「配置与安全」一篇还会展开。
PV
PersistentVolume(持久卷)是集群里一块真实存储在 K8s 中的抽象——背后可以是云盘、NFS 目录、Ceph 卷、本地盘。它是集群级资源,不属于任何命名空间,生命周期独立于 Pod:Pod 删了,PV 和里面的数据都还在。
一个静态创建的 NFS 类型 PV:
apiVersion: v1
kind: PersistentVolume
metadata:
  name: pv-nfs-demo
spec:
  capacity:
    storage: 10Gi
  accessModes:
    - ReadWriteMany
  persistentVolumeReclaimPolicy: Retain
  storageClassName: manual
  volumeMode: Filesystem
  nfs:
    server: 192.168.1.10
    path: /data/k8s
几个关键字段:
- capacity:容量,静态供给时就是个声明,K8s 不会帮你校验底层存储真实大小。
- volumeMode:
Filesystem(默认,格式化成文件系统挂载)或Block(裸块设备,交给应用自己用)。 - accessModes:访问模式,见下表。
- persistentVolumeReclaimPolicy:回收策略,见下文。
accessModes
| accessMode | 缩写 | 含义 |
|---|---|---|
| ReadWriteOnce | RWO | 只允许一个节点挂载读写 |
| ReadOnlyMany | ROX | 允许多个节点挂载,但只读 |
| ReadWriteMany | RWX | 允许多个节点同时挂载读写 |
| ReadWriteOncePod | RWOP | 只允许一个 Pod 挂载读写(1.29 起稳定,需要 CSI 驱动支持) |
RWO 的卷在技术上仍能被同一节点上的多个 Pod 使用,只是不能跨节点同时挂载。而且不是所有存储后端都支持全部模式:AWS EBS、各类云盘一般只支持 RWO;NFS、CephFS 才支持 RWX。选模式前先确认后端能力。
persistentVolumeReclaimPolicy
PVC 删除后,PV 和底层数据怎么处理:
| 取值 | 行为 |
|---|---|
| Retain | 保留:PV 进入 Released 状态不再可用,数据留着,由管理员手动清理后重建 PV 复用 |
| Delete | 删除:PV 连同底层存储(如云盘)一起删掉,动态供给的 PV 默认是这个策略 |
| Recycle | 已废弃:早年会清空数据后复用,早已被动态供给取代,不要再使用 |
云厂商托管 K8s 的默认 StorageClass 大多用 Delete:删 PVC 等于删云盘,数据直接没了。生产环境的重要数据,要么把策略改成 Retain,要么确保有快照备份兜底。
静态供给流程
上面这种「管理员先建好 PV」的方式叫静态供给,完整流程四步:
- 管理员准备好底层存储(比如开好 NFS 目录),创建 PV 对象。
- 用户创建 PVC,声明自己需要多大的存储。
- 控制面自动匹配合适的 PV,两者进入 Bound(绑定)状态。
- Pod 通过 PVC 引用这块存储。
静态供给的痛点很明显:每来一个存储需求都要管理员手工造 PV,规格还不一定刚好匹配。动态供给(StorageClass 一节)就是为了解决这个。
PVC
PersistentVolumeClaim(持久卷声明)是用户对存储的「申请单」:声明要多大、什么访问模式、用哪个 StorageClass,剩下的交给系统匹配。
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: data-demo
spec:
  accessModes:
    - ReadWriteMany
  resources:
    requests:
      storage: 5Gi
  storageClassName: manual
请求匹配规则
控制面给 PVC 挑 PV 时按这些规则来:
- accessModes 和 storageClassName 必须一致(PVC 不写 storageClassName 时另有规则,见 StorageClass 一节)。
- PV 容量必须大于等于请求容量;有多个满足条件的 PV 时,选容量最接近请求的(最小够用)。
- 可以再加
selector按标签精确筛选。 - 暂时没有合适的 PV,PVC 停在 Pending 状态,等到有可用 PV(或动态供给造出 PV)再自动绑定。
一对一绑定
PVC 和 PV 的绑定是一对一、独占的:一个 PVC 绑一个 PV,一个 PV 也只能被一个 PVC 绑。这带来一个反直觉的结果——即使 PV 有 10Gi 而 PVC 只要 5Gi,整个 PV 也归这个 PVC 独占,剩下的 5Gi 谁也用不了。
kubectl get pv,pvc
NAME                          CAPACITY   ACCESS MODES   RECLAIM POLICY   STATUS   CLAIM
persistentvolume/pv-nfs-demo  10Gi       RWX            Retain           Bound    default/data-demo

NAME                             STATUS   VOLUME       CAPACITY   ACCESS MODES   STORAGECLASS
persistentvolumeclaim/data-demo  Bound    pv-nfs-demo  10Gi       RWX            manual
注意 PVC 那行的 CAPACITY 显示的是 PV 的 10Gi,而不是请求的 5Gi。所以静态供给时 PV 的规格要尽量贴近实际需求,否则容量白白浪费。
Pod 里使用 PVC:
spec:
  containers:
    - name: app
      image: busybox:1.36
      command: ['sh', '-c', 'sleep 3600']
      volumeMounts:
        - name: data
          mountPath: /data
  volumes:
    - name: data
      persistentVolumeClaim:
        claimName: data-demo
从这里开始,Pod 不用再关心背后是 NFS 还是云盘——PV 描述「有什么存储」,PVC 描述「要什么存储」,两者解耦,这是整个 K8s 存储体系的核心设计。
StorageClass
StorageClass(存储类)解决静态供给的痛点:管理员不再手工造 PV,而是定义「这类存储用什么 provisioner、什么参数创建」,用户 PVC 一提交,PV 自动造出来。
动态供给流程
用户创建 PVC(指定 storageClassName)
    → StorageClass 里的 provisioner(CSI 插件)收到请求
    → provisioner 调用存储后端 API 创建真实存储(比如开一块云盘)
    → 自动创建对应的 PV 对象
    → PVC 与 PV 自动 Bound,Pod 可用
一个典型的 StorageClass:
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fast-ssd
provisioner: ebs.csi.aws.com
parameters:
  type: gp3
  fsType: ext4
reclaimPolicy: Delete
allowVolumeExpansion: true
volumeBindingMode: WaitForFirstConsumer
provisioner 字段决定由谁来造存储,各环境差别很大:
| 环境 | provisioner 示例 |
|---|---|
| AWS EBS 云盘 | ebs.csi.aws.com |
| GCE Persistent Disk | pd.csi.storage.gke.io |
| 阿里云云盘 | diskplugin.csi.alibabacloud.com |
| Ceph RBD | ceph-csi 的 rbd.csi.ceph.com |
| 本地盘(学习、边缘场景) | Rancher local-path-provisioner |
| NFS 目录 | nfs.csi.k8s.io 或 nfs-subdir-external-provisioner |
parameters 下的参数完全由 provisioner 自己定义(云盘类型、文件系统、IOPS 档位等),写之前要查对应驱动的文档。
默认 StorageClass
集群可以打一个「默认 StorageClass」的标记(注解 storageclass.kubernetes.io/is-default-class: "true",kind、minikube 等学习集群出厂就有)。它带来一条重要规则:
- PVC 不写
storageClassName→ 自动使用默认 SC,走动态供给。 - PVC 写
storageClassName: ""(空字符串)→ 明确禁用动态供给,只匹配同样没有 class 的静态 PV。
这两个行为完全不同,是经典踩坑点:本想用静态 PV,结果忘了写空字符串,PVC 被默认 SC 接走造了个新 PV。
kubectl get sc
NAME                 PROVISIONER             RECLAIMPOLICY   VOLUMEBINDINGMODE      ALLOWVOLUMEEXPANSION
local-path (default) rancher.io/local-path   Delete          WaitForFirstConsumer   false
volumeBindingMode: WaitForFirstConsumer
volumeBindingMode 有两个取值,默认 Immediate:PVC 一创建,PV 立刻供给并绑定。对本地盘类存储,这个默认值会惹祸:
- PV 在 PVC 创建时就造好,比如落在了 A 节点的磁盘上。
- 之后 Pod 调度时却被分配到了 B 节点。
- 卷在 A、Pod 在 B,拓扑永远不满足,Pod 卡在 Pending 动弹不得。
WaitForFirstConsumer 把供给和绑定延迟到有 Pod 引用这个 PVC 时才执行:调度器先选好节点,provisioner 再在那个节点上创建存储,从根上消除「盘和人分居两地」。多可用区的云盘同理——不用它,盘可能建错了可用区。
本地盘(local-path-provisioner 等)必须用 WaitForFirstConsumer;跨可用区的云盘强烈推荐用;单可用区的网络存储用 Immediate 也没问题。
CSI
CSI(Container Storage Interface)是 K8s 定义的存储插件标准接口,如今所有存储对接都走它。一套典型的 CSI 驱动在集群里分两侧部署:Controller 侧以 Deployment 形式运行,Pod 里除了厂商自己的 driver 容器,还配着几个官方出品的 sidecar——external-provisioner 负责 watch PVC 并调用 driver 的 CreateVolume 造卷、external-attacher 负责把卷 attach 到节点、external-snapshotter 负责快照、external-resizer 负责扩容;Node 侧以 DaemonSet 形式跑在每个节点上,node-driver-registrar 负责把驱动注册给 kubelet,driver 的 node 容器负责在节点上把卷格式化、挂载进 Pod 的目录。kubelet 本身不懂任何存储实现,全部通过 CSI 的 gRPC 接口调用驱动,各 sidecar 也是通用组件,驱动作者只需要实现接口规定的几个方法。
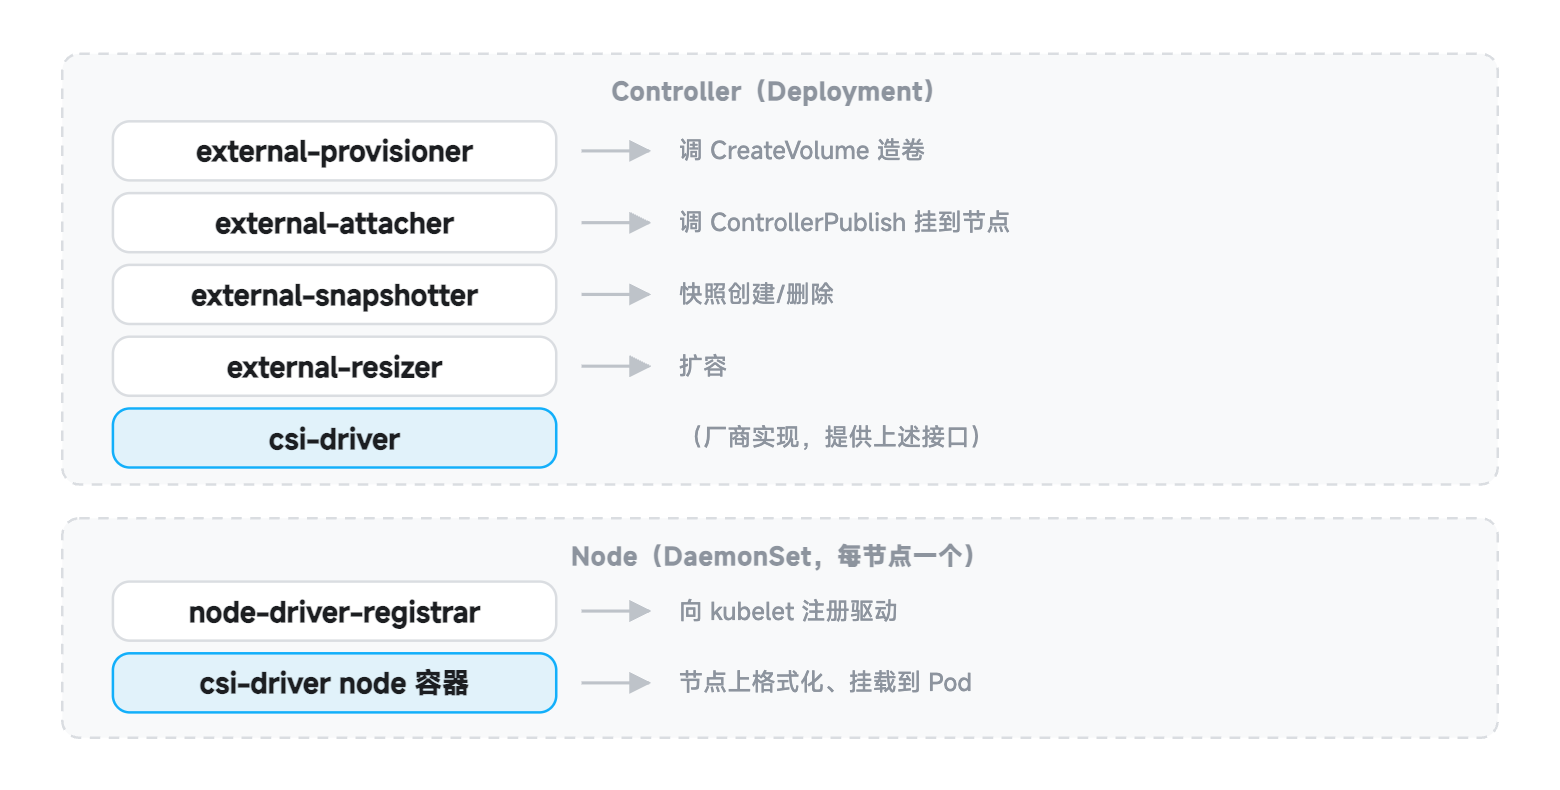
早年的存储插件(AWS EBS、GCE PD、OpenStack Cinder……)代码直接写在 K8s 核心仓库里,叫 in-tree 插件。问题随之而来:每支持一个新存储就要改 K8s 源码、跟着 K8s 的发版节奏走,bug 修复也要等大版本发布,核心仓库越来越臃肿。CSI 把存储实现整体移到核心之外(out-of-tree):厂商在自己的仓库里维护驱动、按自己的节奏发版,K8s 核心只保留接口。in-tree 插件从 1.26 起陆续删除,到 1.31 前后基本清完。对用户来说变化是透明的——PV/PVC 的用法不变,只是 provisioner 名字从 kubernetes.io/aws-ebs 变成了 ebs.csi.aws.com。
Snapshot
K8s 的卷快照体系由三个对象组成,和 PV 体系一一对应:
| 快照体系 | 对应 PV 体系 | 角色 |
|---|---|---|
| VolumeSnapshot | PVC | 用户侧的「快照申请」,指定给哪个 PVC 打快照 |
| VolumeSnapshotContent | PV | 集群侧实际的快照资源,指向底层存储的真实快照 |
| VolumeSnapshotClass | StorageClass | 定义用哪个 CSI 驱动、删除策略等参数 |
前提是 CSI 驱动支持快照,且集群里装了快照相关的 CRD 和 snapshot-controller(主流发行版和托管集群一般自带)。
给 PVC 打快照:
apiVersion: snapshot.storage.k8s.io/v1
kind: VolumeSnapshot
metadata:
  name: data-demo-snapshot
spec:
  volumeSnapshotClassName: csi-snapclass
  source:
    persistentVolumeClaimName: data-demo
从快照恢复 PVC
恢复靠新 PVC 的 dataSource 字段指向快照:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: data-restored
spec:
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 5Gi
  storageClassName: fast-ssd
  dataSource:
    apiGroup: snapshot.storage.k8s.io
    kind: VolumeSnapshot
    name: data-demo-snapshot
要点:
- 恢复出的 PVC 容量不能小于快照来源的 PVC。
- 常见用途:备份恢复、故障前存档、给数据分析复制一份生产数据的副本。
- 快照是否「崩溃一致」(应用层面的数据完整性)取决于应用本身,对数据库类应用,打快照前最好先 flush 或停写。
Clone
克隆比快照更直接:新 PVC 的 dataSource 指向同命名空间下已有的 PVC,新卷拿到源卷的一份完整副本:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: data-demo-clone
spec:
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 5Gi
  storageClassName: fast-ssd
  dataSource:
    apiGroup: ""
    kind: PersistentVolumeClaim
    name: data-demo
要点:
- 需要 CSI 驱动支持克隆能力,主流驱动(云盘、Ceph 等)基本都支持。
- 写法和快照恢复几乎一样,区别在于
kind是 PersistentVolumeClaim,且apiGroup是空字符串""(核心 API 组)。 - 只能克隆同命名空间的 PVC;请求容量必须大于等于源 PVC。
- 克隆出的卷和源卷从此完全独立,互不影响,适合「复制一份数据做实验」「给测试环境造数据」这类场景。
Volume Expansion
业务跑着跑着盘不够用了,K8s 支持在线扩容 PVC,不用重建 Pod。
前提两个:StorageClass 里设了 allowVolumeExpansion: true,且 CSI 驱动支持扩容(支持列表见各驱动文档,主流云盘和 Ceph 都支持)。
操作就是改大 PVC 的请求容量——只能改大,不能改小:
kubectl patch pvc data-demo --type merge -p '{"spec":{"resources":{"requests":{"storage":"20Gi"}}}}'
扩容分两层:先扩底层块设备,再扩上面的文件系统。观察进度:
kubectl describe pvc data-demo
Conditions:
  Type                      Status  Reason
  ----                      ------  ------
  FileSystemResizePending   True    Waiting for user to (re-)start a pod to finish file system resize of volume on node.
在线扩容的条件
- 1.27 起「卷正在使用中也能扩」成为稳定特性:块设备扩完后,文件系统在 Pod 不重启的情况下在线扩完。旧版本或驱动不支持时,会停在
FileSystemResizePending状态,等 Pod 重启才完成文件系统扩容。 - 文件系统得支持在线扩容:ext4、xfs 都可以(这也是云盘默认用它们的原因)。
volumeMode: Block的块设备卷没有文件系统这一层,块设备扩完即完成。- 扩容不可逆,云盘类后端还会立刻按新容量计费,扩之前想清楚。
验证结果:
kubectl get pvc data-demo
kubectl exec redis-0 -- df -h /data
容量字段变成新值、df 看到的文件系统也变大,才算整个流程走完。
Stateful 数据实践
把前面所有东西串起来的终极场景:有状态应用。需求很典型——每个副本要有自己独立、稳定的存储,Pod 挂了重建数据不丢。这正是 StatefulSet 的 volumeClaimTemplates 干的事:为每个副本按模板自动创建一个 PVC。
一份完整可运行的 Redis 示例(依赖集群有默认 StorageClass,kind、minikube 都满足):
apiVersion: v1
kind: Service
metadata:
  name: redis
  labels:
    app: redis
spec:
  clusterIP: None
  ports:
    - port: 6379
      name: redis
  selector:
    app: redis
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: redis
spec:
  serviceName: redis
  replicas: 3
  selector:
    matchLabels:
      app: redis
  template:
    metadata:
      labels:
        app: redis
    spec:
      containers:
        - name: redis
          image: redis:7.2
          ports:
            - containerPort: 6379
          volumeMounts:
            - name: data
              mountPath: /data
  volumeClaimTemplates:
    - metadata:
        name: data
        labels:
          app: redis
      spec:
        accessModes:
          - ReadWriteOnce
        resources:
          requests:
            storage: 1Gi
创建并观察:
kubectl apply -f redis-sts.yaml
kubectl get pods -l app=redis -w
NAME      READY   STATUS    RESTARTS   AGE
redis-0   1/1     Running   0          40s
redis-1   1/1     Running   0          35s
redis-2   1/1     Running   0          30s
kubectl get pvc
NAME           STATUS   VOLUME                                     CAPACITY   STORAGECLASS
data-redis-0   Bound    pvc-1a2b3c4d-0001                          1Gi        local-path
data-redis-1   Bound    pvc-1a2b3c4d-0002                          1Gi        local-path
data-redis-2   Bound    pvc-1a2b3c4d-0003                          1Gi        local-path
PVC 随 Pod 名稳定
注意 PVC 的命名规则:模板名-StatefulSet名-序号,于是 redis-0 永远绑定 data-redis-0,redis-1 永远绑定 data-redis-1。这份绑定关系写进了设计的骨子里:
- Pod 被删除重建(哪怕漂移到别的节点),新的
redis-0挂的还是data-redis-0,数据原样回来。 - 缩容时 Pod 按序号从大到小删除,PVC 保留;之后重新扩容,
redis-2回来时发现data-redis-2还在,直接挂回旧数据。
亲手验证一下「删 Pod 不丢数据」:
# 写入一个 key 并强制落盘
kubectl exec redis-0 -- redis-cli set hello k8s
kubectl exec redis-0 -- redis-cli save

# 删掉 redis-0,等 StatefulSet 自动重建
kubectl delete pod redis-0

# 重建后再读
kubectl exec redis-0 -- redis-cli get hello
"k8s"
删 Pod 不删 PVC 的设计
这里有个刻意的安全设计:删 Pod 不删 PVC,甚至删掉整个 StatefulSet,PVC 也依然保留。StatefulSet 控制器不替用户做「删数据」这种不可逆的决定——副本数可以随便调,数据必须由人显式清理。真要删干净,得自己动手:
kubectl delete statefulset redis
kubectl delete pvc -l app=redis
(PVC 上的 app=redis 标签来自上面 volumeClaimTemplates 里 metadata.labels 的声明,不声明就只能按名字逐个删。)
Pod 内的临时数据用 emptyDir;配置密钥用 ConfigMap/Secret 卷;业务持久化数据走 PV/PVC,生产上几乎总是配合 StorageClass 动态供给;有状态应用交给 StatefulSet 加 volumeClaimTemplates,让「稳定的网络标识 + 稳定的存储」成对出现。