监控、日志与可观测性
前面几篇把集群搭建、工作负载、网络、存储都过了一遍。集群跑起来之后,下一个绕不开的问题就是可观测性(Observability):集群现在什么状态?哪里出了问题?为什么这个 Pod 起不来?
云原生语境下,可观测性靠三根支柱撑着:Metrics(指标)、Logs(日志)、Traces(链路追踪),外加 K8s 特有的 Event(事件)。这篇把围绕它们的主流工具串一遍——Metrics Server、Prometheus、Alertmanager、Grafana、Loki、OpenTelemetry、Vector、Filebeat、cAdvisor——看完能对整套体系有个全景认识,知道每个组件解决什么问题、彼此怎么配合。
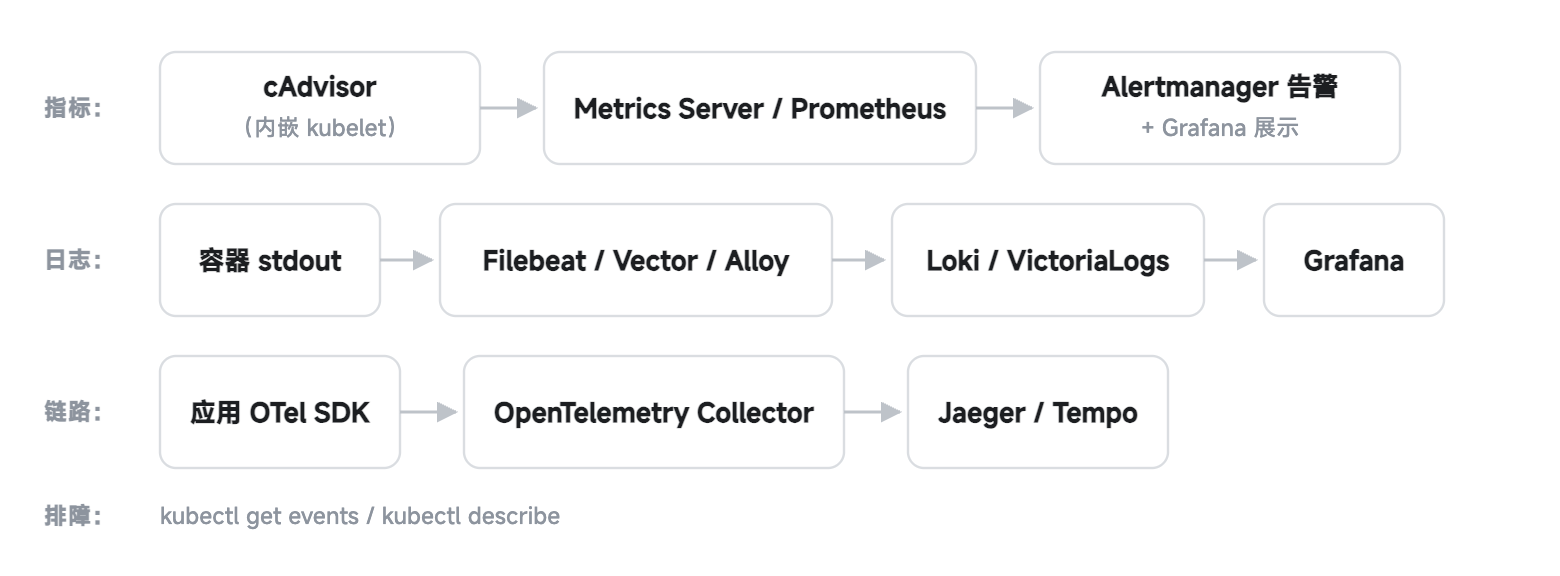
Metrics Server
Metrics Server 是 K8s 官方**资源指标管道(resource metrics pipeline)**里的汇总组件,专门采集一类数据:资源实际用量——节点和 Pod 的 CPU、内存当前用了多少。
数据链路如下:
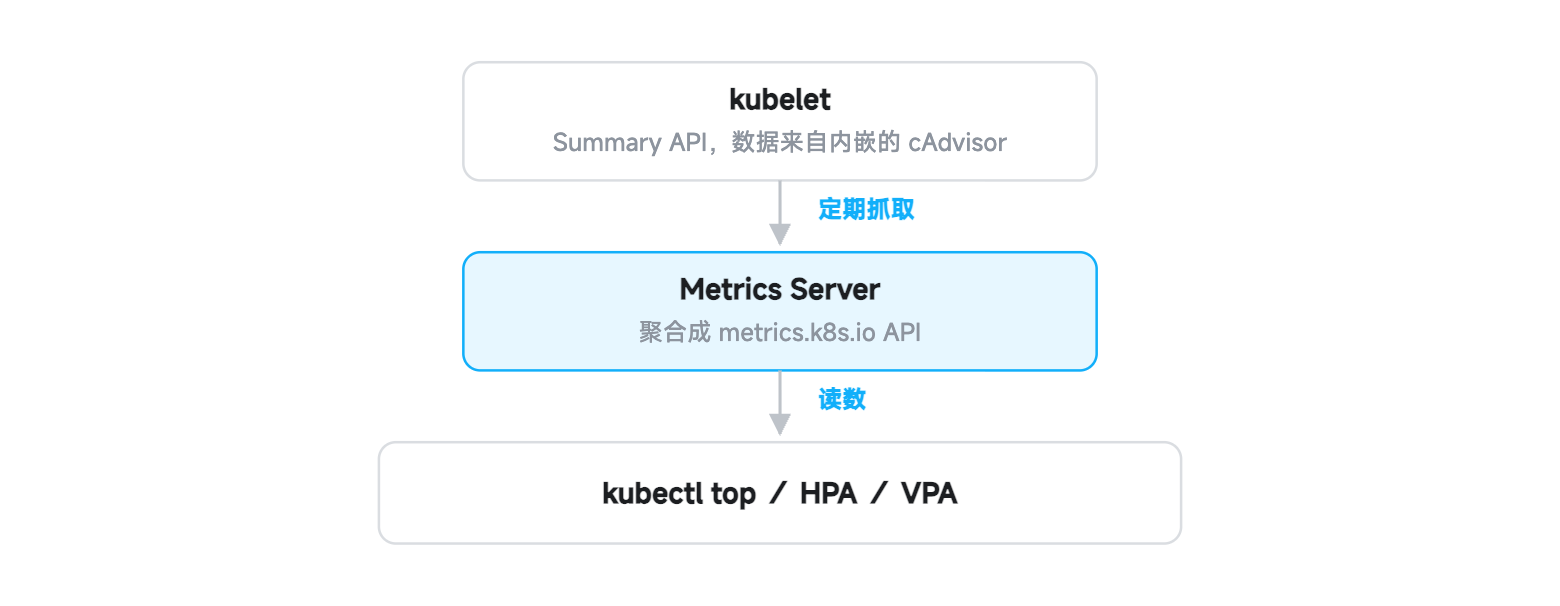
最常依赖它的两个功能:
kubectl top:人肉查看节点和 Pod 的资源用量。- HPA(Horizontal Pod Autoscaler):按 CPU/内存利用率自动增减副本数,它判断「当前利用率」的数据就来自 Metrics Server。没装 Metrics Server,HPA 直接不工作。
安装很简单,官方提供了一个 YAML:
kubectl apply -f https://github.com/kubernetes-sigs/metrics-server/releases/latest/download/components.yaml
测试集群(kind、minikube、kubeadm 自建)里 kubelet 用的是自签证书,Metrics Server 默认校验 TLS,抓取时会报 x509 错误。解决办法是给它加 --kubelet-insecure-tls 参数,跳过对 kubelet 证书的校验:
kubectl patch deployment metrics-server -n kube-system --type='json' \
  -p='[{"op":"add","path":"/spec/template/spec/containers/0/args/-","value":"--kubelet-insecure-tls"}]'
--kubelet-insecure-tls 会让 Metrics Server 不再校验 kubelet 证书,有中间人攻击风险,只能在学习、测试集群里用。生产集群要么给 kubelet 配可信证书,要么用 --kubelet-certificate-authority 指定 CA。
装好后验证:
kubectl top nodes
kubectl top pods -A
NAME            CPU(cores)   MEMORY(bytes)
control-plane   158m         1496Mi
node-1          96m          1024Mi
node-2          87m          960Mi
Metrics Server 只在内存里保存当前值,不存历史、不做告警。想要历史曲线和告警能力,得靠后面的 Prometheus 体系。
kube-state-metrics
kube-state-metrics(常简写 KSM)关注的不是「资源用了多少」,而是「对象是什么状态」。它监听 API Server 里的各种资源对象,把它们的状态翻译成 Prometheus 格式的指标暴露出来:
- Deployment:期望几个副本、现在可用几个、滚动更新卡没卡住。
- Pod:处于哪个 Phase(Pending/Running/Failed)、重启了几次、requests/limits 配了多少。
- Node:Ready 条件是否成立、有没有 DiskPressure、可分配资源多少。
- 其他:Job 完成情况、CronJob 上次调度时间、PVC 绑定状态……
指标长这样:
kube_deployment_status_replicas{deployment="nginx",namespace="default"} 3
kube_deployment_status_replicas_available{deployment="nginx",namespace="default"} 2
kube_pod_container_status_restarts_total{namespace="default",pod="nginx-xxx",container="nginx"} 5
kube_node_status_condition{node="node-1",condition="Ready",status="true"} 1
与 Metrics Server 的区别
两个名字都带 metrics,干的活完全不同,别搞混:
| 对比项 | Metrics Server | kube-state-metrics |
|---|---|---|
| 采集内容 | CPU/内存等资源用量 | Deployment、Pod、Node 等对象状态 |
| 数据来源 | 各节点 kubelet 的 Summary API | API Server(watch 资源对象) |
| 暴露方式 | K8s 聚合 API(metrics.k8s.io) | 自身 /metrics 端点(Prometheus 格式) |
| 典型消费者 | kubectl top、HPA、VPA | Prometheus + Grafana/告警 |
| 回答的问题 | 「这个 Pod 现在用了多少 CPU」 | 「这个 Deployment 的 3 个副本是不是都健康」 |
| 历史数据 | 不保存 | 不保存(由 Prometheus 抓取后保存) |
两者是互补关系:kubectl top 和 HPA 依赖 Metrics Server,「副本数不对」「Pod 一直 Pending」这类告警依赖 kube-state-metrics。生产集群两个都是标配。
Prometheus
Prometheus 是云原生监控的事实标准,也是 CNCF 第二个毕业项目(第一个是 K8s 本身)。它是一套完整的监控系统:抓取 + 存储 + 查询 + 告警评估一体。
拉模型架构
Prometheus 最核心的设计是拉模型(Pull):由 Prometheus 按配置的间隔,主动到各目标(target)的 /metrics HTTP 端点上拉取指标,而不是等目标推过来。
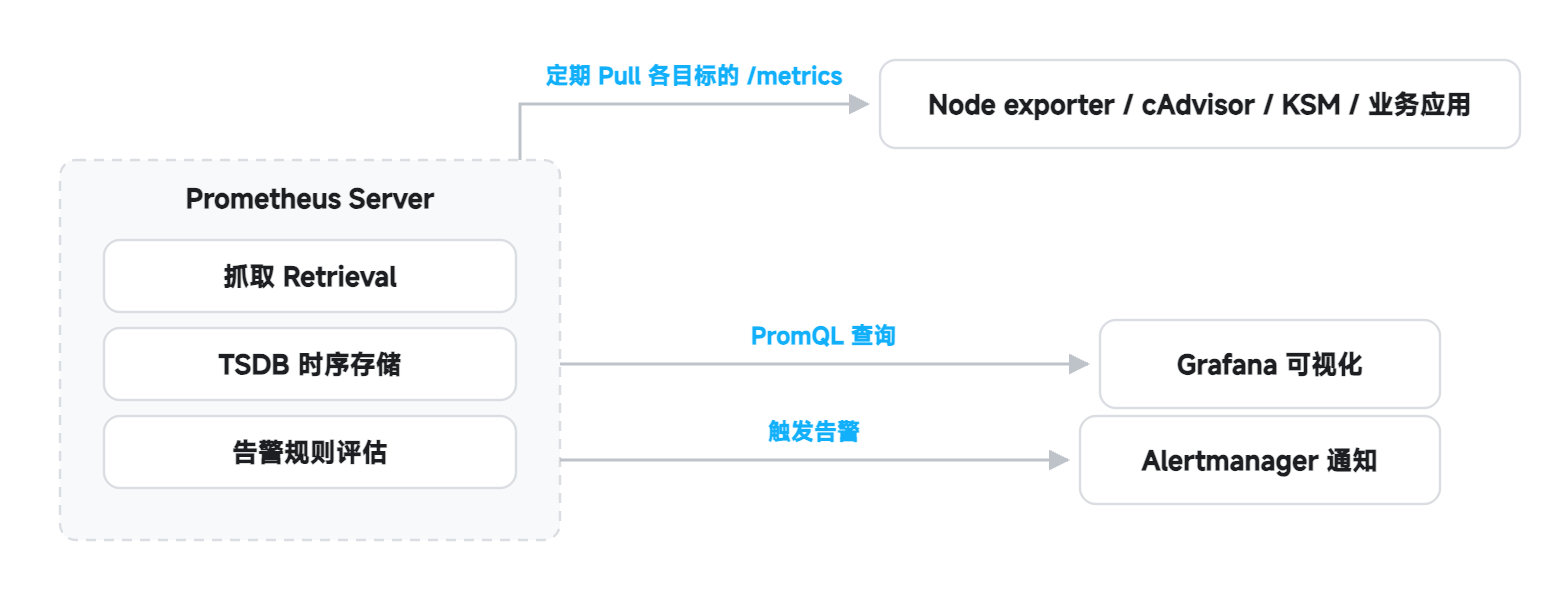
拉模型的几个好处:
- 目标挂了立刻知道:拉不到数据,
up指标直接归零,天然带健康检查。 - 配置集中:抓谁、多久抓一次都在 Prometheus 侧定义。
- 采样频率可控:不怕客户端突发推送打爆服务端。
应用怎么暴露 /metrics?三种方式:
- 自己埋点:引入对应语言的 client library(Go/Java/Python 都有),在应用里暴露
/metrics。 - 用 exporter:第三方系统(MySQL、Redis、nginx……)有现成 exporter,把它们的数据翻译成 Prometheus 格式。
- 短命任务(Job/CronJob)来不及被拉:主动推到 Pushgateway 中转。
K8s 里的服务发现
K8s 里 Pod 朝生暮死,手工维护抓取目标列表不现实。Prometheus 内置了 K8s 服务发现 kubernetes_sd_configs:通过 API Server 自动发现集群里的节点、Service、Pod、Endpoints,再配合 relabel_configs 筛选、改写标签,生成抓取目标:
scrape_configs:
  - job_name: kubernetes-pods
    kubernetes_sd_configs:
      - role: pod               # 自动发现所有 Pod
    relabel_configs:
      # 只抓带 prometheus.io/scrape: "true" 注解的 Pod
      - source_labels: [__meta_kubernetes_pod_annotation_prometheus_io_scrape]
        action: keep
        regex: "true"
这样新起一个 Pod,只要打了约定注解,就会被自动纳入监控,不用改任何配置文件。
生产推荐:prometheus-operator
手写一大坨 scrape_config 加 relabel 规则,维护成本很高。生产环境普遍用 prometheus-operator,或者干脆装 kube-prometheus-stack 这个 Helm chart 一把梭:Prometheus + Alertmanager + Grafana + kube-state-metrics + node-exporter + 一堆默认告警规则和面板全齐。
Operator 的思路是把「抓谁」也变成 K8s 资源——它定义了 ServiceMonitor、PodMonitor 等 CRD,我们声明式地描述抓取需求,Operator 监听这些对象并自动生成 Prometheus 配置。一个 ServiceMonitor 示例:
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: demo-app
  namespace: monitoring
  labels:
    release: prometheus        # 要和 Prometheus 实例的 serviceMonitorSelector 对上
spec:
  selector:
    matchLabels:
      app: demo-app            # 选中带这个标签的 Service
  endpoints:
    - port: metrics            # Service 中名为 metrics 的端口
      interval: 30s            # 抓取间隔
PodMonitor 同理,只不过直接选 Pod,适合没有对应 Service 的组件(比如 DaemonSet 形态的采集器)。配好 CR 之后,Prometheus 会自动开始抓取对应目标,全程不用重启、不用手改配置。
Alertmanager
Prometheus 负责评估告警规则、产生告警,但「怎么通知人」这件事交给了 Alertmanager。它收到告警后做四件事:
| 概念 | 解决的问题 | 一句话说明 |
|---|---|---|
| 分组 Grouping | 告警轰炸 | 把相似告警合并成一条通知,比如同一台机器上的 20 条告警合成一条 |
| 路由 Routing | 发给谁 | 按告警 label 匹配路由树,critical 发给值班,warning 发到群里 |
| 抑制 Inhibition | 重复告警 | 高级别告警触发时压掉相关的低级别告警:节点都宕了,就不必再报「该节点上某 Pod 挂了」 |
| 静默 Silence | 维护期误报 | 发布、维护窗口内按匹配器临时屏蔽一批告警,过期自动恢复 |
路由配置示例:
route:
  receiver: default              # 兜底接收器
  group_by: ['alertname', 'namespace']
  group_wait: 30s                # 新告警组等 30s 再发,凑齐同组告警
  group_interval: 5m             # 同组有新告警时的补发间隔
  repeat_interval: 4h            # 同一告警未恢复时的重复提醒间隔
  routes:
    - matchers:
        - severity="critical"
      receiver: oncall           # 严重告警走值班渠道
      continue: true             # 同时继续匹配后面的路由
    - matchers:
        - team="infra"
      receiver: infra-team       # infra 团队的告警发给对应群

receivers:
  - name: default
    webhook_configs:
      - url: http://alert-gateway:8080/alert
  - name: oncall
    webhook_configs:
      - url: http://oncall-gateway:8080/critical
  - name: infra-team
    email_configs:
      - to: infra@example.com
接收器(receiver)方面:原生支持 webhook、邮件、Slack、PagerDuty 等;钉钉、企业微信没有原生支持,一般通过 webhook 接一个转发机器人(如开源的 prometheus-webhook-dingtalk)来落地。
Grafana
Grafana 是可观测性体系的可视化层:前面采集的指标、日志,最终都在这里看图、排查。
接入数据源
Grafana 本身不存数据,靠**数据源(Data Source)**对接后端。装好后在 Connections → Data sources 里添加:
- Prometheus:URL 填集群内地址,如
http://prometheus-server.monitoring(用 kube-prometheus-stack 装的话已自动配好)。 - Loki:URL 填
http://loki.monitoring:3100,日志查询用。
添加后就可以在 Explore 里临时跑 PromQL / LogQL 查询,不建面板也能排查问题。
导入现成仪表盘
社区在 grafana.com/dashboards 上贡献了海量现成面板,复制 Dashboard ID 就能导入(Dashboards → New → Import → 填 ID)。最经典的比如 1860(Node Exporter Full),单机的 CPU/内存/磁盘/网络一个面板全看清。
K8s 监控常用的几个:
| Dashboard ID | 面板 | 用途 |
|---|---|---|
| 1860 | Node Exporter Full | 节点级 CPU/内存/磁盘/网络全景 |
| 315 | Kubernetes cluster monitoring | 老牌集群概览,简洁直观 |
| 6417 | Kubernetes Cluster (Prometheus) | 命名空间/Pod 维度的资源用量 |
| 13332 | kube-state-metrics v2 | 对象状态:副本、重启、Pending 一览 |
第三方面板可能更新或下架,ID 失效时直接去 grafana.com/dashboards 按面板名搜索同名替代品。用 kube-prometheus-stack 的话,它自带的几十块官方面板(Kubernetes / Views 系列)会自动配好,更推荐先用它们。
Loki
Loki 是 Grafana Labs 开源的日志系统,口号是「Like Prometheus, but for logs」。它为 K8s 日志场景量身设计:容器日志天然带命名空间、Pod 名、容器名这些元数据,Loki 就把这些元数据当作索引的主轴。
只索引 label,不索引全文
这是 Loki 和 ELK 最本质的区别:
- Elasticsearch:对日志正文建全文倒排索引,检索快,但索引体积大、写入开销高。
- Loki:只给 label 建索引,日志正文按块(chunk)压缩存储,不建全文索引。写入快、存储省,代价是纯粹的关键词检索要靠扫数据块。
也就是说,Loki 的查询永远是「先用 label 圈定范围,再在范围内过滤」。
LogQL 基础查询
LogQL 语法和 PromQL 一脉相承,一条查询由两部分组成:日志流选择器 + 过滤管道:
# 圈定范围:prod 命名空间、app 标签为 nginx 的全部日志
{namespace="prod", app="nginx"}

# 管道过滤:只要含 error 的行
{namespace="prod", app="nginx"} |= "error"

# 正则过滤:匹配 5xx 状态码
{namespace="prod", app="nginx"} |~ "status=5.."

# 统计:每分钟错误日志条数(指标查询)
sum(count_over_time({namespace="prod", app="nginx"} |= "error" [1m]))
采集端用官方 Alloy(或老牌的 Promtail)以 DaemonSet 跑在每个节点上,收集容器日志、按 K8s 元数据打 label 后推给 Loki,最后在 Grafana 里用 LogQL 查询。
label 是索引,别把高基数的值做成 label(比如 user_id、request_id、trace_id)。每个不同的 label 组合都是一条独立日志流,基数爆炸会把索引撑爆、把查询拖垮。这类值应该留在日志正文里,用过滤管道查。
VictoriaLogs
VictoriaLogs 是 VictoriaMetrics 团队出品的日志系统,定位是更省资源的 Loki 兼容替代品:
- 兼容 Loki 的推送 API(采集端基本不用改),查询用自己的 LogsQL,同时提供 Loki 查询接口的基础兼容。
- 同样负载下 CPU、内存、磁盘占用明显更低,官方基准里常比 Loki 省出数倍资源。
- 默认对正文建全文索引,关键词搜索比 Loki 快,算是把「索引成本」和「检索速度」的取舍往回掰了一点。
- 单二进制就能跑,小规模场景部署、运维都简单。
如果 Loki 的资源占用让你头疼,或者想要更快的关键词检索,VictoriaLogs 值得一试;Grafana 有对应的数据源插件,查询体验一致。
OpenTelemetry
前面这些工具各管一摊:metrics 用 Prometheus、logs 用 Loki、traces 用 Jaeger……每根支柱一套 SDK、一个 agent,接入和维护都很割裂。OpenTelemetry(OTel) 要解决的正是这个割裂:用一套标准统一 traces / metrics / logs 三支柱的采集。
它提供三样东西:
- 统一 SDK:各语言一套 API,应用埋点一次,三种信号都能产出。
- OTLP 协议:遥测数据的统一传输协议,与后端解耦。
- Collector:接收 → 处理 → 导出的数据管道,把遥测数据转发到任意后端(Prometheus、Loki、Jaeger、Tempo……),厂商中立。
Collector 的两种部署模式
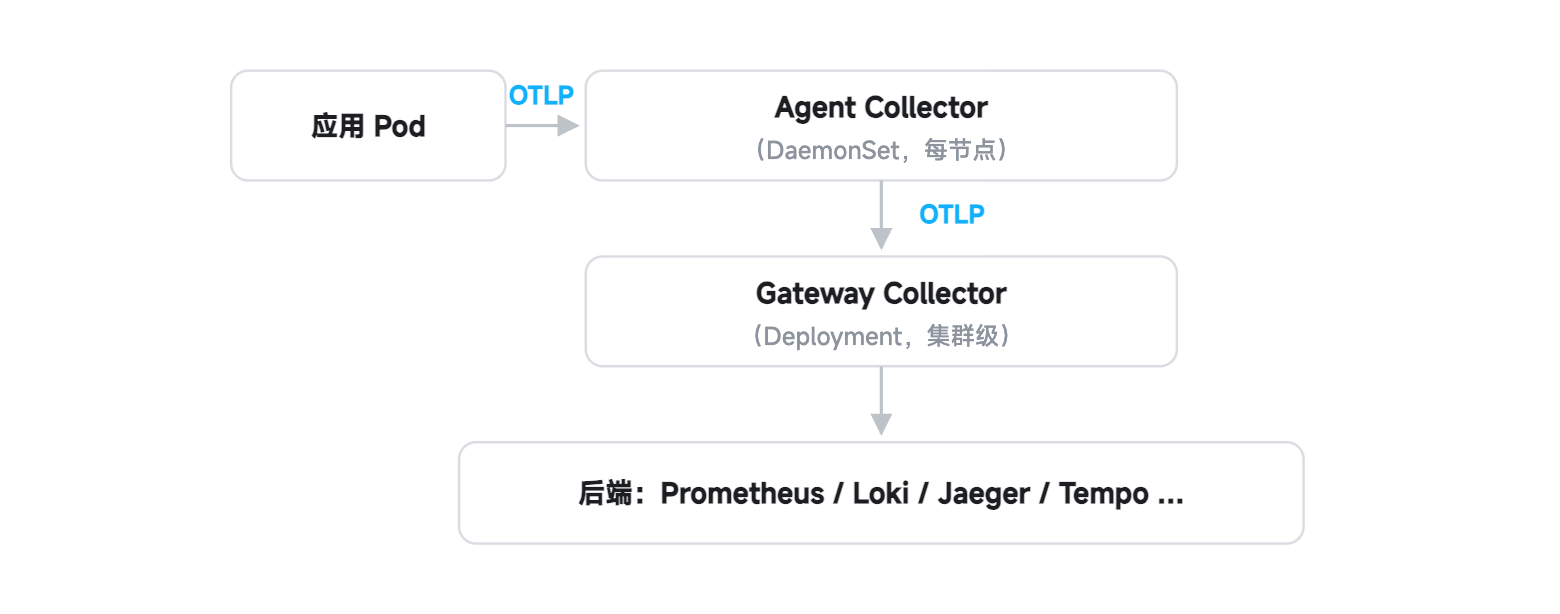
在 K8s 里,Collector(官方有 opentelemetry-operator 和 Helm chart)有两种典型部署形态,经常组合使用:
| 对比项 | Agent 模式 | Gateway 模式 |
|---|---|---|
| 部署方式 | DaemonSet,每个节点一个 | Deployment,集群级几个副本 |
| 职责 | 采集本节点数据:容器日志文件、主机指标、本机 Pod 上报的 OTLP 数据 | 汇总各 Agent 上报的数据,做跨节点处理(采样、批处理、鉴权),统一导出后端 |
| 好处 | 靠近数据源,能直接读本机日志文件 | 出口统一,后端凭据集中管理 |
新建系统的遥测接入,直接按 OpenTelemetry 标准埋点和采集是目前社区的主流方向,避免被单一厂商的数据格式绑死。
Vector
Vector 是 Datadog 开源的高性能数据采集管道,用 Rust 编写,主打快、省内存,一个工具同时收 logs 和 metrics。K8s 里一般以 DaemonSet 部署(官方有 Helm chart),是节点日志采集的新派选择。
三段式配置:sources / transforms / sinks
Vector 的配置就是一条数据管道,由三种组件拼接:
- sources:数据从哪进来(
kubernetes_logs、文件、socket……)。 - transforms:中间怎么处理(过滤、解析字段、改写、采样,用内置的 VRL 语言)。
- sinks:处理完发到哪(Loki、Elasticsearch、Kafka、S3……)。
每个组件起个名字,用 inputs 把上游组件串起来,管道就成型了:
sources:
  kubernetes_logs:                 # 采集本节点容器日志
    type: kubernetes_logs

transforms:
  only_prod:                       # 只保留 prod 命名空间的日志
    type: filter
    inputs: [kubernetes_logs]
    condition: .kubernetes.pod_namespace == "prod"

sinks:
  to_loki:                         # 发到 Loki,并打上标签
    type: loki
    inputs: [only_prod]
    endpoint: http://loki.monitoring:3100
    labels:
      namespace: "{{ kubernetes.pod_namespace }}"
      app: "{{ kubernetes.pod_labels.app }}"
数据流向一目了然:kubernetes_logs → only_prod → to_loki。
Filebeat
Filebeat 是 Elastic 家的老牌日志采集器,ELK 链路的第一环:Filebeat →(Logstash)→ Elasticsearch → Kibana。
K8s 里的传统方案是:Filebeat 以 DaemonSet 部署,挂载宿主机的 /var/log/containers 目录(K8s 容器日志的落盘位置),用 autodiscover 感知节点上新起的 Pod,给每条日志自动附加命名空间、Pod 名等 K8s 元数据后输出:
filebeat.autodiscover:
  providers:
    - type: kubernetes
      node: ${NODE_NAME}
      hints.enabled: true

output.elasticsearch:
  hosts: ["http://elasticsearch:9200"]
和 Vector 简单对比:Filebeat 胜在成熟稳定、和 Elastic 生态集成顺滑,是传统 ELK 栈的标配;Vector 更轻更快、后端不绑死,属于新一代通用采集管道——日志进 ES 用 Filebeat 顺手,想进 Loki/Kafka/S3 等多后端则 Vector 更灵活。
cAdvisor
cAdvisor(Container Advisor)是 Google 开源的容器资源监控组件,但它不需要单独安装——已经内嵌在每个节点的 kubelet 里,是整条资源指标链路的源头:
- 统计本节点上每个容器的 CPU、内存、网络、文件系统用量。
- Metrics Server 拿到的数据,本质上就来自 kubelet(其背后是 cAdvisor)。
- kubelet 在
/metrics/cadvisor路径上把 cAdvisor 指标以 Prometheus 格式暴露出来。
让 Prometheus 抓取所有节点的 cAdvisor 指标,一个 job 就够(配合前面讲的 K8s 服务发现):
scrape_configs:
  - job_name: cadvisor
    kubernetes_sd_configs:
      - role: node                        # 自动发现所有节点
    scheme: https
    tls_config:
      ca_file: /var/run/secrets/kubernetes.io/serviceaccount/ca.crt
      insecure_skip_verify: true
    bearer_token_file: /var/run/secrets/kubernetes.io/serviceaccount/token
    relabel_configs:
      - target_label: __metrics_path__    # 默认抓 /metrics,改成 cAdvisor 路径
        replacement: /metrics/cadvisor
kube-prometheus-stack 默认已经配好 cAdvisor、kubelet、kube-state-metrics 的抓取任务和常用面板,一般不用手写这段配置。cAdvisor 指标基数很高,要自定义的话,记得用 metric_relabel_configs 丢弃用不上的指标系列。
Event
除了指标和日志,K8s 还有第三样排障利器:Event(事件)。集群里发生的每件事——Pod 被调度到哪个节点、镜像拉取失败、探针检测不过、副本扩缩——都会生成一条 Event 记录,这是排障时的第一手信息。
Pod 起不来、状态一直 Pending、反复重启时,先看事件:
# 看全集群事件,按时间排序(最新的在最后)
kubectl get events -A --sort-by='.lastTimestamp'

# 只看异常事件
kubectl get events -A --field-selector type=Warning
NAMESPACE   LAST SEEN   TYPE      REASON      OBJECT                MESSAGE
default     5m          Normal    Scheduled   pod/nginx-7c9d5-xxx   Successfully assigned default/nginx-7c9d5-xxx to node-1
default     5m          Warning   Failed      pod/nginx-7c9d5-xxx   Failed to pull image "nginx:1.29-badtag": not found
default     4m          Warning   BackOff     pod/nginx-7c9d5-xxx   Back-off pulling image "nginx:1.29-badtag"
排查具体对象时更常用 kubectl describe——它的输出末尾自带该对象关联的 Events,不用单独查:
kubectl describe pod nginx-7c9d5-xxx -n default
Event 存在 etcd 里,默认 TTL 只有 1 小时(由 API Server 的 --event-ttl 参数控制),过期就被清掉。所以出了问题要趁早看;需要长期留存做审计的话,得额外部署事件导出器(如 kubernetes-event-exporter)把事件转发到外部存储。