调度与资源管理
Pod 最终落在哪个节点上、能吃到多少资源、资源紧张时谁先被赶走,这三个问题贯穿了 Kubernetes 的日常运维。本篇把调度器的工作流程、Request/Limit、QoS、亲和与反亲和、污点与容忍、拓扑打散、驱逐机制、集群自动扩缩串起来讲一遍,配好可直接套用的清单。
Scheduler
kube-scheduler 的职责很单一:监听所有 nodeName 为空的 Pod,为它挑一个最合适的节点,然后把结果通过 Binding 写回 API Server。之后的事就交给对应节点上的 kubelet 了,调度器不再参与。
调度过程分两个阶段:
- Filter(过滤):把不满足条件的节点直接剔除,剩下的叫「可行节点」。常见的过滤项包括:
- 节点剩余可分配资源是否满足 Pod 的
requests(CPU、内存、扩展资源); - 端口是否冲突(
hostPort)、卷是否挂得上来、节点是否处于 NotReady 或被驱逐状态; nodeSelector、NodeAffinity 硬约束、污点后是否还有容忍。
- 节点剩余可分配资源是否满足 Pod 的
- Score(打分):对可行节点逐一打分,选出得分最高者。打分插件会综合考虑资源均衡(避免把节点塞得太满或太零散)、亲和性软约束、镜像是否已本地缓存(减少拉取时间)等因素。得分相同的节点随机取一个。
可以用 kubectl describe pod 查看调度决策的过程与失败原因:
kubectl describe pod web-7d9c4f5b6-x2abc
Events:
  Type     Reason            Message
  ----     ------            -------
  Warning  FailedScheduling  0/3 nodes are available: 1 Insufficient cpu, 2 node(s) had untolerated taint.
  Normal   Scheduled         Successfully assigned default/web-7d9c4f5b6-x2abc to node-2
Pod 一旦被绑定到节点,调度器就不会再为它做二次决策:节点后来被打上污点、资源被别的 Pod 抢走,正在运行的 Pod 都不会被自动挪走(NoExecute 驱逐除外)。想让调度器重新选择节点,只能重建 Pod,比如 Deployment 滚动更新、kubectl delete pod 让控制器补新副本。需要周期性「纠偏」存量 Pod 的布局时,可以引入社区的 Descheduler 项目。
Resource Request
requests 声明容器期望至少拿到多少资源,它是调度器 Filter 阶段的判断依据:节点 allocatable 减去已分配出去的 requests 之和后,还能容纳新 Pod 的 requests,这个节点才算可行。
两个资源的单位写法不同:
- CPU:以「核」为单位,
1表示 1 个核,500m表示 0.5 个核(m 即 millicore,毫核)。最小粒度是1m。 - 内存:以字节为单位,常用
Mi、Gi(1024 进制),也接受M、G(1000 进制)和纯字节数。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web
spec:
  replicas: 2
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      containers:
        - name: app
          image: nginx:1.27
          resources:
            requests:
              cpu: 250m
              memory: 256Mi
查看节点当前已被 requests 占用了多少:
kubectl describe node node-2
Allocated resources:
  Resource           Requests      Limits
  --------           --------      ------
  cpu                1250m (62%)   2 (100%)
  memory             1792Mi (45%)  3Gi (76%)
requests 只在调度时记账,并不会在节点上真的「圈出」一块资源锁给这个 Pod。如果节点上所有容器的实际用量加起来超过物理资源,照样会竞争、会驱逐。它只是让调度器按账面数字做摆放决策。
Limit
limits 是容器运行期的资源上限,由节点上的 kubelet / cgroup 强制执行。两类资源超限后的命运完全不同:
| 资源 | 类型 | 超 limit 的后果 | 说明 |
|---|---|---|---|
| CPU | 可压缩(compressible) | 被限速(throttling) | 进程不会被杀,只是 cgroup 把 CPU 时间片压回限额内,表现为延迟升高、CPU Throttled 指标上涨 |
| 内存 | 不可压缩(incompressible) | OOMKilled | 内存没法「限速」,超限后内核 OOM Killer 直接杀进程,容器退出码 137,按 restartPolicy 重启 |
一个同时带 requests 和 limits 的例子:
resources:
  requests:
    cpu: 250m
    memory: 256Mi
  limits:
    cpu: "1"
    memory: 512Mi
社区长期有两种声音:
- 不设 CPU limit:CPU 限速会带来隐蔽的延迟毛刺,尤其是限流严重的服务;只设 requests 让空闲核自由借用,利用率更高。Tim Hockin 等 Kubernetes 核心成员也公开推荐过这种配法。
- 必须设 limit:不设 limit 的容器在节点上等于「裸奔」,一个进程跑飞就会挤爆同节点其他 Pod 的账面资源,干扰排查。
实践上比较稳妥的折中是:CPU 只设 requests 不设 limits,内存 requests 与 limits 都设且相等(让内存变成强约束,避免不可预期的 OOMKill,同时拿到 Guaranteed QoS)。团队有 limitrange 强制限额要求时,再按规范补齐。
QoS
kubelet 根据每个 Pod 全部容器的 requests/limits 配置,算出三个 QoS 等级,资源紧张时按等级决定处置顺序:
| QoS 等级 | 判定规则 | 典型场景 |
|---|---|---|
| Guaranteed | Pod 内每个容器都同时设置了 CPU 和内存的 requests 与 limits,且 request 等于 limit | 核心在线服务、有状态服务 |
| Burstable | 至少一个容器设了 requests 或 limits,但不满足 Guaranteed 条件 | 普通业务默认落在这档 |
| BestEffort | Pod 内所有容器都没设任何 requests 和 limits | 批处理、临时调试容器 |
驱逐(Eviction)时的淘汰顺序是:BestEffort 先死,然后是实际用量超出 requests 最多的 Burstable,Guaranteed 最后。内存 OOM 场景下,OOM Killer 的打分也遵循类似倾向——用量相对 requests 超出越多的容器越容易被选中。
查看 Pod 的 QoS 等级:
kubectl get pod web-7d9c4f5b6-x2abc -o jsonpath='{.status.qosClass}'
Burstable
PriorityClass
PriorityClass 是集群级对象,给 Pod 一个全局优先级数值(int32)。value 越大优先级越高,调度器会先安顿高优先级 Pod,资源不够时还可以把低优先级 Pod 抢占(Preemption)掉腾出位置。
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: high-priority-online
value: 1000000
preemptionPolicy: PreemptLowerPriority
globalDefault: false
description: "在线核心业务"
Pod 通过 priorityClassName 引用:
spec:
  priorityClassName: high-priority-online
  containers:
    - name: app
      image: nginx:1.27
关键点:
preemptionPolicy默认为PreemptLowerPriority(允许抢占低优先级 Pod);设为Never则只享受排队优先,不踢人,适合「重要但不想误伤别人」的离线任务。- 抢占发生时,被牺牲的低优先级 Pod 会收到优雅终止信号,给足
terminationGracePeriodSeconds后再强杀。 - Kubernetes 自带两个系统级 PriorityClass:
system-cluster-critical和system-node-critical,value 分别是 2000001000 和 2000000000,留给 CoreDNS、kube-proxy 这类集群组件。业务 PriorityClass 的 value 不要超过它们,否则可能把系统组件挤下线。
PriorityClass 影响调度与抢占(谁先有节点可用),QoS 影响节点资源紧张时的驱逐(谁先被赶)。生产上两者要配合设计:高优先级 Pod 通常也配成 Guaranteed,避免出现「调度时很横、驱逐时先死」的尴尬组合。
NodeSelector
nodeSelector 是最简单的定向调度手段:Pod 声明一组键值对,只有带着完全相同标签的节点才算可行节点。
先给节点打标签:
kubectl label node node-2 disktype=ssd
然后在 Pod 里指定:
spec:
  nodeSelector:
    disktype: ssd
  containers:
    - name: app
      image: nginx:1.27
多个键值对之间是 AND 关系,全部满足才可调度。nodeSelector 够用但表达能力弱:只能做精确等值匹配,写不出「ssd 或 nvme」「不要某类节点」这种条件,那就该上 NodeAffinity 了。
NodeAffinity
NodeAffinity 是 nodeSelector 的增强版,按约束强度分两种:
| 类型 | 含义 | 调度行为 |
|---|---|---|
requiredDuringSchedulingIgnoredDuringExecution | 硬约束 | 不满足就 Pending;节点标签后来变了也不影响已运行的 Pod(IgnoredDuringExecution) |
preferredDuringSchedulingIgnoredDuringExecution | 软约束 | 尽量满足,满足不了也能调度;通过 weight(1-100)参与 Score 阶段打分 |
匹配条件用 matchExpressions 表达,操作符支持 In、NotIn、Exists、DoesNotExist、Gt、Lt:
spec:
  affinity:
    nodeAffinity:
      # 硬约束:必须落在 SSD 节点
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
          - matchExpressions:
              - key: disktype
                operator: In
                values:
                  - ssd
                  - nvme
      # 软约束:尽量落在 cn-hangzhou 区域
      preferredDuringSchedulingIgnoredDuringExecution:
        - weight: 80
          preference:
            matchExpressions:
              - key: topology.kubernetes.io/region
                operator: In
                values:
                  - cn-hangzhou
  containers:
    - name: app
      image: nginx:1.27
注意 nodeSelectorTerms 数组之间是 OR 关系,同一个 term 内的多个 matchExpressions 是 AND 关系。
PodAffinity
PodAffinity / PodAntiAffinity 让调度决策参考其他 Pod 的位置:「跟某些 Pod 待在一起」或「离某些 Pod 远一点」。
理解它关键是 topologyKey:它是节点标签的 key,定义了「同一个拓扑域」的边界。比如 topologyKey: kubernetes.io/hostname 表示「同一台节点」,topologyKey: topology.kubernetes.io/zone 表示「同一个可用区」。亲和条件里的 labelSelector 选中一批参照 Pod,调度器再按 topologyKey 判断候选节点与参照 Pod 是否同域。
示例一:同机部署(PodAffinity)——让缓存紧贴应用,减少网络开销:
spec:
  affinity:
    podAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        - labelSelector:
            matchLabels:
              app: web
          topologyKey: kubernetes.io/hostname
  containers:
    - name: cache
      image: redis:7
示例二:反亲和打散(PodAntiAffinity)——同一应用的副本不许落在同一台节点,防止单点故障一锅端:
spec:
  affinity:
    podAntiAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        - labelSelector:
            matchLabels:
              app: web
          topologyKey: kubernetes.io/hostname
  containers:
    - name: app
      image: nginx:1.27
required 级反亲和在副本数超过可用拓扑域数量时会让多出的副本永远 Pending(比如 3 副本应用只有 2 台节点,都用硬反亲和按 hostname 打散)。生产上更常用 preferred 软约束,或者直接用后文的 TopologySpreadConstraints——它是专为打散设计的,行为更可控。
Taints
亲和性是 Pod「主动选节点」,污点(Taint)则相反,是节点「主动拒绝 Pod」。只有带了对应容忍(Toleration)的 Pod 才能调度上来,用于节点专用(GPU 池、入口节点)、故障隔离等场景。
三种效果(effect):
| Effect | 行为 |
|---|---|
NoSchedule | 不容忍的 Pod 不会被调度到该节点,已在运行的 Pod 不受影响 |
PreferNoSchedule | 软版本的 NoSchedule,尽量不调度,实在没地方去也能上来 |
NoExecute | 不容忍的 Pod 不仅不能调度,已在运行的也会被驱逐 |
给节点打污点和移除污点:
kubectl taint node node-3 dedicated=gpu:NoSchedule
kubectl taint node node-3 dedicated=gpu:NoSchedule-
控制平面节点默认带污点,所以业务 Pod 不会跑到 master 上:
kubectl describe node master-1 | grep Taints
Taints: node-role.kubernetes.io/control-plane:NoSchedule
Tolerations
Toleration 写在 Pod 里,表示「我能忍这个污点」。字段与污点一一对应:
spec:
  tolerations:
    - key: dedicated
      operator: Equal
      value: gpu
      effect: NoSchedule
  containers:
    - name: train
      image: pytorch/pytorch:2.4.0-cuda12.1-cudnn9-runtime
写法上的细节:
operator: Equal要求 key、value、effect 全部匹配;operator: Exists只匹配 key(和 effect,若指定),不写 value,一条容忍覆盖该 key 的所有污点。effect留空表示容忍该 key 的所有效果。- 配合
NoExecute可以再加tolerationSeconds:节点被打上 NoExecute 污点后,Pod 还能宽限存活多少秒才被驱逐,超时后照样赶走。 DaemonSet 的系统组件常靠这个字段在节点短暂 NotReady 时保持稳定。
tolerations:
  - key: node.kubernetes.io/not-ready
    operator: Exists
    effect: NoExecute
    tolerationSeconds: 300
上面这条就是 Kubernetes 自动给 Pod 注入的默认容忍之一:节点失联后给 5 分钟宽限,再决定是否把 Pod 驱逐重建。
TopologySpreadConstraints
拓扑打散约束是比 PodAntiAffinity 更灵活的「均匀分布」工具,核心字段三个:
| 字段 | 含义 |
|---|---|
maxSkew | 允许的最大不均衡度:任意两个拓扑域中,匹配 Pod 数量之差不能超过它,最小为 1 |
topologyKey | 拓扑域边界,同 PodAffinity,常用 zone、hostname |
whenUnsatisfiable | 无法满足时的策略:DoNotSchedule(硬约束,宁可 Pending)或 ScheduleAnyway(软约束,尽力打散) |
跨可用区打散的典型示例——3 个 AZ 各放尽量均等的副本:
spec:
  topologySpreadConstraints:
    - maxSkew: 1
      topologyKey: topology.kubernetes.io/zone
      whenUnsatisfiable: DoNotSchedule
      labelSelector:
        matchLabels:
          app: web
  containers:
    - name: app
      image: nginx:1.27
maxSkew: 1 + 3 个 zone + 6 副本,最终每个 zone 恰好 2 个 Pod;如果某 zone 挂了,剩余副本宁可 Pending 也不会全挤进一个 zone(DoNotSchedule)。想在故障时也能调度,就换成 ScheduleAnyway,或再加一条按 hostname 的软打散兜底。
只要「同一应用的副本均匀铺开」这一个诉求,优先用 TopologySpreadConstraints:它按计数控制倾斜度,副本数超过拓扑域数量时也能正确分布,而 PodAntiAffinity 的 required 模式会直接卡死。反亲和留给「两类不同 Pod 必须分开」这类跨应用的场景。
Eviction
「驱逐」这个词在 Kubernetes 里其实有两套机制,触发方和行为完全不同,别混为一谈:
1. kubelet 资源压力驱逐(节点自保)
节点内存、磁盘吃紧时,kubelet 不等 API Server 指令,直接按阈值驱逐本地 Pod 自救。常用信号与默认硬阈值:
| 驱逐信号 | 含义 | 默认硬阈值 |
|---|---|---|
memory.available | 节点可用内存 | 小于 100Mi |
nodefs.available | 根文件系统(容器镜像与可写层所在盘)可用比例 | 小于 10% |
imagefs.available | 镜像存储独立文件系统可用比例 | 小于 15% |
- 硬阈值(
eviction-hard):一旦越过立即驱逐,没有缓冲。 - 软阈值(
eviction-soft):越过后进入宽限期(eviction-soft-grace-period,如memory.available=1.5Gi配30s),持续超阈值满宽限期才驱逐,给节点自我恢复的机会。
驱逐顺序按 QoS 与「实际用量超出 requests 的幅度」排队,BestEffort 先死。被驱逐的 Pod 状态变为 Failed,reason 是 Evicted,需要控制器重建。
2. API 驱逐(主动驱逐 / Pod Disruption)
kubectl drain 节点维护时用的就是这套:drain 对每个 Pod 调用 Eviction API,而不是直接 delete。走 API 的好处是会尊重 PodDisruptionBudget(PDB)——PDB 规定某应用至少保留多少可用副本,驱逐请求若会击穿底线就被拒绝,drain 阻塞等待。
两者的区别一张表总结:
| 维度 | kubelet 压力驱逐 | API 驱逐(drain) |
|---|---|---|
| 触发方 | 节点 kubelet,本地自救 | 管理员 / 控制器,经 API Server |
| 是否尊重 PDB | 不尊重,命都快没了顾不上 | 尊重,超预算会被拒绝 |
| 是否优雅终止 | 只发 SIGTERM,宽限时间有限 | 走完整优雅终止流程 |
| Pod 终态 | Failed / Evicted | 正常删除,控制器补新副本 |
Cluster Autoscaler
调度层面的最后一个闭环:当集群资源总量不够、Pod 怎么都调度不出去时,光靠调度器没用了,得加节点——这就是 Cluster Autoscaler(CA)的活。
工作原理围绕两个方向:
- 扩容:Pod 长时间处于 Pending 且原因是「没有可行节点」(资源不足、污点、亲和性不满足现有节点),CA 判断某个节点组扩容出新节点后能安顿它,就调用云厂商 API 加机器。
- 缩容:节点持续一段时间利用率偏低(默认 CPU/内存 requests 合计低于 50%)、且上面的 Pod 都能安全挪走(尊重 PDB、不驱逐 kube-system 关键组件、无本地存储的 Pod 等),CA 把 Pod 驱逐到别处后回收节点。
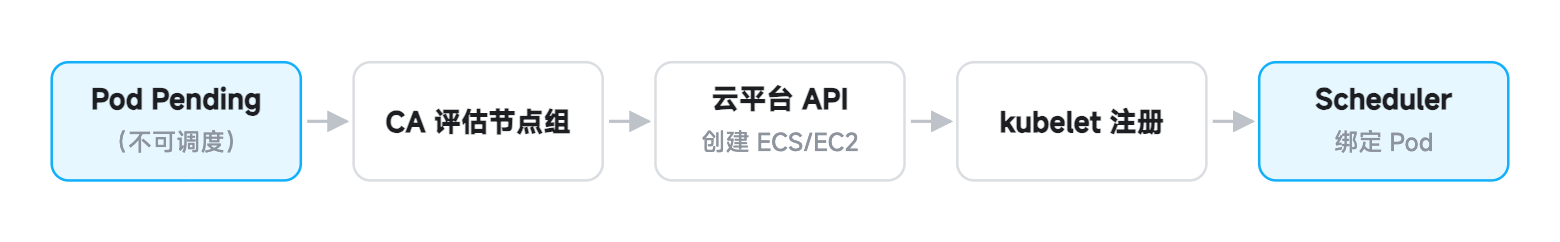
CA 本身不造机器,它依赖云厂商的节点组接口:AWS 的 Auto Scaling Group / EKS Managed Node Group、阿里云的 ACK 节点池与弹性伸缩、GCP 的 MIG 等,每个节点组配置 min/max 节点数,CA 在区间内调整期望值。
CA 的全部能力建立在「调 API 就能变出一台装好 kubelet 的机器」上,裸金属、私有云没有这套接口时 CA 无能为力。可以关注的替代方向:Karpenter(新一代自动扩缩器,绕开节点组、直接按 Pending Pod 的画像挑实例规格,目前主要支持 AWS,也有 Azure 等实现);裸机环境则更多靠规划容量 + 定时伸缩,或对接自有 CMDB 写自定义 provisioner。
至此,从「Pod 怎么选节点」到「集群怎么长节点」的整条链路就闭环了。调度器做摆放、requests/QoS 定待遇、亲和污点定规则、驱逐机制保底、自动扩缩管总量,生产环境的稳定性大半建立在这套组合的正确配置上。