Elasticsearch 核心概念与架构
从一个误解说起
很多人第一次接触 ES,是拿它当「带搜索功能的数据库」用的:建个索引,把业务表的数据整条塞进去,然后按 id 查、按条件过滤、分页排序,发现居然都能跑。于是不知不觉就把 MySQL 那套用法搬了过来,直到某天发现写入延迟抖动、磁盘暴涨、分片变红,才回头问一句:这东西到底该怎么用。
先把定位说清楚:ES 是搜索引擎,不是数据库替身。
| 对比项 | MySQL | Elasticsearch |
|---|---|---|
| 数据模型 | 强 schema 的表、行、列 | JSON 文档 + 映射(Mapping) |
| 事务 | ACID、行锁、回滚 | 无跨文档事务,单文档写原子 |
| 一致性 | 强一致(按隔离级别可调) | 近实时(默认 1 秒 refresh),最终一致 |
| 查询能力 | SQL、join、精确匹配 | 全文检索、相关性打分、多维聚合 |
| 典型短板 | 海量文本模糊查询、多维聚合 | 表关联、频繁更新、跨文档事务 |
结论很直白:需要事务和强一致的「事实来源」放数据库,需要全文检索和聚合分析的「查询副本」放 ES。生产上最常见的形态是 MySQL 存业务数据,通过 binlog 同步(Canal、Debezium)把需要检索的字段写进 ES,读请求走 ES、写请求走 MySQL。
ES 没有跨文档事务、没有真正的 join,更新一条文档的底层动作是「旧文档标记删除 + 新文档写入」,高频更新会把段(Segment)撑爆、触发疯狂合并。把订单、账务这类数据只存 ES 一份,等于给自己埋雷。
典型场景
- 日志检索:ELK / EFK 组合里 ES 是存储和检索层,按时间范围、服务名、trace id 捞日志,是它最成熟的用法,也是本篇示例的主要背景。
- 站内搜索:商品、文章、文档的全文检索,配合分词、同义词、拼音、相关性排序和搜索建议。
- 聚合分析:按天、按地域、按状态码分组统计,
terms、date_histogram、百分位数这类聚合比 SQL 的 group by 灵活得多。 - 可观测性:APM、指标、安全事件的存储后端,Elastic 官方 Stack 就是这套打法。
- 地理查询:附近的门店、按范围圈选,
geo_point、geo_shape开箱即用。
反过来要克制的场景也不少:账务流水、库存扣减、需要 join 十张表的报表、图片视频这类大字段原样存储——这些都不该交给 ES。
整体架构
一张图先建立印象:
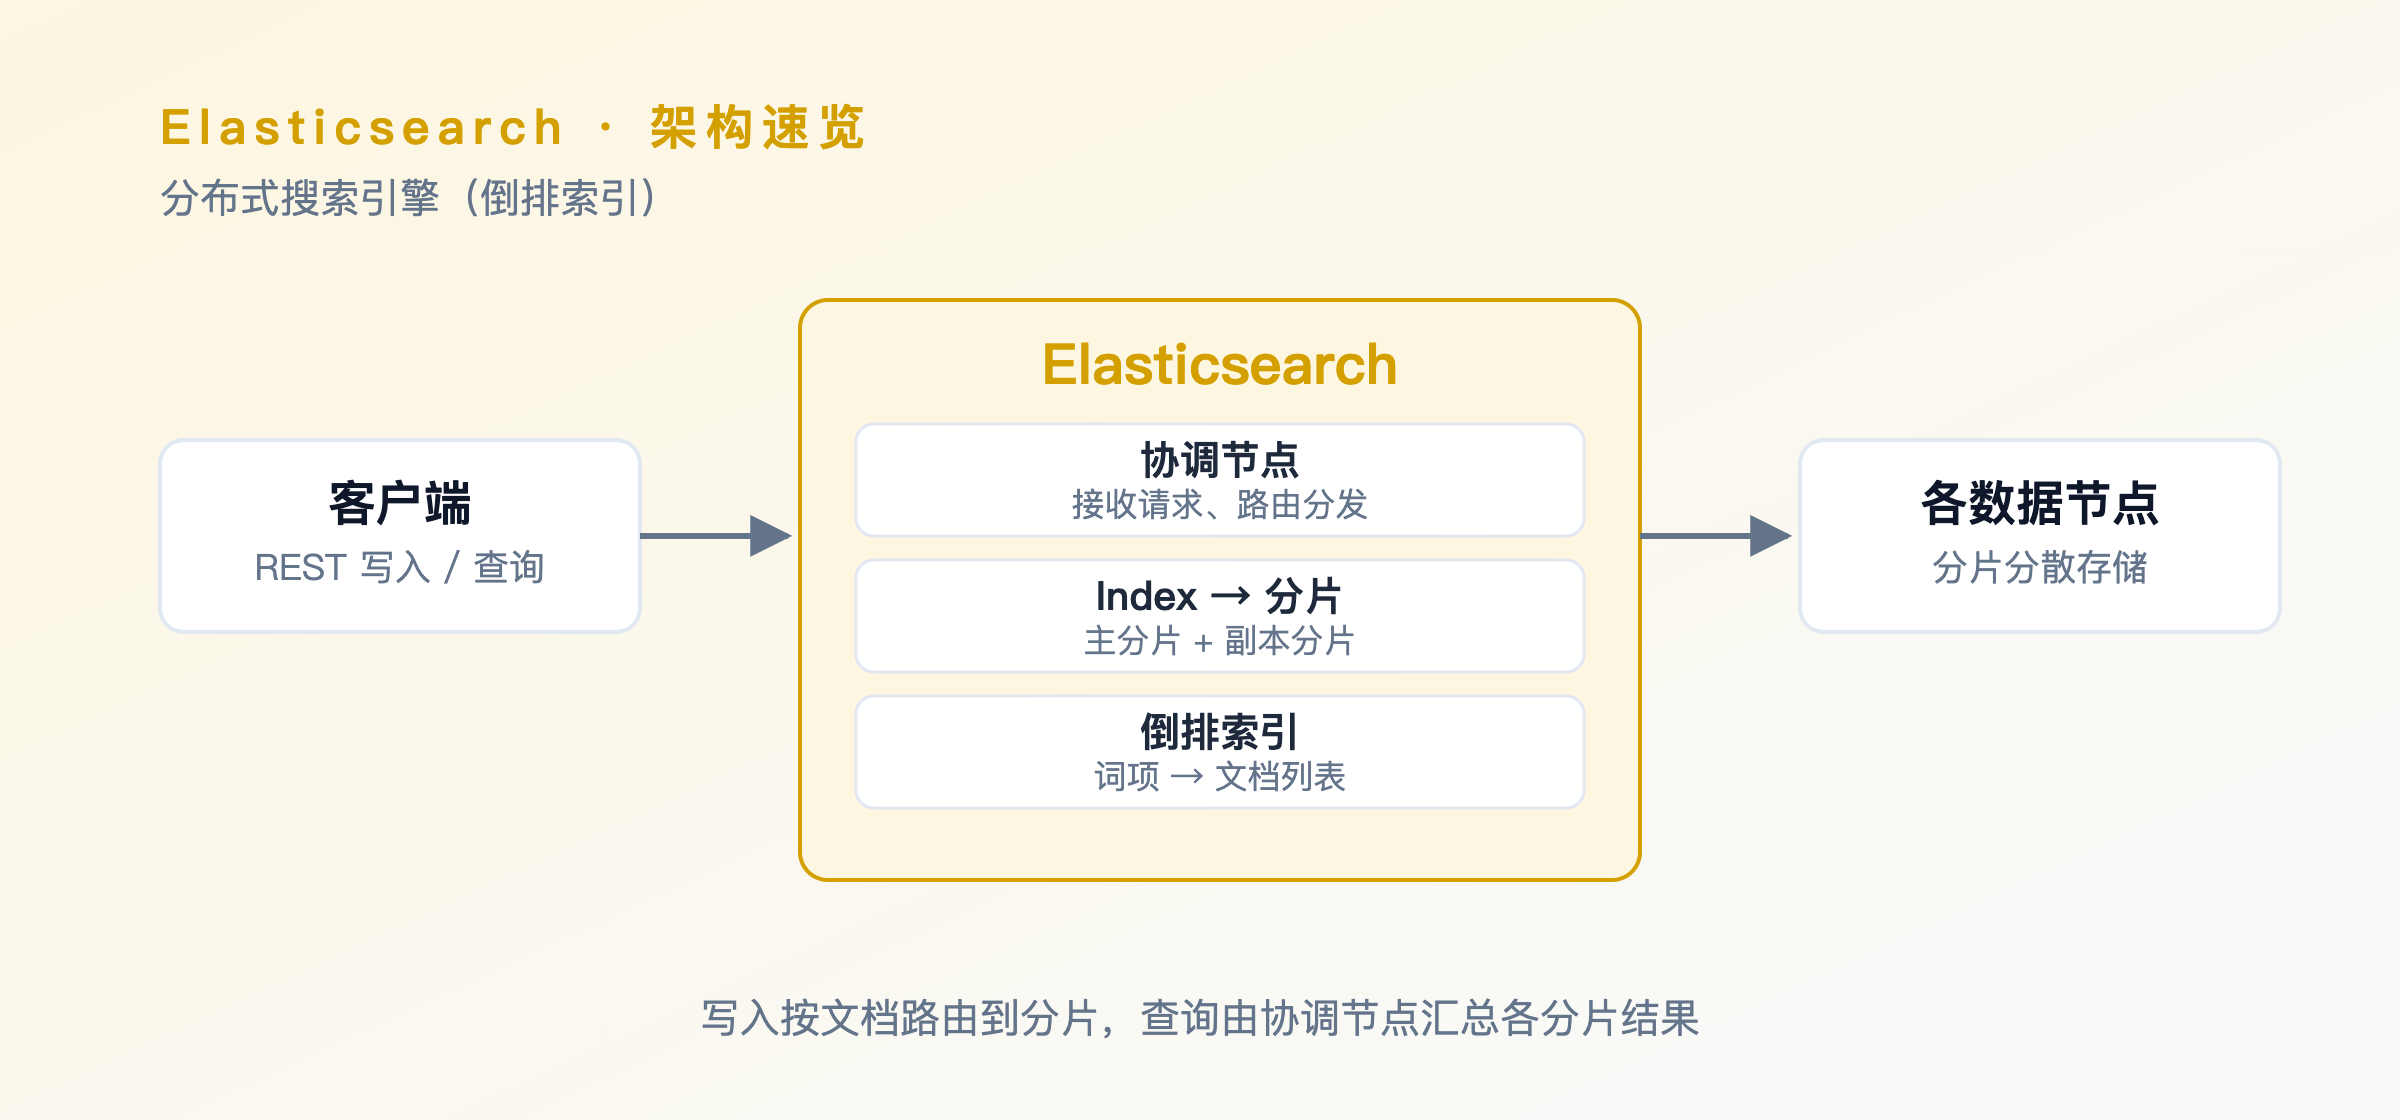
从下往上分四层,理解了这四层,后面所有运维动作都有落点:
- Lucene 段(Segment):ES 的存储底座其实是 Java 库 Lucene。每个段是一个不可变的小索引文件,新写入先进内存缓冲,refresh 时落成新段,后台 merge 再把小段合成大段。不可变是它快的根源,也是「更新等于重写」的根源。
- 分片(Shard):一个分片就是一个完整的 Lucene 索引实例。索引在逻辑上是一张表,物理上是若干个分片,分片才能被分散到不同节点上,这是水平扩展的最小单位。
- 节点(Node):一个 ES 进程就是一个节点,节点按角色分工(master、data、ingest、coordinating),一个节点上可以放多个分片。
- 集群(Cluster):多个节点用同一个
cluster.name组成集群,由 master 节点统一管理集群状态(元数据、分片分配)。
一次写入的完整链路,值得先有个印象:
客户端发 REST/JSON 请求
  → 协调节点按文档 _id 做哈希,路由到目标分片
  → 主分片(primary)执行写入:写 translog、进 Lucene 内存缓冲
  → 主分片把操作同步给副本分片(replica),副本确认后返回成功
  → 默认每 1 秒 refresh 一次,内存缓冲生成新段,文档变得「可搜索」
  → 后台 merge 合并小段;flush 把 translog 落盘并提交段
对应到读请求就简单多了:协调节点把查询广播到目标分片的全部副本(主或副都行),各分片本地查询、打分、返回候选文档 ID,协调节点归并排序后回表取 _source,最后返回。
refresh 决定「多久能搜到」(默认 1 秒,可调,写多读少的索引可以放宽到 30 秒);flush 决定「多久真正落盘并清空 translog」(默认按大小和时间触发);merge 是后台的段合并,吃 CPU 和磁盘 IO,是运维时最常看到「无缘无故变慢」的元凶。
核心概念
ES 的名词不多,但每个都有精确含义,混着用迟早出问题。
Index / Document / Field / Mapping
- 索引(Index):一类文档的集合,类比 MySQL 的表。名字必须小写,不能带空格和特殊字符(8.x 允许部分特殊字符,但没必要给自己找麻烦)。
- 文档(Document):一条 JSON,是 ES 里最小的读写单位,用
_id唯一标识。写入时可以不指定_id,由 ES 生成。 - 字段(Field):文档里的键值对,类比列。字段的类型、是否分词、是否建索引,统统由 Mapping 决定。
- 映射(Mapping):索引的 schema,定义字段类型和分析器。可以显式声明,也可以靠动态映射(Dynamic Mapping)自动推断——生产环境强烈建议显式声明,自动推断把日期认成字符串、把数字认成
long的事故太常见。
建一个索引,顺便把 schema 定下来(8.x 已经没有多类型的概念,properties 直接挂在 mappings 下):
PUT /orders
{
  "settings": {
    "number_of_shards": 3,
    "number_of_replicas": 1
  },
  "mappings": {
    "properties": {
      "order_id": { "type": "keyword" },
      "user_id": { "type": "keyword" },
      "amount": { "type": "double" },
      "status": { "type": "keyword" },
      "remark": { "type": "text" },
      "created_at": { "type": "date" }
    }
  }
}
这里已经能看出两条铁律:需要精确匹配、排序、聚合的字段用 keyword;需要分词的全文内容用 text。两者的区别第 3 篇会展开讲透。
分片与副本
索引只是逻辑概念,真正存数据、干活的是分片:
- 主分片(Primary Shard):索引创建时由
number_of_shards决定,一旦创建就不能改(想改只能 reindex、shrink 或 split)。它决定了索引的写能力和数据上限。 - 副本分片(Replica Shard):每个主分片的拷贝,数量由
number_of_replicas决定,随时可以改。作用有两个:主分片挂了能顶上(高可用),以及分摊读请求(提升读吞吐)。
PUT /orders/_settings
{
  "index": {
    "number_of_replicas": 2
  }
}
几条必须记住的约束:副本数可以大于数据节点数,但超出的副本会一直是 UNASSIGNED(同一个分片的主副本不能落在同一节点上);分片不是越多越好,每个分片都是一份 Lucene 索引,有固定开销,业界经验是单分片 20-50GB、单节点分片数控制在每 GB 堆内存 20 个以内;分片数规划错了,后期迁移成本极高,第 4 篇专门算这笔账。
节点角色
8.x 把节点角色拆得很细,生产上按角色分工是标准做法:
| 角色 | 配置值 | 职责 |
|---|---|---|
| 主节点 | master | 管理集群状态、分片分配,不存数据,轻量但要稳定 |
| 数据节点 | data、data_hot、data_warm、data_cold | 存分片、执行读写和聚合,最吃 CPU、内存、磁盘 |
| 摄入节点 | ingest | 执行 ingest pipeline,做字段加工、geoip、日期解析 |
| 协调节点 | 不配任何 role(空角色) | 只转发请求、归并结果,适合挡在大查询前面 |
| 投票节点 | voting_only | 只参与 master 选举,不参选,用于凑仲裁数 |
小集群(3 个节点以内)通常一个节点身兼 master + data;上了规模就该拆开:3 个专用 master 保证选举稳定,data 节点按热温冷分层,协调节点单独扛查询流量。
7.x 之前靠 discovery.zen.minimum_master_nodes 防脑裂,配错了就双主。8.x 改成了「集群引导」:首次启动时用 cluster.initial_master_nodes 指定候选 master,集群成型后这个参数就该删掉,之后靠 discovery.seed_hosts 互相发现。第 4 篇给完整配置。
倒排索引为什么快
关系库给某列建 B+ 树索引,本质是「按值找行」。ES 面对的是「一段话里包含哪些词」,按整段文本建 B+ 树毫无意义,所以它用的是另一个数据结构:倒排索引(Inverted Index)。
正排是「文档 → 词」,倒排是「词 → 文档列表」,后者才是检索要的方向:
文档 1:Elasticsearch 是一个分布式搜索引擎
文档 2:搜索引擎依赖倒排索引

分词后建立倒排索引(简化示意):
elasticsearch → [1]
分布式        → [1]
搜索          → [1, 2]
引擎          → [1, 2]
依赖          → [2]
倒排          → [2]
索引          → [2]
每个词项(Term)后面挂的那串文档 ID 叫 posting list。真实结构比这复杂:posting list 里还存词频、位置、偏移量(用于短语查询和高亮),并且整体是有序的,所以能做集合求交、求并。
它快的三个原因:
- 词项字典有序:所有词项按字典序排列,查一个词是二分查找,O(log n);再配合跳表(Skip List)做多词求交,可以跳过大量不匹配的文档。
- posting list 压缩存储:文档 ID 是递增的,用差值(delta)+ 位压缩编码,几百万文档的列表也能塞进很小的空间,读的时候顺序扫,对磁盘和 page cache 都友好。
- 段不可变 + 缓存:段一旦生成就不再修改,所以可以放心地被操作系统 page cache 缓存,也可以加各种查询缓存。这也是为什么 ES 的查询性能极度依赖剩余内存——留给文件缓存的内存越多,命中率越高。
代价同样明确:不可变意味着更新 = 删旧 + 写新。一次 update 在底层是给旧文档打删除标记、再写一条新文档,删除标记要等 merge 时才真正清理。所以高频更新的场景,ES 的写放大和磁盘占用会明显高于关系库。
分词这一步由**分析器(Analyzer)**完成,链路是「字符过滤 → 分词 → 词项过滤」,比如转小写、去停用词、加同义词。中文默认的 standard 分析器会把中文按单字切,检索效果很差,生产上一般装 IK 分词器并给字段指定 analyzer。第 3 篇讲 Mapping 时会给出完整配置。
text 字段会被分词、进倒排索引,适合 match 查询;keyword 字段原样存储、不分词,适合 term 精确匹配、排序、聚合。给 keyword 字段写 match 查询,或者给 text 字段写 term 查询,是新手最常见的两个「查不到数据」的原因。
集群健康状态
运维 ES,第一个要会看的接口就是集群健康:
curl -s "http://localhost:9200/_cluster/health?pretty"
{
  "cluster_name": "es-prod",
  "status": "green",
  "timed_out": false,
  "number_of_nodes": 3,
  "number_of_data_nodes": 3,
  "active_primary_shards": 12,
  "active_shards": 24,
  "relocating_shards": 0,
  "initializing_shards": 0,
  "unassigned_shards": 0,
  "delayed_unassigned_shards": 0,
  "number_of_pending_tasks": 0,
  "active_shards_percent_as_number": 100.0
}
status 只有三种取值,含义必须背下来:
| 状态 | 含义 | 影响 | 常见原因 |
|---|---|---|---|
| green | 所有主分片和副本分片都已分配 | 读写正常,集群完整 | 正常状态 |
| yellow | 所有主分片已分配,部分副本未分配 | 读写正常,但副本缺失、无冗余,节点挂了可能丢数据 | 单节点集群、副本数大于数据节点数、节点刚下线 |
| red | 至少有一个主分片未分配 | 该分片对应的数据读不到也写不进,部分查询会报错 | 磁盘满、节点长时间离线、分片损坏 |
再配合分片级别看状态,_cat/shards 里每个分片的 state 有四种:STARTED(正常)、RELOCATING(迁移中)、INITIALIZING(恢复中,比如重启后从 translog 回放)、UNASSIGNED(没分配出去)。
健康状态只反映「分片有没有分配出去」,不反映查询延迟、JVM 堆、写入队列、磁盘水位。一个 green 的集群完全可能正在 OOM 边缘、或者查询 P99 已经涨到十几秒。真正的巡检要结合 _cat/nodes、_nodes/stats 一起看,第 5 篇给指标清单。
小结
- ES 是搜索与分析引擎,不是数据库替身:事务、强一致、复杂 join 留给数据库,全文检索和聚合分析交给它。
- 架构四层:Lucene 段 → 分片 → 节点 → 集群。段不可变决定了 refresh / flush / merge 的行为,也决定了「更新即重写」。
- 核心概念:Index 是表、Document 是行、Field 是列、Mapping 是 schema;分片是水平扩展的最小单位,主分片数定死、副本数可调,主副本不能同节点。
- 倒排索引把「文档 → 词」翻成「词 → posting list」,靠有序字典、压缩、不可变段和 page cache 做到毫秒级检索,代价是写放大。
- 集群状态三色:green 完整、yellow 缺副本、red 缺主分片。yellow 时读写正常但没冗余,red 时对应分片不可用,必须立刻处理。
概念过完,下一篇《安装与快速上手》直接用 Docker 把单节点跑起来,用 curl 完成第一次建索引、写文档、搜数据。