etcd 核心概念与架构
定位:强一致的分布式 KV
日常执行 kubectl get pod,请求链路是这样的:kubectl 先找 kube-apiserver,apiserver 校验完请求,把对象序列化后写进 etcd,再返回给你。K8s 里所有资源对象、Service 的 Endpoints、RBAC 规则、Lease 心跳,最终都落在 etcd 的 key 空间里。apiserver 本身是无状态的,etcd 才是整个集群唯一的事实来源。这也是为什么 K8s 控制面故障排查到最后,经常要回到 etcd 的日志和指标上。K8s 的整体架构和数据流可以参考 Kubernetes 核心概念与架构。
etcd 的自我定位很克制:一个强一致、高可用的分布式键值存储,数据量小、读多写少、绝不能丢。它不是缓存,不是消息队列,也不是业务数据库。拿它跟常见的几个存储放在一起对比更清楚:
| 系统 | 一致性模型 | 主要用途 | 跟 etcd 的关系 |
|---|---|---|---|
| etcd | 线性一致(Raft) | 集群元数据、配置、选主 | 数据量小但要求绝对可靠 |
| Redis | 异步复制,主从可能丢数据 | 缓存、会话、排行榜 | 快,但不适合放「不能错」的元数据 |
| ZooKeeper | 顺序一致(ZAB) | 配置、命名、分布式锁 | 同类产品,etcd 的 API 和运维更现代 |
| Consul | 强一致(Raft) | 服务发现、KV、健康检查 | 偏服务发现,etcd 偏元数据存储 |
etcd 是「集群的大脑记忆」:存的是少量但极其关键的状态,写成功必须落到多数派磁盘上,读默认也要拿到最新值。用错地方——比如拿它存业务订单、当缓存扛流量——性能和容量都会很快撞墙。
整体架构
先看一张官方的架构图:
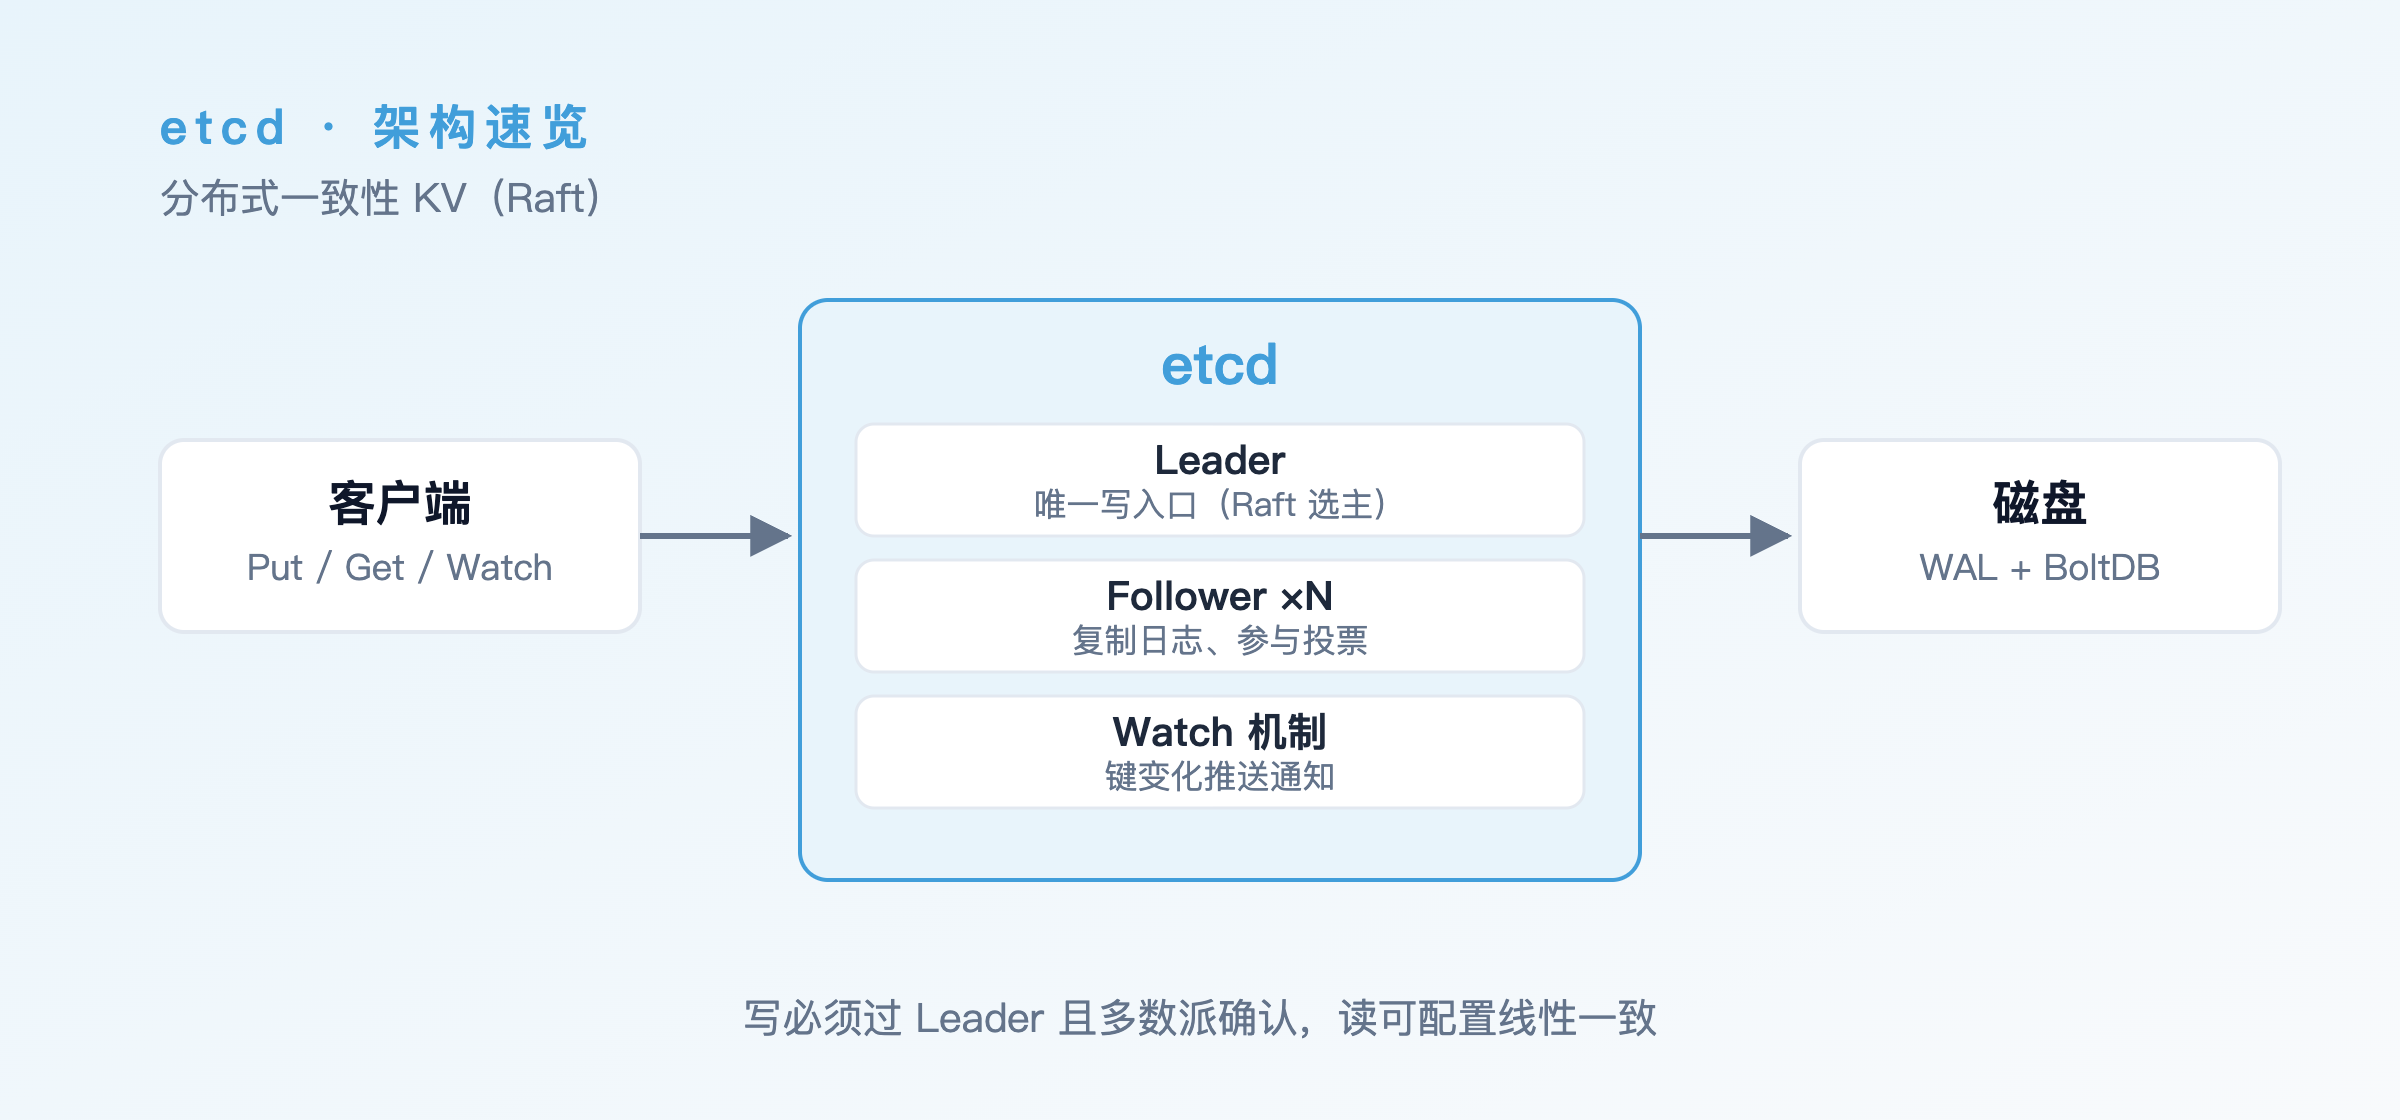
一个 etcd 进程内部可以拆成几层,从外到内:
- 客户端层:对客户端暴露 gRPC 接口(2379 端口),同时提供 HTTP/JSON 的 gateway,
curl和etcdctl都能用。集群成员之间走另一个端口(默认 2380),称为 peer 端口。 - Raft 层:一致性协议实现,负责选主、日志复制、多数派提交。所有写请求都要经过这一层,读请求的线性读也依赖它确认 leader 身份。
- WAL(预写日志):Raft 日志落盘点。每条提案先追加到 WAL 并
fsync,然后才可能被确认。崩溃恢复靠它重放。 - MVCC + backend:真正存 KV 的地方。etcd 用多版本并发控制保存 key 的历史 revision,底层是 bbolt(B+ 树)单文件数据库。
- Lease 与 Watch:Lease 管理带 TTL 的租约,Watch 把 key 变更以事件流推给客户端。两者都建立在 MVCC 的 revision 之上。
一次写请求在进程内的路径大致是:
客户端 gRPC 请求
  → Raft 层封装成 proposal
  → leader 写入 WAL 并 fsync
  → 并发复制给 follower,收到多数派确认
  → commit,应用到 MVCC(写 bbolt)
  → 返回客户端成功
读请求不写 WAL,但默认的线性读要跟 leader 确认「我还是 leader」,再等本地状态机追到读索引,才能返回。
Raft 要点
Raft 把「一致性问题」拆成三块:选主、日志复制、安全性。etcd 的实现基本遵循 Raft 论文,额外做了 Pre-Vote、Lease 读等优化。
Leader 选举
集群里每个成员都有三个时间参数:
- 心跳间隔:leader 定期给 follower 发心跳,默认 100ms。
- 选举超时:follower 超过这个时间没收到心跳,就认为 leader 挂了,随机化后发起选举,默认 1000ms。
- 随机化:每个节点的选举超时在基准值上随机抖动,避免所有 follower 同时竞选导致选票分散。
选举过程:
- follower 选举超时,term 加一,投票给自己,向所有成员发 RequestVote。
- 其他成员在同一 term 内只投一票,且只投给「日志至少和我一样新」的候选者。
- 拿到多数派选票的候选者成为新 leader,开始发心跳压制其他竞选。
- 如果一轮没选出来(比如平票),等随机超时后重来。
「日志至少和我一样新」这条限制是 Raft 安全性的核心:已经提交的日志一定在多数派上,新 leader 必然包含所有已提交日志。所以选主不会丢已确认的写。
选举超时调大,故障切换变慢;调小,网络稍抖就频繁选主。默认 1000ms 适合局域网。跨机房、云上高延迟环境可以适当加大心跳和选举超时,但要先确认不是磁盘 fsync 慢导致的心跳发不出去——那种情况调参数只会掩盖问题。
日志复制
写请求的处理过程,是理解 etcd 性能的关键:
- 客户端把写请求发给任意成员。follower 收到后会转发给 leader,不会自己处理。
- leader 把操作封装成一条日志条目,追加到本地 WAL,并同步 fsync 落盘。
- leader 并行地把这条日志通过 AppendEntries 发给所有 follower。
- follower 收到后写入自己的 WAL 并 fsync,然后回 ACK。
- leader 收到多数派(含自己)的 ACK,把这条日志标记为 committed,应用到 MVCC,返回客户端成功。
- follower 在下一次心跳或后续 AppendEntries 里得知 commit index,再应用到自己的状态机。
这里有两个容易忽略的点:
- leader 自己也要落盘。不是「发给 follower 就完事」,leader 的 WAL fsync 同样在关键路径上。
- 返回时机是多数派落盘,不是全部落盘。剩下两个 follower 慢一点不影响这次写的成功,但如果它们长期落后,就会影响故障切换后的可用性。
多数派提交
Raft 的 quorum 是「成员总数的一半以上」,不是「一半以上存活成员」。3 节点需要 2 票,5 节点需要 3 票:
| 集群规模 | 多数派 | 可容忍故障 | 说明 |
|---|---|---|---|
| 1 | 1 | 0 | 只能做开发测试 |
| 3 | 2 | 1 | 生产最小规模,最常用 |
| 5 | 3 | 2 | 规模较大、可靠性要求高的集群 |
| 7 | 4 | 3 | 再往上收益递减,写放大明显 |
| 2 或 4 | 2 或 3 | 0 或 1 | 偶数不增加容错,纯浪费机器 |
为什么偶数节点没意义:4 个节点同样要 3 票才能提交,容错能力和 3 节点一样(都只能挂 1 台),但多了一台的开销和更长的复制链路。要么 3,要么 5,不要 4。
另一个直觉是「节点越多越可靠」,其实不然。每次写都要等多数派落盘,节点越多,最慢的那台出现在多数派里的概率越高,P99 写延迟越难看。3 节点能满足绝大多数场景,5 节点通常已经是上限。
可用性看多数派,写延迟看多数派里最慢的那台。扩容 etcd 成员不会提升写吞吐,只会增加复制成本和运维负担;读吞吐要靠 apiserver 缓存、follower 读或客户端负载均衡来解决。
读一致性与线性读
etcd 的读有两种模式,对应不同的代价和保证:
| 模式 | etcdctl 参数 | 行为 | 一致性 | 代价 |
|---|---|---|---|---|
| 线性读(默认) | --consistency=l | 向 leader 确认身份,等待本地应用到读索引 | 强一致,能读到最新提交 | 多一次网络往返 |
| 串行读 | --consistency=s | 直接读本地状态机 | 可能读到稍旧的数据 | 最快,但可能过期 |
线性读的典型实现是 ReadIndex:follower 收到读请求后,向 leader 要一个当前已提交的索引,leader 通过一轮心跳确认自己仍是 leader,然后 follower 等本地状态机应用到该索引后再返回。这样既不用把读请求都压到 leader,又保证了线性一致。代价是多一次网络往返,所以对一致性要求不高的批量读取才会考虑串行读。
实际使用中的取舍:
- 配置读取、服务发现、选主:必须线性读,读到旧值可能做出错误决策。
- 监控大盘、离线导出、全量巡检:可以用串行读,减少对 leader 的压力。
- 写请求没有「弱一致」选项,只要返回成功,就一定是多数派落盘的。
Watch 机制
etcd 的 Watch 是长连接流式推送:客户端指定 key 或前缀,以及起始 revision,etcd 把之后发生的变更按顺序推过来。K8s 的 informer 机制、服务注册的健康监听、配置热更新,底层都是它。
几个关键语义:
- 事件有序:同一个 watch 收到的事件按 revision 非递减排列,同一批事务事件共享一个 revision,不会交错。
- 可断点续传:客户端记住最后处理的 revision,重连时从
revision + 1开始 watch,不会漏事件也不会重复太多。 - 事件类型:
PUT和DELETE。删除在 MVCC 里是一个 tombstone,仍然占 revision。 - 压缩会打断历史:如果起始 revision 已经被 compact 掉,watch 会直接失败,返回「required revision has been compacted」。客户端必须重新做一次全量 list,再接着 watch。
- 慢消费者会被丢弃:每个 watcher 有事件缓冲,客户端处理太慢、缓冲打满时,etcd 会取消这个 watch 并记录慢 watcher 指标,避免拖垮整个服务端。
它不持久化、不保证消费位点、不支持多消费者分组。把 watch 当成「变更通知 + 本地缓存同步」的机制,而不是业务消息总线。K8s 的 List-Watch 就是标准用法:先 list 拿全量快照和 revision,再从该 revision 之后开始 watch 增量。
数据模型
etcd 的 key 空间是一个扁平的字节序字典,没有目录概念。所谓「前缀」只是利用 key 的字典序做范围查询。K8s 把对象按前缀组织,看起来像目录树:
/registry/pods/default/nginx-7d8f9c-abcde
/registry/services/specs/default/kubernetes
/registry/leases/kube-node-lease/node-1
/registry/configmaps/kube-system/coredns
这些 key 在 etcd 里就是普通字符串,/registry/pods/ 是个前缀,不是一个真实目录。前缀查询靠的是范围扫描:给定 key 和 range_end,etcd 返回 [key, range_end) 区间内的所有 key。
每个 key 在 MVCC 里带一组元数据:
| 字段 | 含义 |
|---|---|
create_revision | 这个 key 第一次创建时的全局 revision,之后不变 |
mod_revision | 最近一次修改的 revision,每次 put/delete 都更新 |
version | 这个 key 被修改的次数,从 1 开始累加 |
lease | 绑定的租约 ID,没有绑定则为 0 |
revision 是全局单调递增的,整个集群共用一个计数器。一次事务里改了 10 个 key,它们共享同一个 revision;这也是 watch 能把事务变更打包推送的原因。删除 key 不会让 revision 回退,而是产生一个删除标记,历史版本仍然占空间,直到 compaction 把它们清掉。
Lease(租约) 是带 TTL 的存活凭证。客户端申请一个租约,把一批 key 绑上去,然后定期续期;一旦停止续期,租约到期,绑定的所有 key 会被自动删除。K8s 的节点心跳(kube-node-lease 命名空间下的 Lease 对象)和 apiserver 选主用的是 API 层的 Lease 对象,思路相同,但过期判断在 apiserver 和控制器侧完成,底层并不会给每个对象绑一个 etcd 租约。相比「定时写 key + 自己清理」,etcd 租约把过期回收交给了服务端,适合自己写服务注册时使用。
几个硬限制需要提前知道:
| 限制项 | 默认值 | 说明 |
|---|---|---|
| 单次请求大小 | 1.5 MiB | 超过会被拒绝,调大要同时改服务端和客户端 |
| 单个 value 大小 | 1.5 MiB | 实际建议控制在 KB 级,大对象放对象存储 |
| 后端存储配额 | 2 GiB | --quota-backend-bytes,生产常调到 8 GiB |
| 单事务操作数 | 128 | 超过要拆事务 |
| key 总大小 | 受请求大小限制 | 不要用超长 key,前缀扫描会变慢 |
etcd 适合存「少量、关键、读多写少」的元数据,典型量级是几十万 key、几 GB 数据。把日志、订单、图片、大 JSON 塞进来,很快就会碰到 2 GiB 配额和 compaction 的墙。判断标准很简单:这份数据丢了,集群还能不能转?能转的,就不该放 etcd。
小结
- etcd 是 K8s 的唯一事实来源,定位是强一致、高可用、小数据量的分布式 KV,不是缓存也不是业务库。
- 架构分四层:客户端接口、Raft、WAL、MVCC/backend,外加 Lease 和 Watch 两个能力。
- Raft 的写路径:leader 落 WAL → 复制给 follower → 多数派确认 → apply → 返回;写延迟取决于多数派里最慢的那台。
- 集群规模选 3 或 5,偶数不增加容错;读默认线性读,串行读能省一次往返但可能读到旧值。
- 数据模型是扁平 key 空间 + 全局 revision + lease;K8s 的
/registry只是前缀约定,不是目录。 - Watch 是带 revision 的事件流,用于增量同步,不是消息队列;压缩会让过旧的 watch 失效。
概念清楚了,下一篇直接动手:下载二进制、起一个单节点、用 etcdctl 完成第一次读写和 watch。