Kafka 核心概念与架构
为什么用 Kafka
很多团队第一次上 Kafka,动机其实很朴素:某个接口太慢了,或者某次大促把下游数据库打挂了。把这些需求拆开看,基本逃不出四类:
- 削峰填谷:上游流量是脉冲式的(大促、批量导入、定时任务),下游处理能力是平的。中间放一层 Kafka 把洪峰攒成队列,下游按自己的节奏消费,数据库就不会被瞬时并发打死。
- 系统解耦:订单服务下单后要通知库存、积分、风控、推荐。如果代码里同步调四个接口,任何一家挂了都拖垮下单。改成往 Kafka 发一条事件,谁关心谁订阅,订单服务不再知道下游有谁。
- 异步处理:主链路只做「落库 + 发消息」,发短信、生成报表、写数仓这些非核心动作异步做。用户感知的响应时间从 800ms 降到 80ms,靠的就是把不必要的工作挪出请求链路。
- 日志与数据管道:埋点日志、binlog、监控事件先统一进 Kafka,再由下游各自取用。同一份数据可以被 Flink 实时算、被 ClickHouse 落仓、被 S3 归档,不用为每个下游重复采集一遍。
它和「用数据库表当队列」的区别值得说清楚:数据库队列靠轮询,延迟高、锁竞争重、消费完还要删数据;Kafka 是追加写的日志文件,顺序 IO、批量读写,吞吐能差一到两个数量级。当然它也不是万能的,强事务、复杂路由、延迟消息这些场景,RabbitMQ、RocketMQ 更顺手。
示例以 Ubuntu 22.04 + Kafka 3.7+ 为准,默认按 KRaft 模式(不依赖 ZooKeeper)讲。3.3 起 KRaft 已可用于生产,4.0 起 ZooKeeper 模式被彻底移除。如果你手上的老集群还在用 ZooKeeper,第 4 篇有对照说明。
整体架构
一张图先建立整体印象:
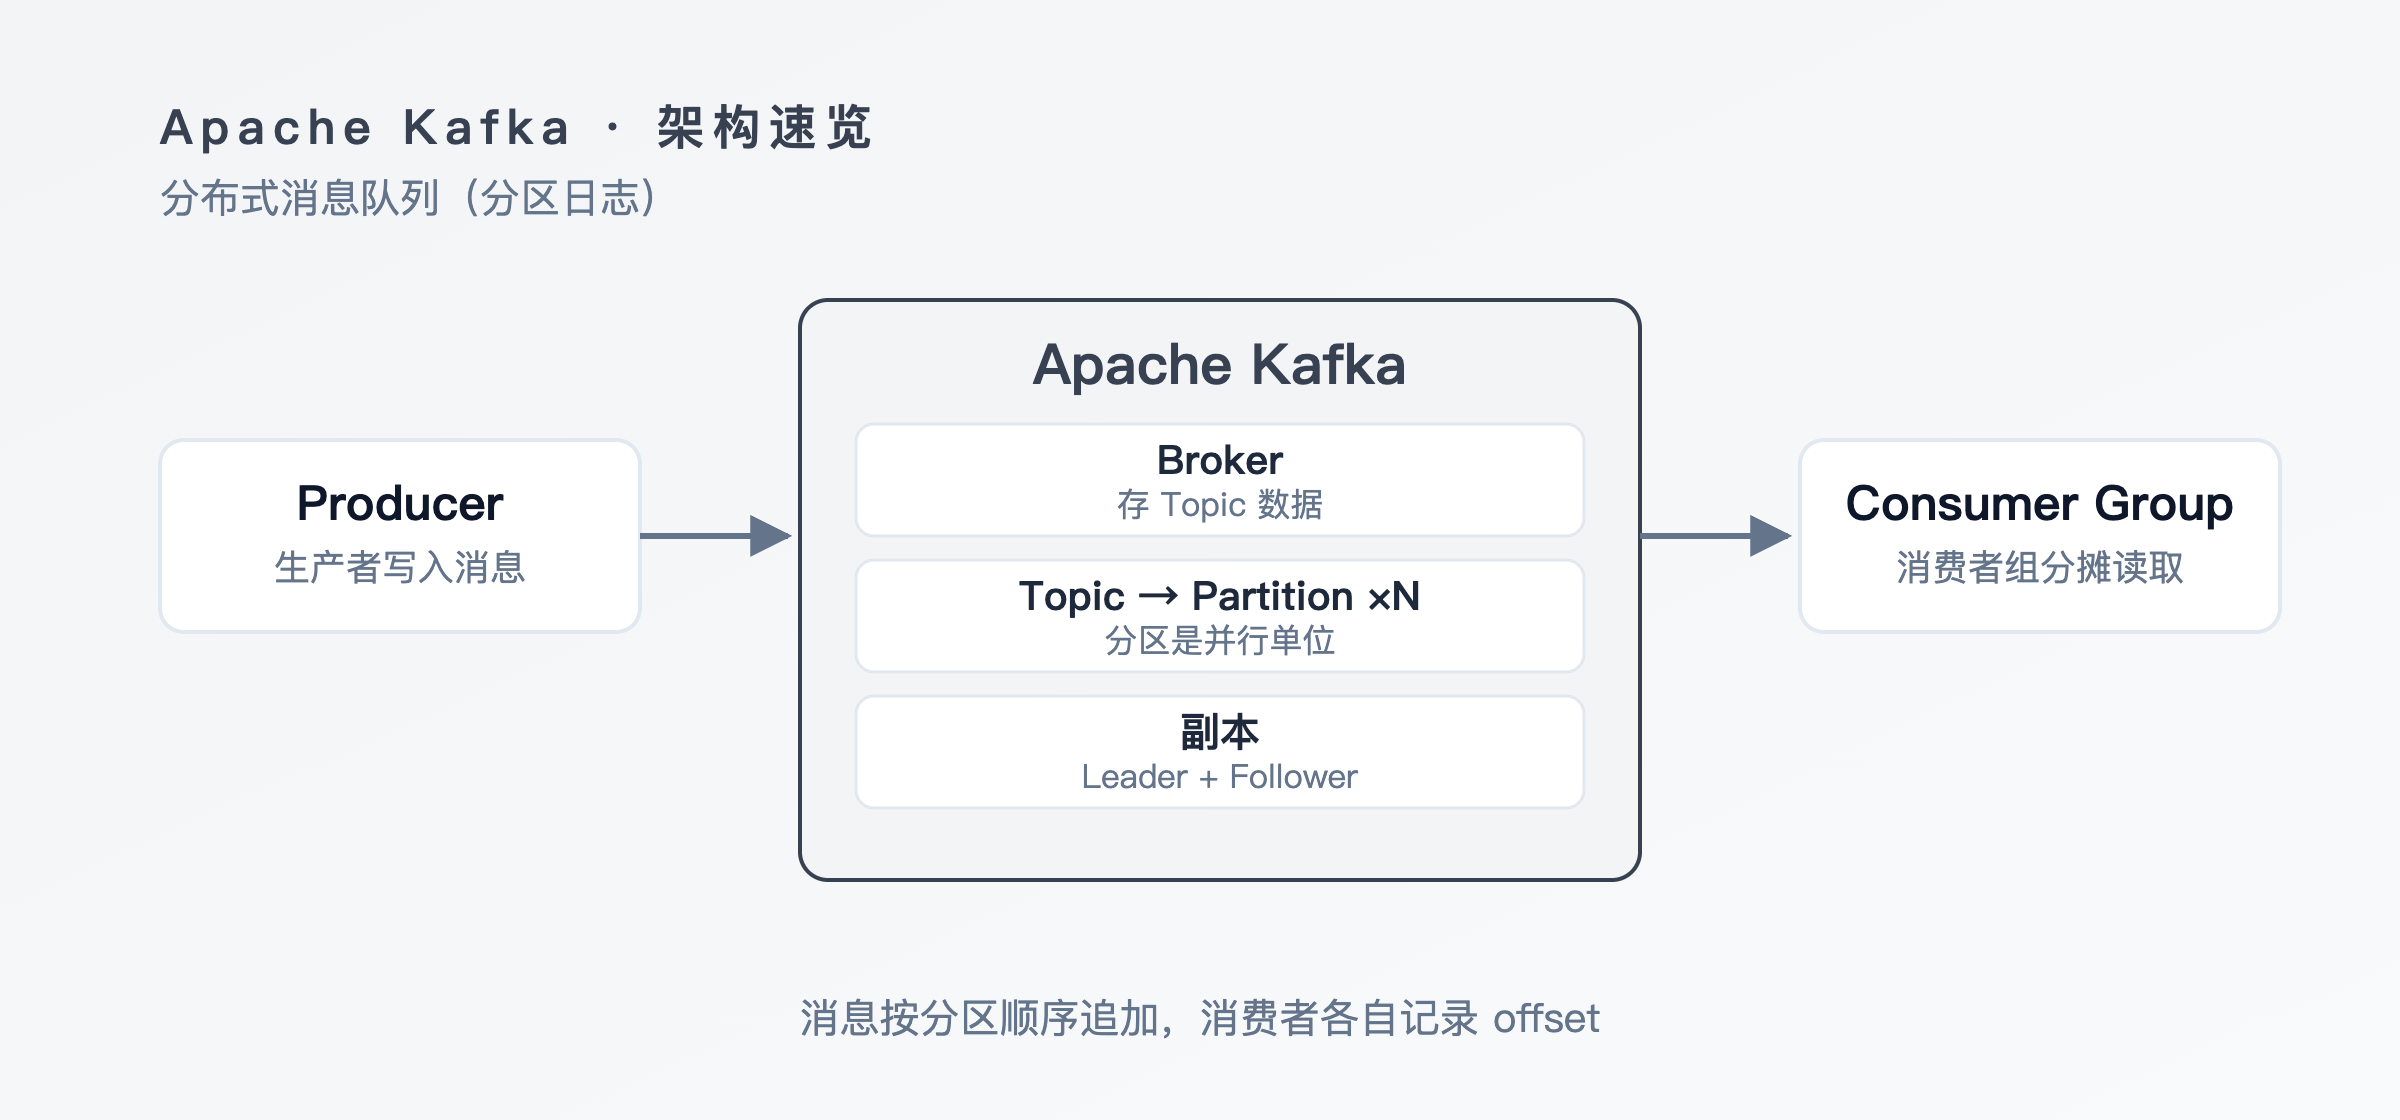
一条消息的旅程大致是这样:
生产者 Producer
  → 按 key 算出分区 → 批量攒起来 → 发往该分区的 Leader 副本
  → Broker 追加写入日志段文件(顺序写 + 页缓存)
  → Follower 副本主动拉取同步,追上后仍在 ISR 里
  → 消费者 Consumer 按 offset 顺序拉取,读完提交位点
  → 元数据(Topic、分区、Leader 分布)由 KRaft 控制器维护
和很多消息队列「推消息给消费者」不同,Kafka 的消费者是主动拉的。这个选择带来的好处很直接:消费者自己控制节奏,不会被生产者的洪峰冲垮,慢消费者只是 lag 变大,不影响别人。
组件层面只有四类角色:Producer 写、Broker 存、Consumer 读、Controller 管元数据。别被「分布式消息系统」这个词吓到,去掉副本和协调之后,它的本质就是一个被切成多段的追加写文件 + 一份位点记录。
核心概念
先把六个名词摆在一起,后面逐个展开:
| 概念 | 一句话解释 |
|---|---|
| Broker | 一个 Kafka 服务进程,负责存数据、响应读写 |
| Topic | 逻辑上的消息分类,生产者往这里写、消费者从这里读 |
| Partition | Topic 的物理分片,是并行和顺序的最小单位 |
| Replica | 分区的副本,一主多从,用来扛机器故障 |
| Offset | 消息在分区内的唯一递增编号,也是消费位点 |
| Consumer Group | 一组消费者,合力消费一个 Topic,分区在组内分配 |
Broker:存数据的那个进程
一台机器上跑一个(也可以跑多个)Kafka 进程,每个进程就是一个 Broker,用 broker.id(KRaft 下是 node.id)区分。生产环境习惯起 3 个以上,因为副本因子 3 是标配,而副本必须落在不同 Broker 上才有意义。
Broker 收到消息后不做复杂计算,就是往 log.dirs 指定的目录追加写文件。它的资源瓶颈通常在磁盘 IO 和网络带宽,而不是 CPU——这也决定了后面做容量规划时该盯什么。
Topic:逻辑分类
Topic 是给消息分类用的名字,比如 order-created、user-behavior-log、mysql-binlog。生产者和消费者只跟 Topic 打交道,不关心数据实际落在哪台机器。
Topic 本身不存数据,它只是一个逻辑概念,下面挂着若干 Partition。创建 Topic 时必须指定分区数和副本因子,这两个数字基本决定了它的吞吐上限和可靠性。
Partition:并行与顺序的单位
一个 Topic 被切成多个 Partition,每个 Partition 在磁盘上是一组独立的日志段文件,可以落在不同 Broker 上。这是 Kafka 高吞吐的根源:
- 并行度:不同分区可以同时被不同 Broker 写、被不同消费者读,吞吐随分区数线性扩展。
- 顺序性:单个分区内消息严格有序,跨分区不保证。所以「要顺序」就要求同一个业务 key 落到同一个分区。
- 消费者上限:一个分区同一时刻只能被同组的一个消费者消费,消费者数量超过分区数就是白扩容。
分区数只能增不能减,这是运维上最容易后悔的操作——建 Topic 时宁可多留一点余量,也别事后才发现不够。
Replica:一主多从
每个分区有 1 到 N 个副本,其中一个 Leader,其余 Follower。所有读写都走 Leader,Follower 唯一的任务就是不停去 Leader 拉数据,保持同步。Leader 所在的 Broker 挂了,控制器从 ISR 里挑一个 Follower 顶上,客户端重连后继续读写。
副本跨 Broker 分布是自动做的,你只要保证副本因子不超过 Broker 数量。单机环境副本因子只能是 1,这意味着没有任何冗余,磁盘坏了数据就没了——这也是单机只适合学习验证的原因。
Offset:消息的身份证
每条消息在所属分区内有一个从 0 开始单调递增的编号,就是 offset。它有两个身份:
- 定位:消费者说「我要 offset 100 之后的消息」,Broker 就能精确找到位置。
- 位点:消费组把「消费到哪了」记在内部主题
__consumer_offsets里,记录的就是 offset。
Kafka 不在消息被消费后删除数据,删不删只看保留策略(时间或大小)。所以同一个 offset 可以被不同消费组各读一遍,也可以被重置回历史位置重放——这是 Kafka 相比传统队列最有用的特性之一。
Consumer Group:分工与容错
消费组是消费者侧的扩展单位。同一个组内的消费者分摊 Topic 的所有分区,一条消息只会被组内一个消费者处理;不同组之间互不影响,各读各的。
举个例子:order-created 有 6 个分区,order-service 组起了 3 个实例,每个实例分到 2 个分区;data-warehouse 组也订阅它,用自己的位点从头读,两组之间完全独立。
组内成员增减会触发再均衡(rebalance),期间消费会短暂停顿。rebalance 太频繁是线上最常见的问题之一,第 6 篇专门排。
消息读写机制
Kafka 快,不是因为用了什么黑科技,而是把几件普通的事做到了极致:
顺序写。消息只追加到日志段文件末尾,不修改、不随机寻址。机械盘上顺序写能到几百 MB/s,随机写只有几 MB/s,差两个数量级。Kafka 的所有设计都在保护这个「只追加」的假设。
落到磁盘上,一个分区就是一组日志段文件(示意):
# 分区在数据目录下是一个独立文件夹
ls -lh /data/kafka/logs/order-created-0/
00000000000000000000.log        1.0G   消息本体,只追加,写满就换下一个段
00000000000000000000.index      10M    offset 到文件物理位置的稀疏索引
00000000000000000000.timeindex  10M    时间戳到 offset 的索引,按时间查位点靠它
消费者说「从 offset 1234567 开始读」时,Kafka 先在 .index 里二分找到最近的锚点,再从那里顺序扫——不需要遍历整个文件。这也是为什么 offset 能当随机访问的坐标用。
页缓存(Page Cache)。Broker 不自己缓存消息,读写都交给操作系统的页缓存。写入先进页缓存就返回,由内核异步刷盘;读取时如果命中页缓存,根本不碰磁盘。这也是为什么给 Kafka 预留大量内存很有价值——内存越大,能缓存的日志段越多。
零拷贝(Zero-copy)。消费时 Broker 用 sendfile 把页缓存里的数据直接送到网卡,省掉「内核态拷贝到用户态、再拷贝回内核态」这两次复制。所以正常消费几乎不消耗 Broker 的 CPU,也解释了为什么 Broker 的瓶颈是网络而不是 CPU。
批量 + 压缩。生产者把消息攒成批(batch.size、linger.ms),Broker 整批落盘,消费者整批拉取。批越大,摊销的固定开销越少;再叠加 lz4/zstd 压缩,网络和磁盘的实际数据量能降好几倍。
开启 TLS 后数据要加密,sendfile 这条路走不通,会退化成普通拷贝;消息格式需要做转换(比如老客户端版本兼容)也会绕过零拷贝。所以「上了 SSL 吞吐掉一截」是正常现象,不是配置错了。
副本与 ISR
副本机制里最关键的概念是 ISR(In-Sync Replicas):与 Leader 保持同步的副本集合。判断标准是「最近 replica.lag.time.max.ms(默认 30 秒)内有没有追上 Leader 的 LEO」,而不是消息条数差多少。
这里有两个位置指针值得分清:
- LEO(Log End Offset):每个副本自己日志的最后一条位置。
- HW(High Watermark):ISR 中所有副本 LEO 的最小值。消费者只能读到 HW 之前的消息,这是为了防止消费者读到尚未被副本备份、随后可能丢失的数据。
ISR 是动态的。Follower 同步跟不上就会被踢出 ISR(日志里能看到 Shrinking ISR),追上之后再加回来(Expanding ISR)。ISR 收缩本身是保护机制,不是故障——它在告诉你某个副本暂时不可靠,别把它算进「已备份」的账里。但持续收缩就要警惕了:说明那台 Broker 的磁盘、网络或 GC 确实有问题。
ISR 直接决定可靠性。配合 acks=all 和 min.insync.replicas=2,一条消息必须被至少 2 个副本确认才算写成功;如果 ISR 只剩 1 个副本,生产请求会直接被拒(NotEnoughReplicasException),用写入失败换不丢数据。这是 Kafka 里最经典的一组权衡:
| 配置组合 | 行为 | 适用 |
|---|---|---|
acks=all + min.insync.replicas=2 | ISR 不足时拒绝写入 | 订单、支付等不能丢的数据 |
acks=all + min.insync.replicas=1 | 只要 Leader 写成功就返回 | 可容忍极端情况丢少量 |
acks=1 | Leader 写完就返回,不等副本 | 日志、埋点等允许丢的场景 |
acks=0 | 发出去就不管 | 只追求吞吐,基本不用 |
还有一个兜底开关 unclean.leader.election.enable,默认 false。它允许从不在 ISR 里的副本选 Leader,好处是分区能快速恢复可用,坏处是这个副本可能缺数据,造成消息丢失和位点错乱。生产上保持关闭,宁可等一会儿。
不是。ISR 里的副本越多,acks=all 要等的确认就越多,写入延迟越高。副本因子 3、min.insync.replicas=2 是绝大多数场景的甜点:能扛一台机器挂掉,延迟也可控。
小结
- Kafka 的价值在削峰、解耦、异步、日志管道四件事上;它擅长高吞吐的顺序消息,不擅长复杂路由和强事务。
- 六个核心概念一条线串起来:Broker 存 Topic,Topic 切成 Partition,Partition 有多个 Replica,消息靠 Offset 定位,消费靠 Consumer Group 分摊。
- 快的三个原因:顺序写、页缓存、零拷贝,再叠加批量与压缩。
- 分区内有序、跨分区无序,所以「要顺序」等于「同一个 key 进同一个分区」,而分区数只能增不能减。
- 可靠性看 ISR:
acks=all+min.insync.replicas=2是标准姿势,ISR 收缩是预警信号而不是故障本身。
概念清楚了,下一篇安装与快速上手直接动手:用 KRaft 单机模式把 Kafka 跑起来,建第一个 Topic,用命令行收发第一条消息。