MinIO 核心概念与架构
为什么自建对象存储
博客图床、数据库备份、日志归档、数据湖底座——这些场景有个共同点:存的是「一大坨字节 + 一个名字」,不需要目录树,也不需要随机改写中间某一段。用文件系统硬扛,会遇到单机容量上限、扩容要停机、多机共享要靠 NFS 这三座大山;用块存储又得自己搭一层文件系统。
对象存储就是为这类场景设计的:扁平的命名空间、HTTP 接口、天生支持水平扩展。公有云上用 OSS/S3 当然省事,但账单按流量和请求数走,图床这种「小文件多、读多写少」的负载很容易被流量费咬一口;备份数据放云上还有合规和出网带宽的顾虑。所以自建一套 S3 兼容的对象存储,是很自然的选择。
MinIO 是这个方向上最省心的开源实现:
- 单二进制、无外部依赖:一个可执行文件跑起来就是个完整的对象存储,不用装 Java、不用先起元数据库。
- S3 API 兼容:现有 SDK、AWS CLI、rclone、各种备份工具基本都能直接连,迁移成本极低。
- 纠删码内建:不需要 RAID 卡,靠软件做冗余,坏盘、坏节点都能自愈。
- 分布式模式:多节点多盘组成一个命名空间,容量和吞吐一起横向扩展。
MinIO 社区版以 AGPLv3 发布,功能完整、可以商用,但修改后分发有开源义务。生产环境建议锁定具体版本号(RELEASE 形式的日期版本),不要盲目追 latest。
定位:对象存储,不是文件服务器
先把三种存储的差别摆清楚,避免用错工具:
| 类型 | 访问方式 | 数据组织 | 典型场景 |
|---|---|---|---|
| 块存储 | 挂载成裸设备 | 扇区、无结构 | 数据库数据文件、虚拟机磁盘 |
| 文件存储 | 挂载成目录(NFS/SMB) | 目录树、支持随机改写 | 共享文档、代码目录、容器配置 |
| 对象存储 | HTTP API(S3) | 扁平 Bucket + 对象名 | 图片、备份包、日志、模型文件 |
对象存储有三个「反直觉」的特性,用之前必须接受:
- 没有真正的目录:
photos/2024/a.png里的斜杠只是对象名的一部分,控制台看着像目录而已。想「重命名目录」等于把前缀下所有对象重新拷一遍。 - 对象不可改,只能整体覆盖:改一个 10 GB 文件里的 1 个字节,也得重新上传整个对象。所以对象存储里存的应该是「一次写成、之后只读」的数据。
- 强一致,但复制是异步的:MinIO 对单个集群内的读写提供强一致语义(写完立刻能读到),跨站点复制则不保证——这一点在规划容灾时必须算进去。
整体架构
一张图看全貌:
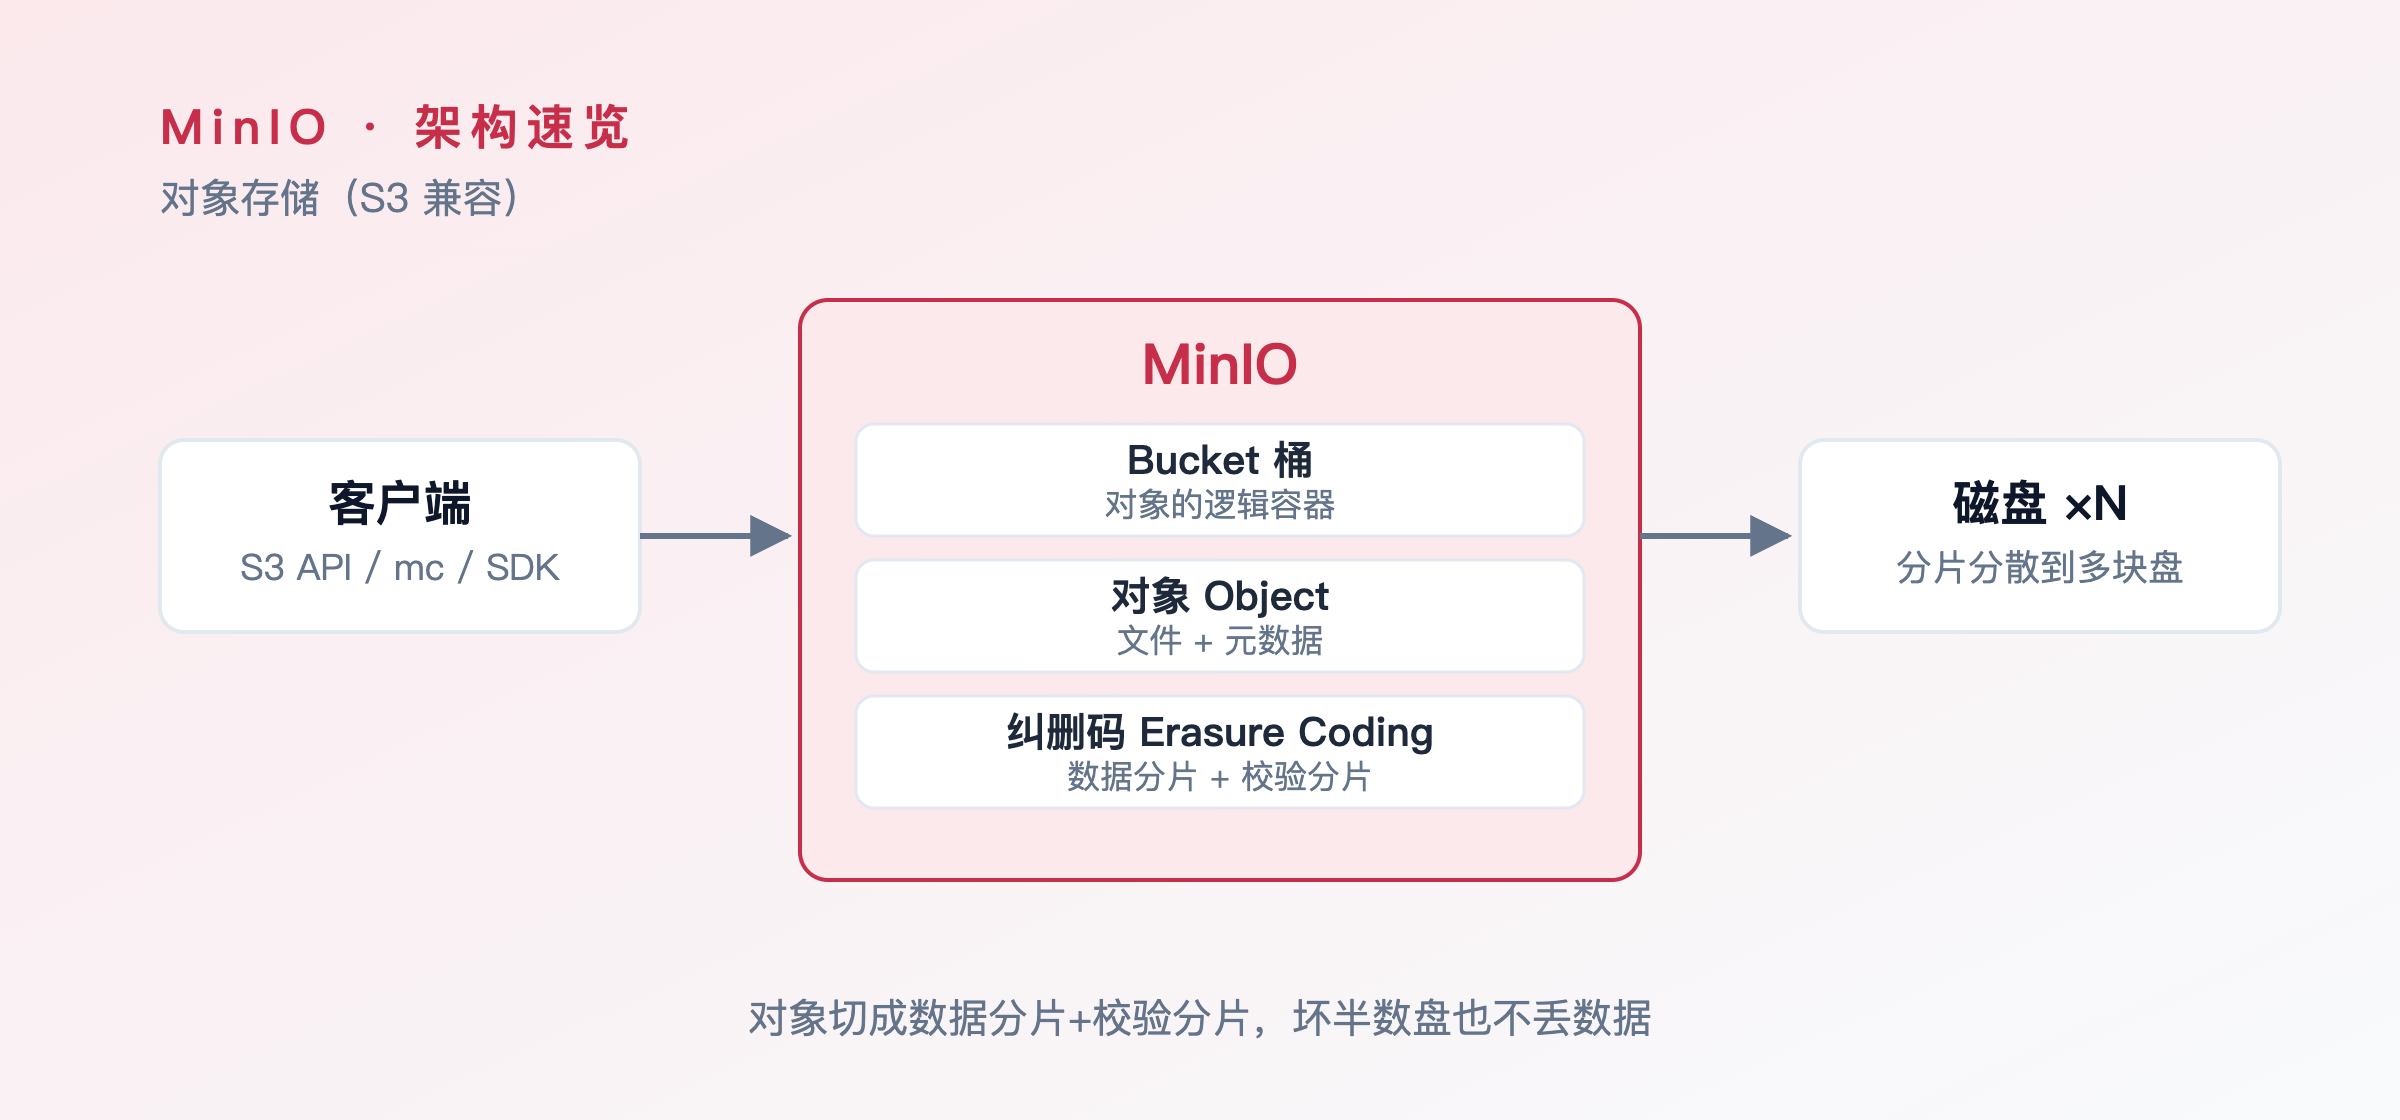
从下往上拆:
- 存储层:每个节点挂若干块本地盘(DAS,直连存储)。MinIO 要求独占磁盘,磁盘上只放它自己的数据分片和
xl.meta元数据,不要再挂别的服务。 - 纠删码层:一个服务器池(Server Pool)里的盘被划分成一个或多个「纠删码集合」(Erasure Set),每个集合独立做 Reed-Solomon 编码。
- S3 接口层:每个 MinIO 进程都对外提供完整的 S3 API,没有「主节点」的概念。客户端连任意一个节点,请求会被内部转发到该对象所属的集合。
- 控制台:9001 端口上的 Web 界面。注意 2025 年 6 月之后社区版把账户、策略、配置、监控这些管理功能从控制台移除了,只剩精简的对象浏览器,管理操作要靠
mc admin。 - 客户端:
mc命令行、各语言 SDK、AWS CLI、rclone、备份软件,都通过 9000 端口的 S3 API 访问。
MinIO 的每个节点地位对等,没有 ZooKeeper/etcd 之类的协调组件。这既是优点(部署简单、没有元数据单点),也是约束——节点之间必须时间同步、网络互通,集群状态靠 gossip 和分布式锁维护。
核心概念
Bucket 与 Object
- Bucket(桶):对象的顶层容器,名字全局唯一(在一个集群内),创建时要指定区域。桶相当于「数据库里的库」,是权限、版本控制、生命周期规则的作用单位。
- Object(对象):桶里的一条数据,由「对象名 + 内容 + 元数据」组成。对象名可以带斜杠模拟层级,但本质是扁平的键。
- Prefix(前缀):对象名的公共开头,
photos/2024/就是一个前缀。列对象、批量删除、生命周期规则都按前缀匹配。
桶名有硬性规则:3 到 63 个字符,只能用小写字母、数字、点、连字符,不能以点开头结尾,不能像 IP 地址。踩过坑的都懂,MyBucket 这种大写名字在 S3 里是非法的。
S3 API 与兼容性
MinIO 实现的是 S3 协议的一个子集,覆盖了绝大多数实际用到的接口:
| 类别 | 典型操作 | 说明 |
|---|---|---|
| 桶操作 | CreateBucket、ListBuckets、DeleteBucket | 建桶、列桶、删空桶 |
| 对象操作 | PutObject、GetObject、DeleteObject、ListObjectsV2 | 上传、下载、删除、列举 |
| 分片上传 | CreateMultipartUpload、UploadPart、CompleteMultipartUpload | 大文件必走,断点续传的基础 |
| 版本控制 | PutBucketVersioning、ListObjectVersions | 多版本、删除标记 |
| 预签名 | PresignGetObject、PresignPutObject | 临时授权 URL |
| 生命周期 | PutBucketLifecycleConfiguration | 过期删除、转储 |
兼容不等于 100% 一致。桶通知(事件)、对象锁、Select 查询这些进阶能力,MinIO 的支持程度和 AWS 有差异;用了 ACL 老模型的代码也可能行为不同。上线前用真实 SDK 跑一遍关键路径,比读兼容性文档靠谱。完整的兼容性矩阵见官方 S3 API 兼容性文档,参考资料篇有链接。
Access Key、Secret Key 与 Policy
S3 的认证是「签名」而不是「密码登录」:客户端用 Access Key(相当于用户名)和 Secret Key(相当于密码)对请求算一个 HMAC 签名,服务端用同样的密钥验签。Secret Key 不会在网络上传输,但一旦泄露就等于把权限交出去了。
权限体系分两层:
- 用户与策略(Policy):MinIO 内置
readonly、readwrite、writeonly、consoleAdmin等策略,也可以自己写 JSON 策略精确到「哪个桶的哪个前缀、允许哪些动作」。用mc admin user add建用户,mc admin policy attach绑定策略。 - 桶策略(匿名访问):决定「不带凭据的请求能干什么」,用
mc anonymous set download这类命令配置,适合公开图床这种场景。
MINIO_ROOT_USER 是超级管理员,拥有所有权限,且不受桶策略约束。业务程序应该单独建用户、只授需要的前缀权限。排障时见过太多「所有服务共用 root」的环境,一次密钥泄露就是全集群沦陷。
纠删码:MinIO 的立身之本
分片怎么切
MinIO 不用 RAID,而是把每个对象单独做纠删码:
- 对象按纠删码集合的配置切成
K个数据分片(Data Shards); - 用 Reed-Solomon 算法算出
M个校验分片(Parity Shards); K + M个分片分散写到集合里的不同磁盘上,每块盘一个分片。
关键点:分片是以对象为单位的,不是以磁盘为单位的。所以一块盘坏了,影响的是「存在这块盘上的那些分片」,而不是某个完整的文件。恢复时也不需要「另一块完整的盘」,只要有任意 K 个分片就能重建。
能坏多少盘
设纠删码集合有 N 块盘,校验分片数为 M,数据分片数 K = N - M:
- 读仲裁 = K:至少要有
K块盘的任意分片在线,才能拼回对象。 - 写仲裁 = K(当
M小于N的一半时);当M恰好等于N的一半时,写仲裁变成K + 1,用来防止脑裂导致同一对象写到两个「半边」上。 - 能容忍的坏盘数 = M:
M块盘同时掉线,读写都还能继续;超过M块,这个集合里的数据就丢了。
以官方默认的 EC:4 为例:
| 集合盘数 N | 数据 K | 校验 M | 可用容量比 | 最多坏盘 | 说明 |
|---|---|---|---|---|---|
| 4 | 2 | 2 | 50% | 2 | 最小可用集合,校验被集合上限压到 2 |
| 8 | 4 | 4 | 50% | 4 | 写仲裁变为 5,节点级容错一般 |
| 16 | 12 | 4 | 75% | 4 | 官方推荐形态,容量与可靠性平衡 |
| 16(EC:8) | 8 | 8 | 50% | 8 | 最稳但最费盘,写需要 9 块在线 |
MinIO 初始化时会自动计算集合大小,上限 16 块盘。节点和磁盘数量是偶数时最好规划:4 节点 × 4 盘 = 16 块,正好一个集合,EC:4 下相当于 12 数据 + 4 校验,坏任意 4 块盘数据都还在,正好能扛住「整台节点掉线」这种最常见的故障。
存储效率与校验级别
校验分片是纯开销,M 越大越安全、可用容量越少。校验值可以按桶甚至按对象前缀覆盖(存储类机制),但同一集合内的对象可以有不同的校验级别,各自独立计算。已经写进去的对象不会因为改了配置而重算。
选择建议:
- 常规业务用默认
EC:4,容量利用率 75%,容忍 4 块盘故障,性价比最高。 - 归档、冷数据、可重算的数据(比如能重新生成的缩略图)可以降到
EC:2,换更高容量。 - 别上
EC:0——那等于副本数为 1,任何一块盘坏掉都直接丢数据。
位腐化防护
磁盘上的数据会「静默损坏」(bit rot),没有告警、没有报错,读出来就是错的。MinIO 在写分片时对内容算 HighwayHash,读的时候校验;发现某个分片对不上,就用其他分片重建这个分片并回写修复。这就是「自动自愈」的一部分,也是为什么分片数据必须由 MinIO 独占——任何外部脚本改动磁盘上的文件,都会被当成损坏。
单机与分布式
两种部署形态的差别不只是「几台机器」:
| 对比项 | 单机单盘 | 单机多盘 / 分布式 |
|---|---|---|
| 数据冗余 | 无,盘坏即丢 | 纠删码,容忍 M 块盘故障 |
| 容量上限 | 单盘容量 | 节点数 × 盘数 × 单盘容量 |
| 扩容方式 | 换更大的盘(要迁移数据) | 加服务器池(新池) |
| 一致性 | 本地文件系统语义 | 强一致,跨节点仲裁 |
| 适用场景 | 本地开发、临时验证、CI | 生产环境,无一例外 |
| 运维复杂度 | 极低 | 需要规划网络、时间同步、负载均衡 |
单机单盘模式没有纠删码,本质就是「把目录通过 HTTP 暴露出去」,磁盘坏一块数据就没了。它只适合开发调试和一次性验证,生产环境再小的规模也应该用 4 盘起步的纠删码模式。
分布式模式还有一个容易被忽略的约束:数据分布靠对象名哈希。给定 BUCKET/PREFIX/OBJECT,MinIO 用确定性算法算出它属于哪个服务器池、哪个纠删码集合,读写永远走同一条路径。这带来两个后果:
- 没有中心元数据表,靠算的,所以节点间不需要同步「对象存在哪」;
- 加新池之后,老对象不会自动搬家,新写入按各池空闲空间比例分配,需要时用
mc admin rebalance手动重平衡。
适用边界
MinIO 很强,但不是万能存储。下面这些场景在选型阶段就该排除:
- 需要 POSIX 语义的共享目录:代码仓库、Office 文档协作、容器共享配置,要的是 NFS/SMB。对象存储没有文件锁、不支持随机改写,「重命名目录」等于把整个前缀重新拷一遍。
- 频繁修改中间片段的数据:追加写的日志文件、数据库数据文件、视频剪辑工程。对象不可改,每次都得整体重传。
- 跨对象的原子操作:S3 没有「多个对象要么全成功要么全失败」的事务,只能靠业务侧补偿或状态机。
- 海量超小文件:千万级 1KB 文件时,元数据和列举开销占比极高,扫描、heal、生命周期都会变慢。这类数据先打包(tar、parquet)再存。
反过来,下面这些场景它是首选:图床和静态资源、数据库与主机备份、日志与指标归档、数据湖和机器学习数据集、Kubernetes 的 PV(CSI 驱动)。判断标准其实只有一条:这份数据是不是「一次写成、之后主要整读」——是就走对象存储,不是就去找文件系统或数据库。
它能通过 S3 API 直接提供 HTTP 访问,但没有边缘节点、没有缓存分发。公网高并发下载的正确姿势是「MinIO 做源站 + CDN 回源」,靠 MinIO 自己扛流量,带宽账单会很难看。
小结
- MinIO 是自建 S3 兼容对象存储的首选:单二进制、无外部依赖、纠删码内建、可水平扩展。
- 对象存储是扁平命名空间 + HTTP API + 对象整体覆盖,适合图片、备份、日志、数据湖,不适合当共享文件系统。
- 核心概念四件套:Bucket 装 Object,S3 API 是访问方式,Access Key / Secret Key 做签名认证,Policy 管权限。
- 纠删码把每个对象切成
K数据 +M校验分片,容忍 M 块盘故障,默认EC:4、集合上限 16 块盘,16 盘拓扑的容量利用率是 75%。 - 单机单盘只配做实验,生产从一开始就按分布式规划;数据分布靠对象名哈希,扩容是加池而不是加盘。
- 选型看一条标准:数据是否「一次写成、之后主要整读」。需要文件锁、随机改写、跨对象事务的场景不属于它,CDN 分发也不该由它扛。
概念清楚了,下一篇《安装与快速上手》用二进制 + systemd 把单机 MinIO 跑起来,再用 mc 完成第一次上传下载。