MySQL 核心概念与架构
为什么运维要懂架构
刚接手 MySQL 的人容易把它当成一个「黑盒」:连上去、写 SQL、出结果,中间发生了什么不关心。等出了问题就抓瞎了:
- 一条 SQL 突然变慢,不知道是没走索引,还是数据从磁盘读的而不是从内存读的。
- 磁盘 IO 打满、CPU 不高,猜不到是 Buffer Pool 太小还是刷脏页太慢。
- 主从延迟几小时,说不清是主库写入太猛还是从库回放卡住。
- 改个参数不知道影响哪一层,
max_connections和innodb_buffer_pool_size到底该先调哪个。
MySQL 是分层的,每一层有自己的职责和瓶颈。知道一条 SQL 从连进来、被解析、被优化、被引擎执行、最后落盘,中间经过了哪些组件,排查问题时才有方向感——这一篇就把这条链路拆开讲。
整体架构
先看图,再看分层:
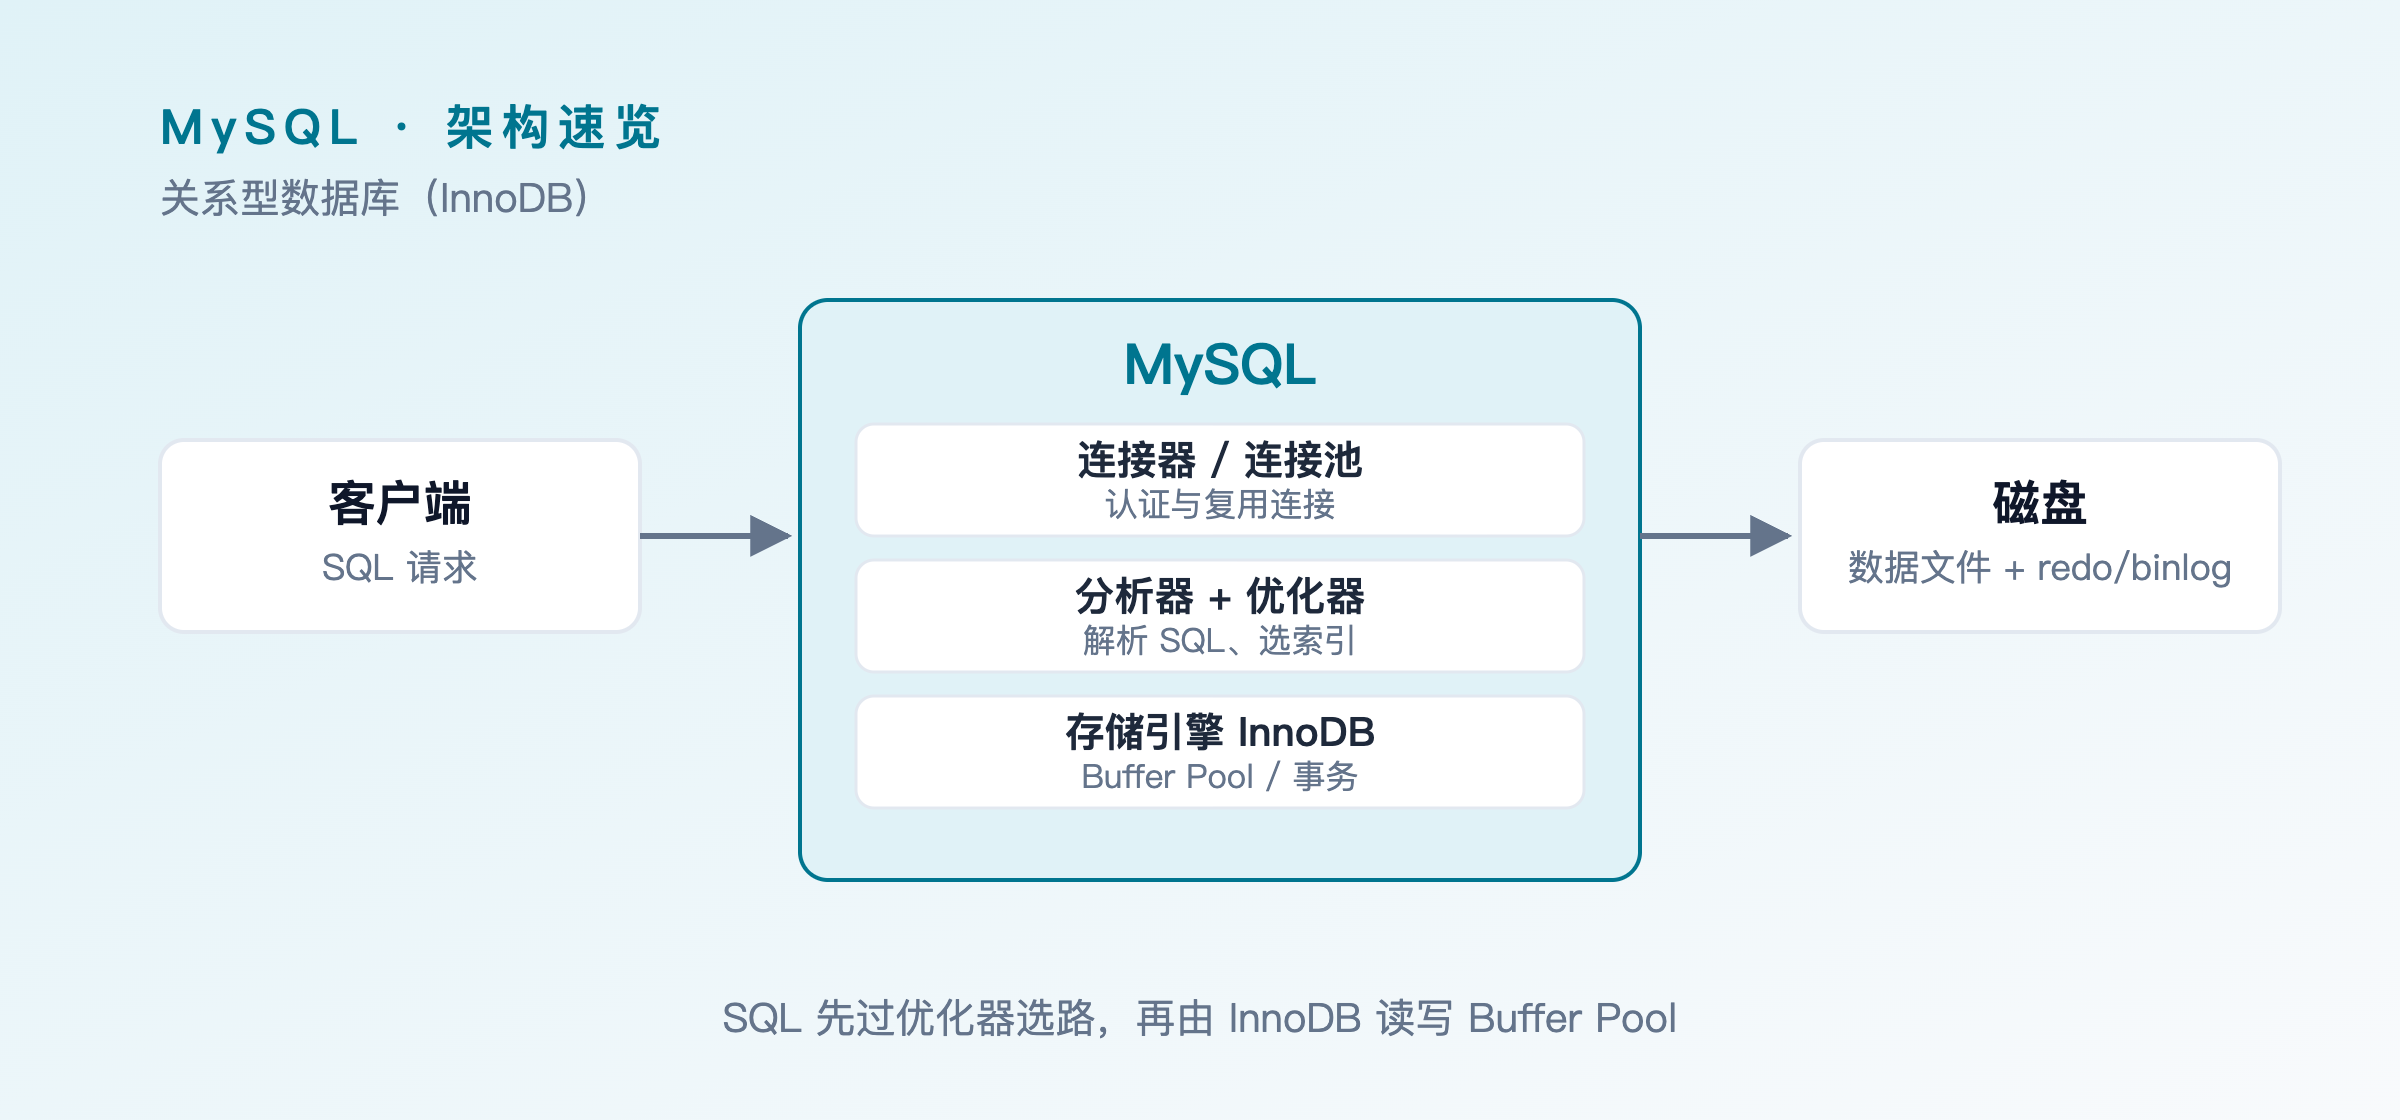
从上往下是三层,外加一个贯穿始终的文件系统:
| 层次 | 职责 | 关键对象 |
|---|---|---|
| 连接层 | 管理客户端连接、认证、权限校验、线程分配 | 连接线程、max_connections、mysql.user |
| 服务层 | 解析 SQL、优化执行计划、执行、内置函数、binlog | 解析器、优化器、执行器、查询缓存(8.0 已移除) |
| 存储引擎层 | 真正读写数据、事务、锁、索引 | InnoDB、MyISAM、MEMORY 等插件式引擎 |
| 文件系统 | 数据文件、redo log、undo log、binlog 落盘 | ibdata、ib_logfile、binlog |
一句话概括:连接层管「谁能进来」,服务层管「SQL 怎么算」,存储引擎层管「数据怎么存」。8.0 之后服务层和引擎层的边界更清晰,因为元数据(数据字典)也统一收进了 InnoDB。
老架构图里经常有 Query Cache 这一块。它在 MySQL 5.7 里就已经是鸡肋(任何一点写入都会让整张表的缓存失效),8.0 直接删掉了。看到旧资料讲 query_cache_size,直接跳过。
连接层
客户端连上 MySQL 的第一站。这一层做的事情不多,但每件都能出故障:
- 建立 TCP 连接:默认监听 3306,
bind-address决定监听哪个地址。连不上第一反应查网络、防火墙和bind-address。 - 认证:核对用户名、密码、来源 host,8.0 默认认证插件是
caching_sha2_password。老客户端(比如 5.x 的驱动)不认这个插件,会报Authentication plugin 'caching_sha2_password' cannot be loaded,要么升级客户端,要么把账号改成mysql_native_password。 - 权限加载:认证通过后把该账号的权限读进会话,后续每条语句的服务层校验都基于这份快照。所以
GRANT之后已存在的连接不会立刻生效,重新连一次才看得到新权限。 - 分配线程:MySQL 是「一连接一线程」(one-thread-per-connection),连接多了线程就多,上下文切换和内存开销跟着涨。
thread_cache_size缓存空闲线程,避免频繁创建销毁。
# 最常用的连接命令
mysql -h 127.0.0.1 -P 3306 -u app -p
-- 连上去第一件事:确认版本、账号和连接 ID
SELECT VERSION(), USER(), CONNECTION_ID();
连接数达到 max_connections 之后,新连接直接被拒:ERROR 1040 (HY000): Too many connections。这个值不是越大越好——每个连接都要占线程栈、排序缓冲、临时表内存,调大之前先算内存账。应急时可以靠 8.0 的 admin_address / admin_port 走独立端口挤进去(CONNECTION_ADMIN 权限),Percona 版本另有 extra_port。这块在第 8 篇「故障排查」里展开。
服务层
SQL 语句进入服务层后走一条固定的流水线,四步:
- 解析器(Parser):词法分析把 SQL 切成 token,语法分析按语法规则生成语法树。语法错了在这一步就报
ERROR 1064。 - 预处理器(Preprocessor):语义检查——表存不存在、列名对不对、
*展开成具体列,顺带做权限校验。这一步报的通常是Unknown column、Table doesn't exist。 - 优化器(Optimizer):核心。基于成本模型决定怎么执行:走哪个索引、多表 JOIN 的顺序、要不要做文件排序。同一个查询换个索引可能快十倍,差别就在这一步。想看优化器的决策过程,开
optimizer_trace。 - 执行器(Executor):按执行计划调用存储引擎的 handler 接口,一行行取数据、判断
WHERE、组装结果集返回客户端。
服务层还有一堆周边能力,都挂在这一层:内置函数、视图、触发器、存储过程、binlog(注意它记在服务层,不是引擎层,这是主从复制的基础)、元数据锁(MDL)。
-- 看看优化器到底选了哪条路
SET optimizer_trace = 'enabled=on';
SELECT * FROM orders WHERE user_id = 10086 AND status = 1;
SELECT * FROM information_schema.OPTIMIZER_TRACE\G
SET optimizer_trace = 'enabled=off';
优化器依赖统计信息(索引的基数、表的行数)估算成本。统计信息不准时,执行计划会「跑偏」——比如把选择性很好的索引算成了全表扫描。遇到「昨天还快今天慢」的查询,先 ANALYZE TABLE 刷新统计信息再观察。8.0 默认开启 innodb_stats_persistent 把统计信息持久化,但它依然会过期,不是一劳永逸。
存储引擎层
MySQL 的存储引擎是插件式的,建表时用 ENGINE= 指定,不同表可以用不同引擎。日常只需要记住三个:
| 引擎 | 特点 | 适用场景 |
|---|---|---|
| InnoDB | 支持事务、行锁、MVCC、崩溃恢复、外键,5.5 起的默认引擎 | 几乎所有业务表 |
| MyISAM | 表锁、不支持事务、索引和数据分开存,崩溃后可能损坏 | 历史遗留,不建议新表使用 |
| MEMORY | 数据全在内存、哈希索引、重启即丢 | 临时中间表、会话级缓存 |
从 5.5 开始 InnoDB 就是默认引擎,8.0 更是连数据字典都搬进了 InnoDB(存在 mysql.ibd 里)——information_schema 里的元数据都来自这批字典表。这件事的直接好处是:DDL 变成原子的,不会再出现「建表建到一半、.frm 有了但数据文件没建」的残局,.frm 这个文件也彻底消失了。
InnoDB 核心机制
InnoDB 之所以能扛住生产环境,靠的是三件套:Buffer Pool、事务、日志。逐个说。
Buffer Pool:一切性能的底座
InnoDB 以页(page,默认 16KB)为单位读写磁盘。Buffer Pool 就是内存里的一块页缓存,读写数据都先经过它:
- 读:要的页在内存里叫「命中」,直接返回;不在就叫「未命中」,从磁盘读进来再返回。命中率低于 99% 基本就是 Buffer Pool 太小。
- 写:修改的是内存里的页(变成「脏页」),不立刻写盘,后台线程按策略刷出去。写是异步的,这是 MySQL 写性能远高于随机写磁盘的根本原因。
innodb_buffer_pool_size 是最值得调的参数,一般给物理内存的 50%~70%(专用数据库机可到 80%)。它的内部 LRU 是分代的:新读进来的页先进「老年代」,被再次访问才晋升到「年轻代」,防止一次全表扫描把热数据全冲掉(innodb_old_blocks_time 控制晋升窗口)。
# 专用数据库服务器,128G 内存的常见配法
innodb_buffer_pool_size = 80G
innodb_buffer_pool_instances = 8
innodb_flush_method = O_DIRECT
容器里跑 MySQL,innodb_buffer_pool_size 要按容器内存限额算,不是宿主机内存。配超了的结果是 OOM Killer 找上门,进程被 kill 得莫名其妙。
事务与 ACID
事务是一组要么全做、要么全不做的操作。ACID 四个字母分别对应 InnoDB 的一个机制:
- A(原子性):靠 undo log。回滚时按 undo 记录把修改反向做一遍。
- C(一致性):是结果,不是机制——约束、唯一索引、外键、业务逻辑共同保证。
- I(隔离性):靠锁 + MVCC(多版本并发控制,读不加锁,读的是 undo 里的历史版本)。
- D(持久性):靠 redo log。提交时日志落盘(
innodb_flush_log_at_trx_commit=1),数据页可以慢慢刷。
START TRANSACTION;
UPDATE account SET balance = balance - 100 WHERE id = 1;
UPDATE account SET balance = balance + 100 WHERE id = 2;
COMMIT;
事务的生命周期越长,持有的锁和 undo 越多,长事务是很多故障的根源(undo 膨胀、主从延迟、锁等待)。第 4 篇讲隔离级别,第 8 篇讲长事务怎么抓。
redo log、undo log、binlog 的分工
这是面试高频题,也是理解 MySQL 数据安全的关键。三种日志各管一段:
| 日志 | 所在层 | 记录内容 | 作用 | 关键参数 |
|---|---|---|---|---|
| redo log | InnoDB | 物理页的修改(「在哪个页的哪个偏移改了什么」) | 崩溃恢复,保证已提交事务不丢(D) | innodb_redo_log_capacity、innodb_flush_log_at_trx_commit |
| undo log | InnoDB | 修改前的旧值 | 事务回滚(A)+ MVCC 读历史版本(I) | 自动管理,innodb_undo_log_truncate 控制回收 |
| binlog | 服务层 | 逻辑变更(语句或行) | 主从复制 + 按时间点恢复 | binlog_format、sync_binlog、binlog_expire_logs_seconds |
记忆口诀:redo 管「怕丢」,undo 管「后悔」,binlog 管「复制和备份」。
redo log 是环形写的:空间固定,写满一圈就得停下来等脏页刷盘(checkpoint),所以 redo 太小会导致周期性卡顿。8.0.30 之后用 innodb_redo_log_capacity 统一管理,之前是 innodb_log_file_size 乘 innodb_log_files_in_group。
两阶段提交:redo 和 binlog 怎么对齐
一份数据改了两处日志,就存在「一个成功一个失败」的不一致风险。MySQL 用内部 XA 两阶段提交解决:
1. 事务修改:redo log 写 prepare 状态
2. 写 binlog 并 fsync
3. redo log 标记 commit
崩溃恢复时的判断规则很简单:
- binlog 完整(事务的 binlog 有提交标记)→ 提交事务。
- binlog 不完整 → 回滚事务。
这样主库和从库、备份和原库的数据才能对得上。理解这一点,就理解了为什么 sync_binlog=1 和 innodb_flush_log_at_trx_commit=1 是「双 1」——牺牲一点写性能换数据不丢。
索引模型
B+ 树
InnoDB 的索引是 B+ 树,不是二叉树、不是哈希(除了自适应哈希索引这个内部优化):
- 只有叶子节点存数据,非叶子节点只存键和指针,所以一个 16KB 的页能塞很多键,树高很低。
- 叶子节点用双向链表串起来,范围查询(
BETWEEN、>)顺着链表扫就行,不用回到根节点。 - 所有叶子在同一层,任何一次查找的 IO 次数都一样,查询耗时稳定。
粗算一下:主键是 BIGINT(8 字节)+ 页指针 6 字节 ≈ 14 字节,一个非叶子页能放约 1170 个键;叶子页假设一行 1KB,能放 16 行。三层 B+ 树 = 1170 × 1170 × 16 ≈ 2000 万行。也就是说两千万行的表,按主键查一次最多 3 次页访问,而这三次大概率都在 Buffer Pool 里——这就是 InnoDB 索引高效的原因。
聚簇索引与二级索引
InnoDB 是索引组织表(index-organized table):数据本身就存在主键的 B+ 树里,这张树叫聚簇索引(clustered index)。
- 表没有主键时,InnoDB 会选第一个非空唯一索引,都没有就生成一个 6 字节的隐藏
ROW_ID。 - 所以主键一定要短且有序:自增
BIGINT是最优解,随机 UUID 会导致页分裂和随机写。
二级索引(也叫辅助索引)是另一棵独立的 B+ 树,叶子节点存的是「索引列的值 + 主键值」。用它查数据要两步:
二级索引树查到主键 id
  → 拿 id 回聚簇索引树取整行数据
第二步就叫回表。回表是随机 IO,一次查 1000 行就可能回表 1000 次,这就是「明明有索引还是慢」的常见原因。
如果查询需要的列全在二级索引里,就不用回表了,这叫覆盖索引。把 SELECT * 改成只查必要列,或者把常用列加进联合索引,往往能直接把回表次数降到 0。第 4 篇会拿 EXPLAIN 的 Extra: Using index 来验证。
一条查询的完整路径
把上面的组件串起来,一条 SELECT 的旅程是这样:
客户端
  → 连接层:TCP 握手、认证、权限快照、分配线程
  → 解析器:词法/语法分析,生成语法树
  → 预处理器:语义检查、权限校验
  → 优化器:选索引、定 JOIN 顺序,生成执行计划
  → 执行器:调用 InnoDB handler 接口
  → Buffer Pool:命中直接返回,未命中从磁盘读页
  → 返回结果集,写慢查询日志(如果超阈值)
一条 UPDATE 则多出后半段:写 undo → 改 Buffer Pool 里的页 → 写 redo(prepare)→ 写 binlog → redo commit → 后台刷脏页。
慢查询日志的耗时是服务器端从收到语句到执行完成的时间,不包括网络传输和客户端处理时间。所以客户端觉得慢、慢日志里却没有,先怀疑网络和结果集太大,而不是数据库。
小结
- MySQL 分三层:连接层管连接和认证,服务层管解析优化执行,存储引擎层管数据怎么存;8.0 把元数据也收进了 InnoDB,DDL 变原子。
- InnoDB 的性能底座是 Buffer Pool,读写都过内存,脏页异步刷盘;
innodb_buffer_pool_size是最该调对的参数。 - 事务 ACID 靠三样东西落地:undo 管回滚和 MVCC,redo 管崩溃恢复,binlog 管复制和备份;两阶段提交保证 redo 和 binlog 一致。
- 索引是 B+ 树,数据存在聚簇索引的叶子里;二级索引叶子存主键,查非索引列要回表,覆盖索引可以免掉回表。
- 排查问题的顺序:先看是哪一层的事(连接?执行计划?Buffer Pool?日志?),再往下钻。
概念铺完,下一篇《安装与快速上手》在 Ubuntu 22.04 上把 MySQL 8.0 装起来,做完安全初始化,再建库建表建用户,把环境跑通。