Nginx 核心概念与架构
Nginx 大概是运维日常接触频率最高的中间件:前面挡流量,后面接应用,中间顺手做 HTTPS、压缩、缓存和限流。它配置看着简单,但「为什么这么写」「为什么不生效」的问题,多半要回到架构和配置层级上找答案。这篇先把地基打牢:它到底解决什么问题、进程怎么跑、配置怎么分层,以及 upstream、proxy_pass、location 这几个绕不开的核心概念。
为什么用 Nginx
一句话概括:它用一套配置同时干好了三件事——托管静态文件、做反向代理、做负载均衡。绝大多数站点从单机到集群,都是在这三件事上渐进演化的。
| 角色 | 解决的问题 | 典型配置 |
|---|---|---|
| 静态资源服务器 | 图片、JS、CSS、前端打包产物直接由 Nginx 吐出去,不占用应用进程 | root、try_files、expires |
| 反向代理 | 对外只暴露 80/443,把请求转给本机或内网的应用端口,顺带做 TLS 终结 | proxy_pass、proxy_set_header |
| 负载均衡 | 一个域名后面挂多台应用实例,按策略分流并做故障摘除 | upstream、server、max_fails |
除了这三件主业,还有几件「顺手就做了」的事,也是生产环境常见的用法:
- TLS 终结:证书统一在 Nginx 上管,后端应用只跑明文 HTTP,证书续期只动一处。
- 压缩与缓存:
gzip压文本资源,proxy_cache把后端响应缓存到本地磁盘,扛住热点。 - 限流与鉴权:
limit_req按 IP 限速,auth_basic做一层简单的访问控制。 - 灰度与重定向:按
$http_*、Cookie、来源 IP 分流到不同的 upstream,或者用return做整站跳转。
Nginx 擅长的是「连接管理 + 转发」,不是「业务逻辑」。把复杂的鉴权、路由规则、请求改写全塞进 Nginx 配置,最后会得到一份没人敢改的巨型配置文件。这类需求放到应用层或 API 网关(Kong、APISIX、Envoy)更合适。真要在 Nginx 里写逻辑,那是 OpenResty 的领域,属于另一个话题。
进程模型
Nginx 启动后不是一个进程在干活,而是一组:一个 master 进程 + N 个 worker 进程,另外可能还有 cache manager 和 cache loader 两个辅助进程(只有开了 proxy_cache 才有)。
                    ┌─────────────────────────────┐
                    │        master process       │
                    │  读配置 / 绑定端口 / 管信号   │
                    └───────────┬─────────────────┘
                                │ fork
          ┌─────────────────────┼─────────────────────┐
          ▼                     ▼                     ▼
   ┌─────────────┐       ┌─────────────┐       ┌─────────────┐
   │  worker 1   │       │  worker 2   │  ...  │  worker N   │
   │  事件循环    │       │  事件循环    │       │  事件循环    │
   │  epoll      │       │  epoll      │       │  epoll      │
   └─────────────┘       └─────────────┘       └─────────────┘
两种进程的分工非常清晰:
- master:以 root 启动,负责读配置、绑定 80/443 端口、派生 worker、接收信号(reload、quit、reopen 都发给它)。它自己不处理任何请求。
- worker:真正干活的进程,以
user指令指定的低权限用户运行(Ubuntu 上是www-data),每个 worker 内部是一个单线程事件循环。
单线程 + epoll 为什么快
传统 Apache 的 prefork 模型是「一个连接一个进程」,1000 个并发连接就是 1000 个进程,内存和上下文切换开销都吃不消。Nginx 走的是另一条路:
- 一个 worker 只用一个线程,但用 epoll 同时监听成千上万个 socket。
- 没有请求处理时就阻塞在
epoll_wait上,内核说哪个 fd 可读了才去读,不做任何轮询和等待。 - 请求处理全程非阻塞:读文件、连上游、写响应都靠事件驱动,不会因为一个慢请求把整个 worker 卡住。
所以 Nginx 的内存占用大致是「固定基线 + 每连接少量缓冲」,几万并发在几十 MB 内存里跑完,这不是魔法,是模型决定的。
worker 是单线程的,任何一次阻塞都会拖住这个 worker 上的所有连接。第三方模块里做同步磁盘 IO、同步 DNS 解析、调用外部脚本,都是典型的踩坑来源。这也是为什么 Nginx 的模块生态强调「必须非阻塞」。
几个和进程相关的参数
# worker 数量:auto 等于 CPU 核数,生产基本都用 auto
worker_processes  auto;

# 每个 worker 能同时打开的文件描述符数,包括连接和本地文件
worker_rlimit_nofile  65535;

events {
    # 单个 worker 允许的最大并发连接数
    worker_connections  10240;
    # Linux 下默认就是 epoll,一般不用显式写
    use epoll;
}
三个数字的关系值得记一下:理论最大并发连接数 ≈ worker_processes × worker_connections。但要注意,反向代理场景下一个客户端请求会占用两个连接(客户端到 Nginx、Nginx 到上游),所以实际能扛的客户端数是这个乘积的一半左右。这个值还必须小于系统的 ulimit -n,否则日志里会看到 too many open files,排障细节放在第 6 篇。
架构图
从请求进来到响应出去,Nginx 内部的分层大致是这样:
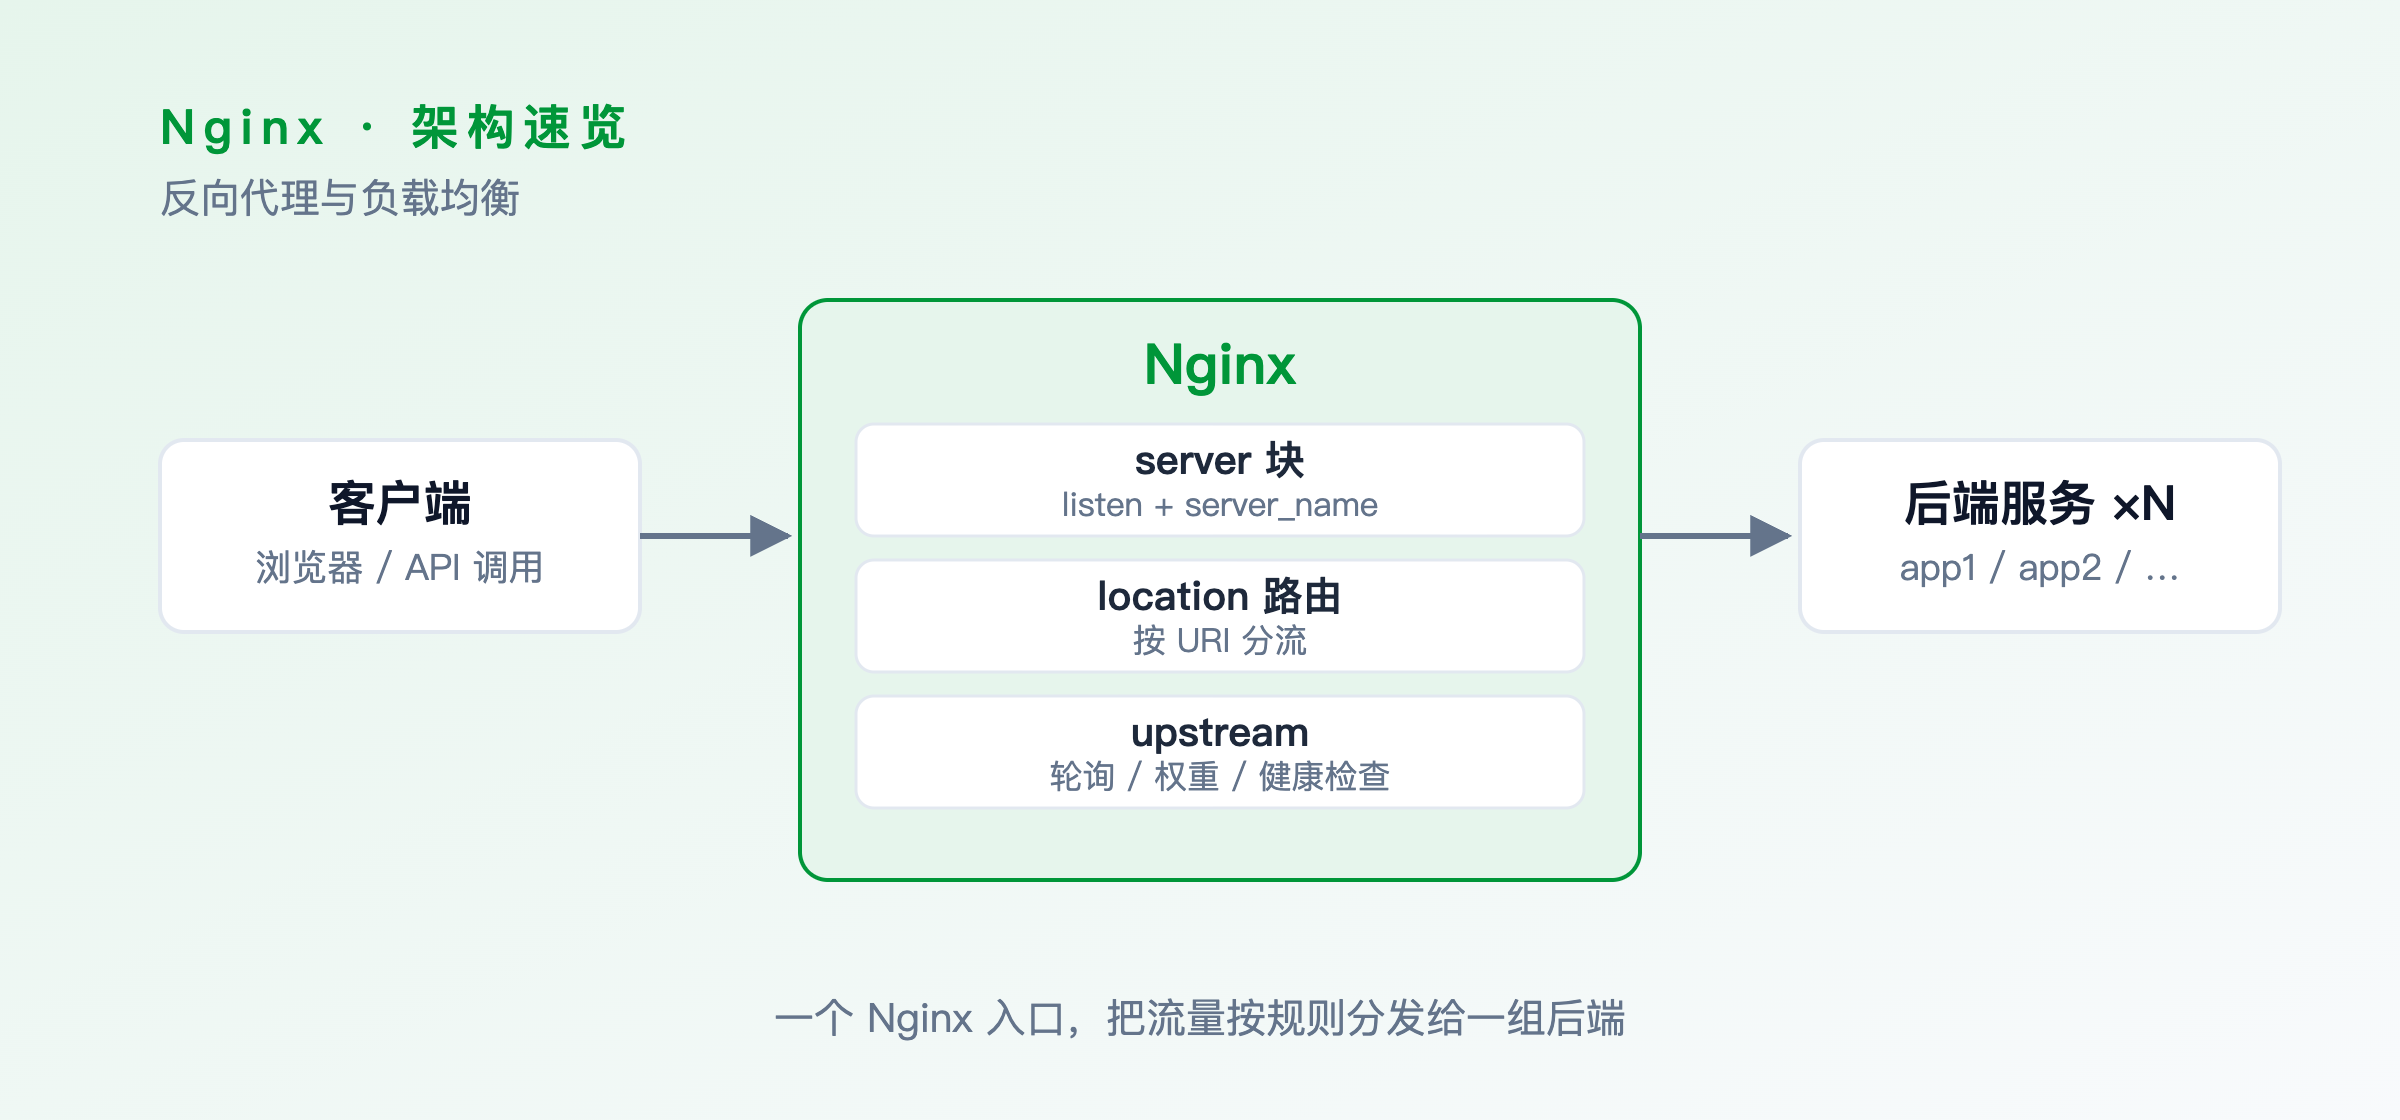
对照上图理解三个关键点:
- master/worker 分离:配置变更、二进制升级只需要动 master,worker 可以平滑替换,服务不中断。
- 事件驱动核心:所有连接都由 epoll 统一管理,worker 之间互不通信,靠共享内存(
zone)交换限流、缓存这类状态。 - 模块化处理链:一个请求依次经过 access、content、log 各阶段,
location决定由哪个 content 模块处理——是读本地文件,还是转发给 upstream。
配置结构
Nginx 的配置是树形嵌套的,理解层级比背指令更重要。安装后的目录大致长这样:
/etc/nginx/
├── nginx.conf              # 主配置,一切的入口
├── conf.d/                 # 站点配置,被主配置 include 进来
│   ├── default.conf
│   └── api.conf
├── sites-available/        # Ubuntu 包管理的约定,存放可用站点
├── sites-enabled/          # 软链到 sites-available,只加载这里面的
├── mime.types              # 扩展名到 Content-Type 的映射
├── fastcgi_params          # FastCGI / PHP 相关参数
└── snippets/               # 可复用的配置片段

/var/www/html/              # 默认站点根目录
/var/log/nginx/             # access.log / error.log,源码编译时在 prefix 下
Debian/Ubuntu 的包默认同时存在
conf.d/*.conf和sites-enabled/*两套 include,二者都会被加载。自己新建站点时选一套用就行,混着写容易「明明没启用却生效了」。
配置本身的嵌套层级是固定的五层:
# main 层:全局唯一,进程级行为
user  www-data;
worker_processes  auto;

# events 层:连接处理相关
events {
    worker_connections  10240;
}

# http 层:所有 HTTP 行为的公共配置
http {
    include       mime.types;
    default_type  application/octet-stream;
    sendfile      on;
    keepalive_timeout  65;

    # upstream 定义在 http 层,供 server 引用
    upstream app_backend {
        server 127.0.0.1:8080;
    }

    # server 层:一个虚拟主机 = 一组 listen + server_name
    server {
        listen       80;
        server_name  example.com;

        # location 层:按 URI 匹配,决定怎么处理
        location / {
            root   /var/www/html;
            index  index.html;
        }

        location /api/ {
            proxy_pass  http://app_backend;
        }
    }
}
层级之间有两条规矩:
- 指令有上下文限制:
worker_processes只能写在 main 层,server只能写在http里,location只能写在server或location里。位置写错,nginx -t会直接报"xxx" directive is not allowed here。 - 指令向下继承:写在
http的gzip on对所有server生效;某个server里再写一次gzip off,就只覆盖这个虚拟主机。但继承是「整体覆盖」不是「合并」——父层写了proxy_set_header Host $host,子层再写一个proxy_set_header X-Real-IP ...,父层那条就丢了,必须两条一起重写。
核心概念
upstream:把后端实例编成一组
upstream 定义一个后端集群,proxy_pass 直接引用这个名字,Nginx 自己负责选实例、重试和摘除:
upstream app_backend {
    server 10.0.0.11:8080  weight=3 max_fails=3 fail_timeout=10s;
    server 10.0.0.12:8080  weight=1;
    server 10.0.0.13:8080  backup;   # 前两台都挂了才启用
}
默认是轮询,加上 weight 就变成加权轮询;还有 ip_hash、least_conn 等策略,负载均衡的完整写法在第 3 篇。这里先记住一点:upstream 里的 server 是后端地址,不是对外监听的端口,两者别混。
proxy_pass:转发,以及那个尾斜杠
proxy_pass 的语义全看末尾有没有 /,这是新手最容易踩的坑:
| 写法 | 请求 /api/users 实际转发到 |
|---|---|
proxy_pass http://backend; | http://backend/api/users(URI 原样带上) |
proxy_pass http://backend/; | http://backend/users(location 匹配的部分被替换成 /) |
proxy_pass http://backend/v1/; | http://backend/v1/users |
配合正则 location 时还有一条硬约束:location 里用了正则,proxy_pass 就不能带 URI(不能有 / 结尾的路径),否则 nginx -t 报 "proxy_pass" cannot have URI part in location given by regular expression。要改写路径就用 rewrite ... break; 再转发。
location:匹配优先级才是重点
location 的匹配不是「从上到下第一个命中」,而是有一套固定优先级。按从高到低排:
| 优先级 | 语法 | 说明 |
|---|---|---|
| 1 | location = /path | 精确匹配,命中就停,不再看别的 |
| 2 | location ^~ /prefix/ | 前缀匹配且不再检查正则,命中就用它 |
| 3 | location ~ pattern | 正则匹配,区分大小写,按配置里出现的顺序取第一个 |
| 4 | location ~* pattern | 正则匹配,不区分大小写,同样按顺序 |
| 5 | location /prefix/ | 普通前缀匹配,取最长的那个 |
举一个能覆盖大部分场景的例子:
server {
    listen 80;
    server_name example.com;

    # 1. 精确命中,优先级最高
    location = /health {
        return 200 "ok\n";
    }

    # 2. 前缀 + ^~:命中后不再试正则,适合静态目录
    location ^~ /static/ {
        root /var/www;
        expires 30d;
    }

    # 3. 正则:大小写敏感,注意顺序
    location ~ \.(jpg|png|webp)$ {
        root /var/www/images;
        expires 7d;
    }

    # 4. 普通前缀:兜底
    location / {
        proxy_pass http://app_backend;
    }
}
三条实战经验:
^~是给「不想被正则抢走」的前缀用的。/static/目录下如果有.php文件,不加^~就会被正则 location 截胡。- 正则 location 的顺序有意义,写反了就是另一个结果。能用前缀就用前缀,正则只在真需要时才上。
=适合健康检查和固定路径,比如/health、/favicon.ico,命中即返回,链路最短。
@namedlocation 可以嵌套,但嵌套后外层的前缀会被剥离再匹配内层,实际项目里用得很少。更常用的是命名 location(location @fallback),配合 try_files ... @fallback 做兜底,SPA 场景的标准写法见第 3 篇。
小结
- Nginx 的主业就三件:静态托管、反向代理、负载均衡,TLS 终结、压缩缓存、限流是顺手的附加值。
- 进程模型是 master 管配置和端口、worker 跑单线程事件循环(epoll),所以并发高、内存省;前提是绝不能阻塞。
- 配置是五层嵌套:main → events → http → server → location,指令有上下文限制,向下继承但整体覆盖不合并。
- 三个核心概念:upstream 定义后端集群,proxy_pass 负责转发(尾斜杠决定是否改写 URI),*location 按固定优先级匹配(= > ^~ > ~ > ~ > 普通前缀最长)**。
- 最大并发 ≈
worker_processes × worker_connections(反向代理要除以 2),且必须小于ulimit -n。
概念清楚了,下一篇直接动手:安装与快速上手——三种安装方式、目录约定,以及第一个能跑起来的反向代理。