PostgreSQL 核心概念与架构
为什么值得花时间学 PostgreSQL
很多团队用 PostgreSQL 的起点都是「MySQL 够用,但有个需求它做起来别扭」:复杂的多表统计、JSON 字段查询、地理距离排序,或者要装一个扩展。真用起来会发现,它不是「另一个 MySQL」,而是另一套设计哲学:
- 进程隔离:每个连接一个独立后端进程,地址空间不共享;但 backend 异常崩溃会触发 postmaster 终止所有连接并做崩溃恢复,不是「一个连接挂了其他照常跑」。
- WAL 先行:所有修改先写日志再刷数据页,崩溃恢复、流复制、PITR 都建立在同一套日志上。
- MVCC 彻底:读写互不阻塞,读永远不会被写挡住,也不存在 MySQL 里那种「快照读」和「当前读」的割裂。
- 扩展性:索引类型、数据类型、插件体系都允许你往数据库里加东西,而不是只能等官方发版。
本篇把这些底层机制讲清楚,后面的安装、使用、运维、排障都建立在这些概念上。
整体架构
先看图:
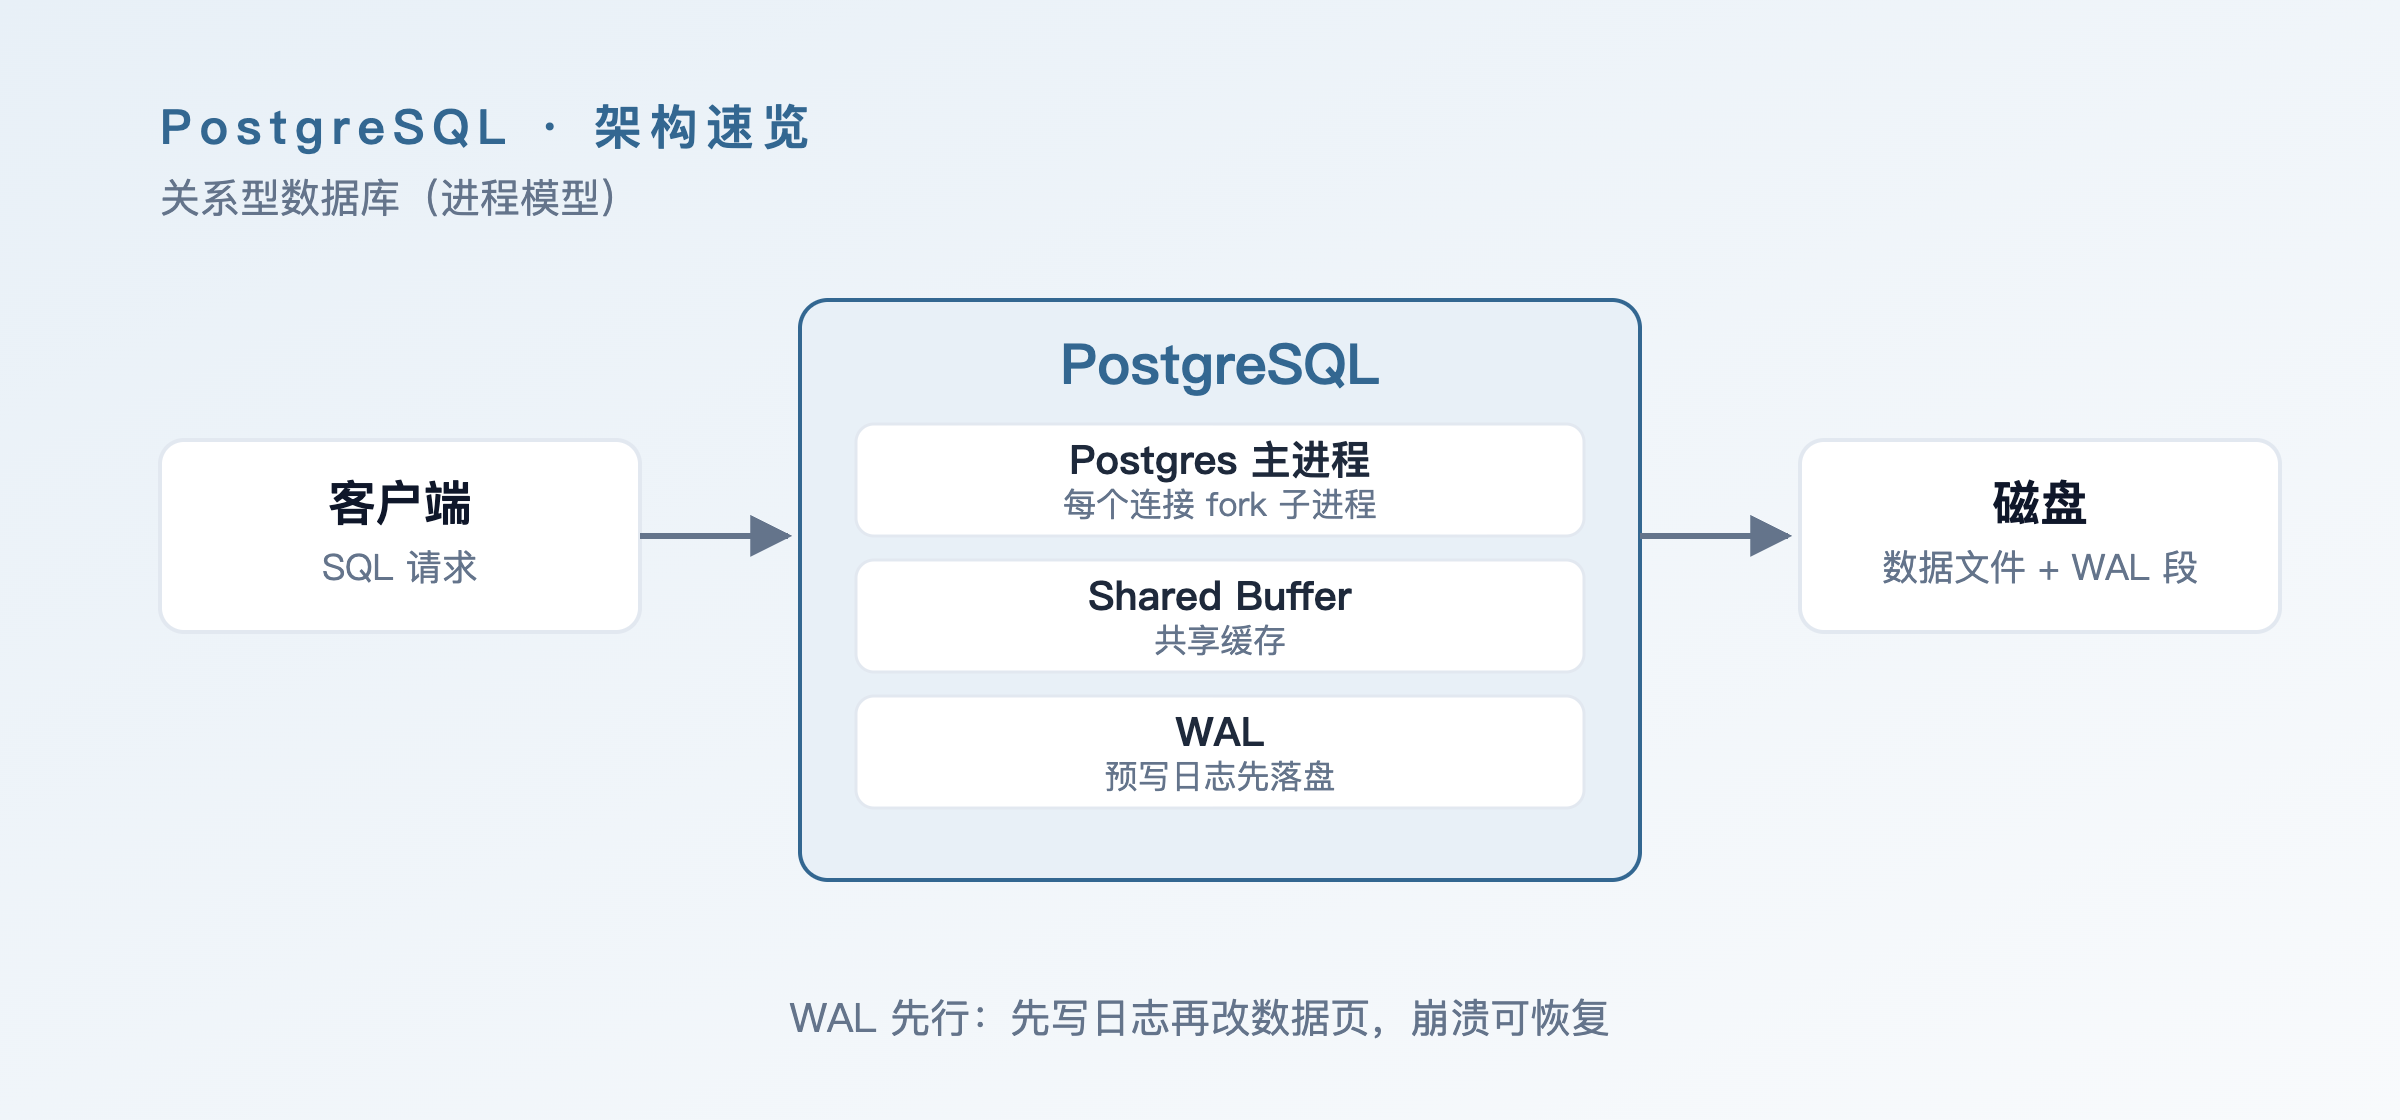
图里可以拆成四层来理解:
- 客户端层:应用通过 libpq 协议连上来,psql、各种语言的驱动、连接池都在这一层。
- 服务进程层:
postmaster主进程负责监听端口、fork 后端进程;每个连接对应一个 backend 进程。 - 后台辅助进程:checkpointer、background writer、walwriter、autovacuum launcher、archiver、logical replication launcher 等,各管一摊。
- 存储层:共享内存里的 Shared Buffer 和 WAL Buffer,磁盘上的数据文件、WAL 段文件、归档目录。
和 MySQL 最大的观感差异就在第二层:MySQL 是一个进程里开线程池处理所有连接,PostgreSQL 是「一个连接一个进程」。这个选择直接决定了后面的连接数管理、内存估算和故障隔离方式。
进程模型:postmaster 与 backend
postmaster 是常驻的父进程,启动时完成几件事:读配置、初始化共享内存、启动后台进程、监听 5432 端口。之后它的核心工作只有一个——每来一个连接就 fork 一个 backend 进程,然后把连接交给它。backend 正常退出不影响别人;异常崩溃则 postmaster 会重启整个实例,postmaster 自己挂了更是整个实例一起完蛋。
这套模型有几个直接后果:
- 连接是重资源:每个 backend 有独立的地址空间,还要挂上共享内存、Catalog Cache、计划缓存。开几千个连接,光进程切换和内存开销就能把机器拖垮。
- 故障处理偏保守:异常崩溃(段错误、被 OOM killer 杀掉)会让 postmaster 重启整个实例,保证共享内存和 WAL 的一致性。所以「进程模型隔离性好」指的是地址空间,不是故障域。
- 连接要池化。生产上必须用 PgBouncer 之类的连接池把「应用连接数」和「数据库连接数」解耦,这一点在第 6 篇展开。
后台进程各司其职,日常排障时经常会看到它们的名字:
| 进程 | 职责 |
|---|---|
| checkpointer | 定期做检查点,把脏页刷盘并记录 redo 位置,缩短崩溃恢复时间 |
| background writer | 持续把脏页慢慢写出,平滑刷盘压力 |
| walwriter | 持续把 WAL Buffer 写到 WAL 文件,平滑写入压力(提交时的 fsync 仍由 backend 负责) |
| autovacuum launcher | 拉起 autovacuum worker,回收死元组、更新统计信息 |
| archiver | 按 archive_command 把 WAL 段归档,PITR 的基础 |
| logical replication launcher | 管理逻辑复制的 apply worker |
| stats collector | 15 之前是独立进程,15 起改成共享内存统计,不再单独出现 |
| 对比项 | PostgreSQL | MySQL(InnoDB) |
|---|---|---|
| 连接处理 | 每连接一个 backend 进程 | 线程池/每连接一线程 |
| 连接开销 | 高,进程级内存与上下文切换 | 低,线程更轻 |
| 连接数上限 | 通常几百到几千,靠连接池扛 | 可以开到几千甚至上万 |
| 故障隔离 | backend 地址空间隔离,异常崩溃触发实例级恢复 | 线程共享地址空间,崩溃同样影响整个实例 |
| 共享内存 | 显式配置 shared_buffers | innodb_buffer_pool_size |
两者没有绝对优劣:MySQL 的连接模型更适合「大量短连接 + 简单查询」,PostgreSQL 的进程模型配合连接池更适合「复杂查询 + 长事务」。看到 PostgreSQL 连接数报警,第一反应应该是上连接池,而不是无脑调大 max_connections。
Shared Buffer 与 WAL
读写在内存里怎么走
PostgreSQL 的数据文件按 8KB 页组织。一次查询要读某一行,流程是:先在 Shared Buffer 里找这个页,命中就直接用;没命中就从磁盘读进来,放进 Buffer Pool,再解析行。写操作则改 Buffer 里的页,把它标记为脏页,同时生成 WAL 记录。
这里的关键是:改完数据页并不立刻落盘。脏页留在内存里,等 checkpointer 或 background writer 找机会批量刷。这样随机写被合并成了顺序写,性能好得多。但内存里的脏页一旦掉电就没了,所以必须有一份日志兜底——这就是 WAL(Write-Ahead Log)。
先写日志,后刷数据页
WAL 的核心规则只有一条,却支撑了整个数据库的可靠性:
数据页落盘之前,对应的 WAL 记录必须已经落盘。
具体时序:
- 事务修改数据页,生成 WAL 记录写进 WAL Buffer。
- 事务提交时,提交的 backend 必须把 WAL 刷到 WAL 文件(
pg_wal/下的段文件)并完成 fsync,然后才返回提交成功;walwriter 平时会帮忙写出 WAL Buffer,减少提交路径上的写压力。 - 数据页仍然是脏的,安静地躺在 Shared Buffer 里。
- 检查点到来,checkpointer 把脏页刷盘,并在 WAL 里记录一个 redo 点。
- 崩溃重启后,从最近一次检查点的 redo 位置开始重放 WAL,把没刷盘的数据页补回来。
因为提交只需要保证 WAL 落盘(顺序写、量小),不需要等数据页随机写,所以 PostgreSQL 的写入延迟远低于「每次提交都刷数据页」的做法。代价是崩溃恢复要重放日志——检查点间隔越长,恢复越慢。生产上常用 checkpoint_timeout 和 max_wal_size 控制这个平衡。
几个必须知道的相关参数:
# postgresql.conf 关键项(16 版)
shared_buffers = 4GB              # 建议物理内存的 25% 左右,Linux 还有 page cache 兜底
wal_level = replica               # 流复制至少 replica;逻辑复制需要 logical
max_wal_size = 4GB                # 两次检查点之间 WAL 的软上限,超过会触发检查点
min_wal_size = 1GB                # WAL 段保留的下限,避免频繁创建删除
checkpoint_timeout = 15min        # 检查点最长间隔
checkpoint_completion_target = 0.9 # 把刷盘摊到间隔的 90%,削峰
full_page_writes = on             # 崩溃后页撕裂保护,生产别关
有人为了省 WAL 把 full_page_writes 关掉,性能确实会好看一点,但一旦发生部分页写入(页撕裂),崩溃恢复就可能拿到损坏的数据页,只能从备份恢复。这笔账不划算。
崩溃恢复为什么能保证一致
恢复过程可以分两个层面理解:先重放 WAL 到一致点(redo),再处理未提交事务。PostgreSQL 没有独立的 undo 段——未提交事务改过的数据页虽然可能已经重放到磁盘,但对应元组通过 MVCC 可见性判断为不可见,后续由 VACUUM 清理。这也是为什么长时间运行的老事务会阻碍清理,第 6 篇会讲。
MVCC 与事务隔离
元组版本与快照
PostgreSQL 的 MVCC 实现方式是在行上留版本信息。每个元组头部有 xmin(创建它的事务 ID)和 xmax(删除/更新它的事务 ID),配合事务快照判断「这个版本对我可不可见」。
更新一行并不是原地改,而是插入一个新版本,把旧版本标记为已删除。所以:
- 读操作拿到快照后,按可见性规则挑版本,完全不需要加锁,也不会被写阻塞。
- 写操作之间靠行锁串行化,冲突时后到的事务等待。
- 旧版本不会立刻消失,要等没有事务能看见它了,由 VACUUM 回收。这就是「死元组」和「表膨胀」的来源。
四种隔离级别
PostgreSQL 实现了标准里的全部四个隔离级别,默认是 Read Committed:
| 隔离级别 | 行为 | 典型问题 | 使用建议 |
|---|---|---|---|
| Read Uncommitted | 在 PG 里等价于 Read Committed | 脏读(PG 实际不会发生) | 基本不用 |
| Read Committed | 每条语句取一次新快照 | 同一事务内两次查询结果可能不同、不可重复读 | 默认,绝大多数 OLTP 够用 |
| Repeatable Read | 整个事务共用一个快照 | 不会不可重复读;写冲突时报错重试 | 报表、对账等要求事务内一致 |
| Serializable | 快照隔离 + SSI 冲突检测 | 串行化失败会报错,需要重试 | 强一致场景,必须配重试逻辑 |
设置方式:
-- 查看当前默认
SHOW default_transaction_isolation;

-- 会话级设置
SET SESSION CHARACTERISTICS AS TRANSACTION ISOLATION LEVEL REPEATABLE READ;

-- 单事务设置
BEGIN ISOLATION LEVEL SERIALIZABLE;
-- 业务 SQL
COMMIT;
PostgreSQL 的 Serializable 用的是 SSI(Serializable Snapshot Isolation),靠检测读写冲突来模拟串行执行,不做全表加锁。好处是并发度高,坏处是冲突时会主动 abort 事务,应用必须能识别 40001(serialization_failure)并重试。没有重试逻辑的业务,别随手开 Serializable。
和 MySQL 的差别
MySQL InnoDB 默认也是 Repeatable Read,但两边的语义并不完全一样:
- 快照时机:MySQL 的 RR 在事务里第一次普通 SELECT 时建快照;PostgreSQL 的 RR 在事务第一条语句执行时就固定快照。
- 当前读:MySQL 的
SELECT ... FOR UPDATE、UPDATE走当前读,能看到最新提交;PostgreSQL 的写操作也基于最新版本,但读一致性由快照决定,语义更统一。 - 间隙锁:MySQL 在 RR 下用间隙锁防幻读;PostgreSQL 不靠锁,靠快照和 SSI,所以不会出现间隙锁导致的死锁。
- 回滚成本:MySQL 有 undo log,回滚快;PostgreSQL 靠标记死元组,回滚本身很快,但清理要靠 VACUUM。
一句话总结:PostgreSQL 的 MVCC 更「纯粹」,读写不互相阻塞;代价是必须认真对待 VACUUM,否则表会膨胀。
与 MySQL 的定位差异
选型时不用争「谁更强」,看场景:
| 维度 | PostgreSQL | MySQL |
|---|---|---|
| 复杂查询 | 优化器更强,支持 hash join、merge join、CTE、窗口函数,复杂分析 SQL 写起来顺手 | 8.0 补齐了 CTE 和窗口函数,但复杂执行计划仍偏弱 |
| JSON | jsonb 有二进制存储、GIN 索引和丰富的操作符,能当半结构化数据库用 | JSON 类型可用,函数和索引能力相对有限 |
| 地理空间 | PostGIS 是事实标准,几何类型、空间索引、坐标转换齐全 | 有空间类型,但生态和函数丰富度差一截 |
| 扩展性 | 扩展机制成熟,pg_stat_statements、pgcrypto、TimescaleDB、Citus 等按需加载 | 插件生态以存储引擎为主,扩展能力弱 |
| 复制 | 物理流复制 + 逻辑复制,逻辑复制可跨版本、按表订阅 | 主从复制成熟,组复制(MGR)提供多写能力 |
| 并发模型 | 进程 + MVCC,读写不阻塞,连接数敏感 | 线程 + MVCC,连接数更宽容,间隙锁需注意 |
| 运维习惯 | 需要理解 VACUUM、WAL 归档、连接池 | 生态工具多,DBA 储备更普遍 |
把 MySQL 的参数习惯直接搬到 PostgreSQL 上最容易踩的坑:以为 shared_buffers 要开到内存的 70%(PG 通常 25% 就够,剩下交给 OS page cache);以为连接数可以随便开到几千(PG 要配连接池);以为删了数据空间立刻回来(PG 要 VACUUM)。这些差异都来自本篇讲的进程模型和 MVCC 设计。
小结
postmaster监听并 fork,每个连接一个 backend 进程;隔离性好但连接是重资源,生产必须配连接池。- 修改先写 WAL 再刷数据页,提交只等 WAL 落盘;崩溃后从检查点重放 WAL 恢复,
full_page_writes不能关。 - MVCC 靠元组版本和快照实现,读写互不阻塞;代价是死元组要靠 VACUUM 清理。
- 默认 Read Committed,Repeatable Read 事务级快照,Serializable 用 SSI 且必须处理重试。
- 和 MySQL 的差异集中在复杂查询、JSON、地理、扩展性和连接模型上,选型看场景,运维经验不能直接平移。
概念清楚了,下一篇《安装与快速上手》在 Ubuntu 22.04 上把 PostgreSQL 16 装起来,完成初始化和第一次连接。