Redis 核心概念与架构
为什么用 Redis
Redis 是一个把数据放在内存里的键值数据库,官方给自己的定位是「数据结构服务器」——不只是简单的 key-value,value 可以是字符串、哈希、列表、集合、有序集合,还能做位图、HyperLogLog、GEO、Stream。运维视角看,它出现在架构图里通常只有四类位置:
- 缓存:最主流的用法。把 MySQL 里的热点数据、复杂查询结果、页面片段放进 Redis,读请求先打 Redis,未命中再回源。单机十万级 QPS 很轻松,挡住大部分读流量后数据库压力立刻下来。典型写法是 Cache-Aside:读时先查缓存,写时先更新库再删缓存。
- 会话(Session):Web 服务多实例部署后,本地 session 就不成立了——第一次请求落在 A 实例,第二次落到 B 实例,登录态就丢了。把 session 存进 Redis,所有实例共享,服务本身变成无状态,扩缩容随意。Spring Session、PHP 的 session handler 都是这个套路。
- 队列:用 List 的
LPUSH+BRPOP做简单任务队列,或用 Stream 做带消费组、ACK 的消息队列。适合「轻量、允许少量丢失、不想为它单独维护一套 MQ」的场景;要做可靠投递、削峰填谷、多消费组广播,还是交给 Kafka。 - 计数器:
INCR是原子操作,天然适合点赞数、库存扣减、接口限流、UV 统计。配合EXPIRE做固定窗口计数,就是最常用的限流实现。
Redis 是内存数据库,不是「什么都能存」的万能存储。全量业务数据、需要复杂事务和 join 的关系型数据、需要持久化承诺的账务数据,都不该只有 Redis 一份。把它当缓存和加速层,永远保留回源能力,是最稳的姿势。
整体架构
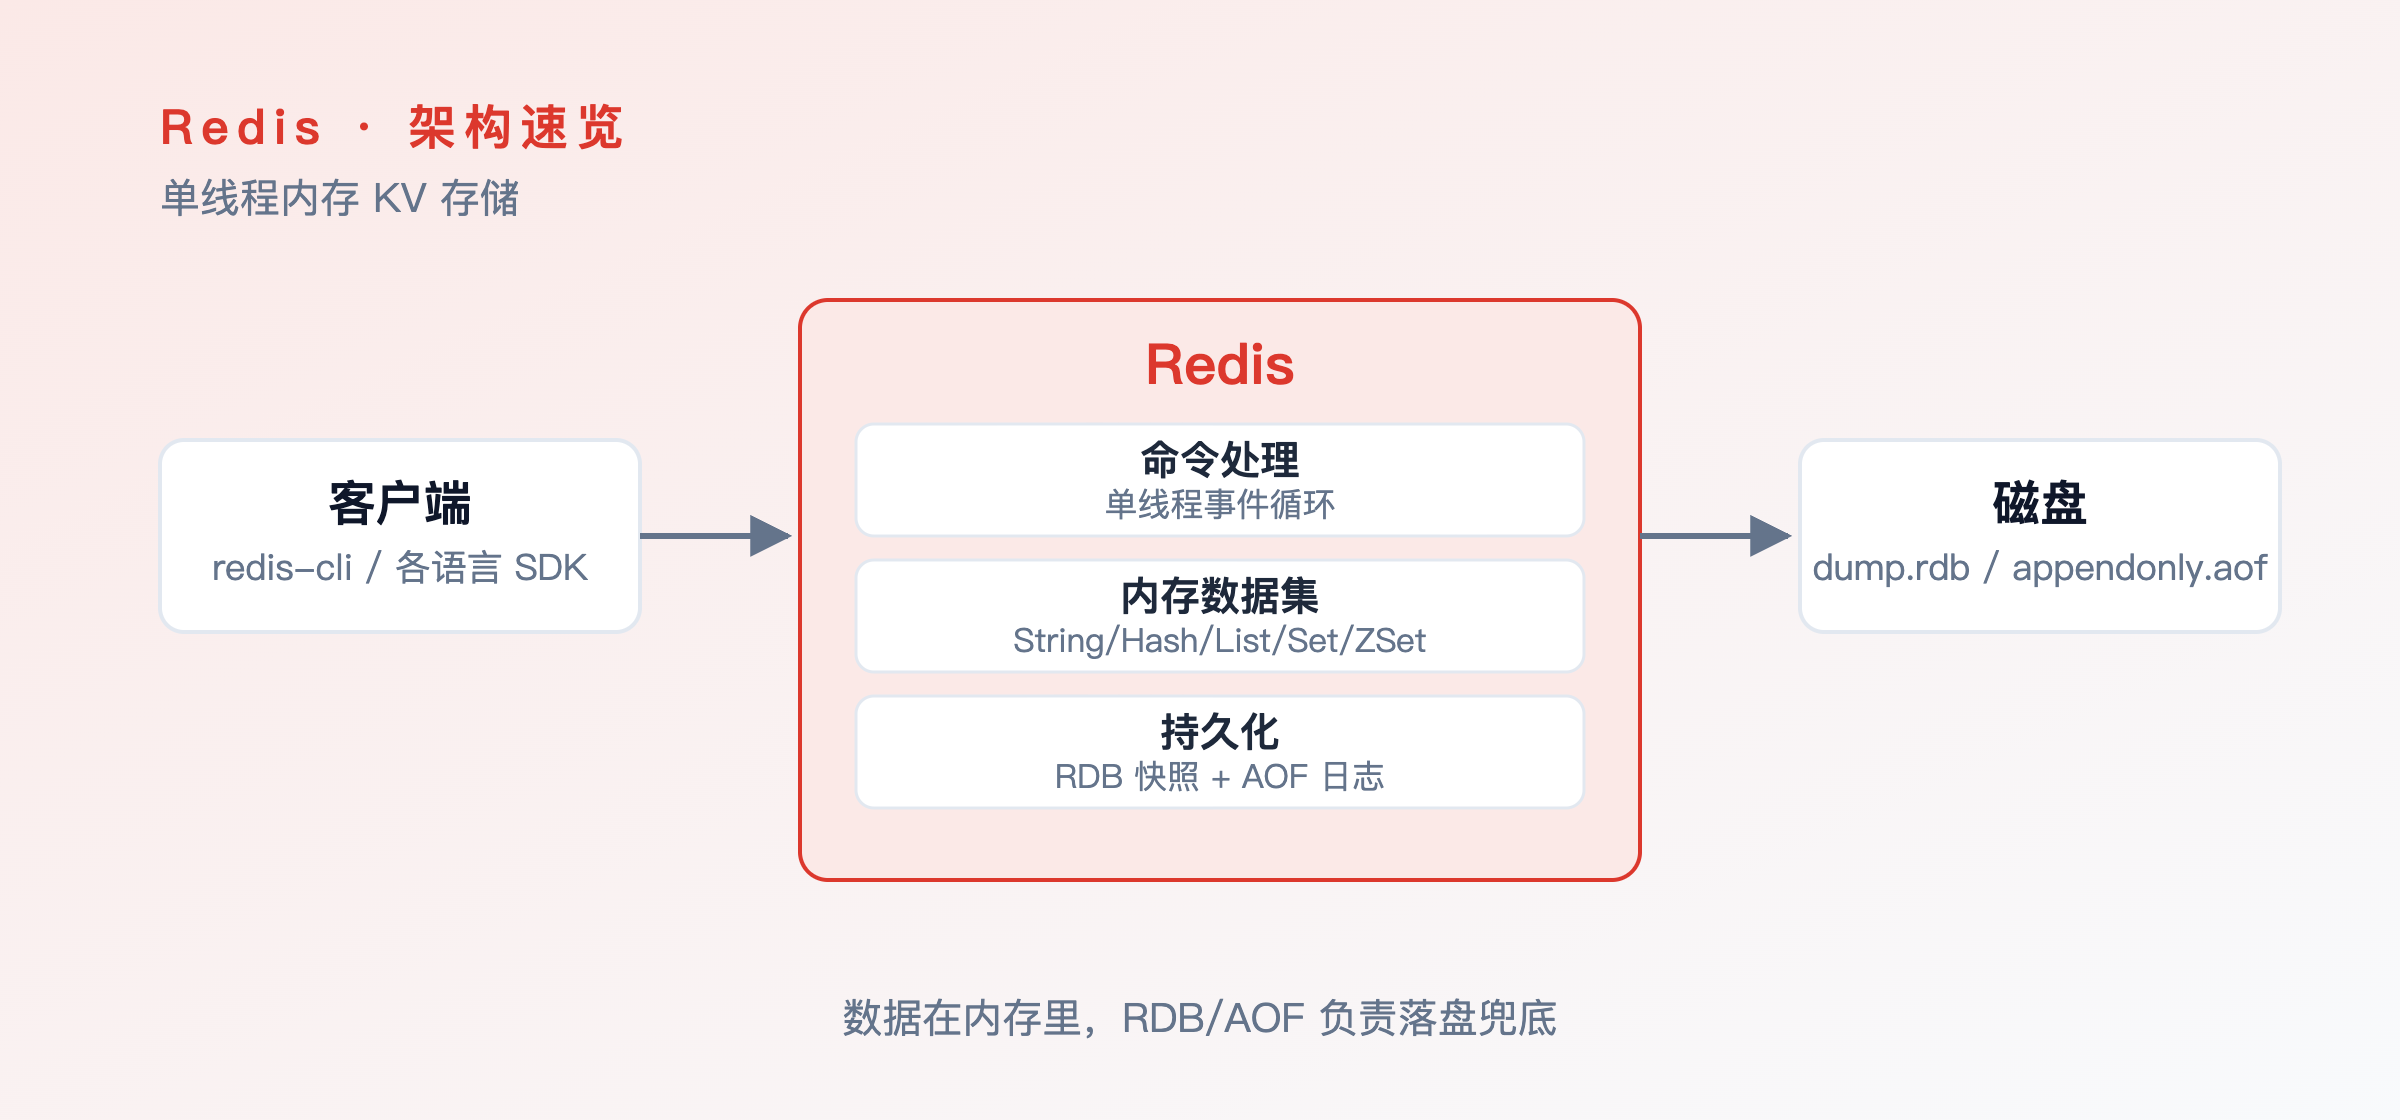
从下往上看这张图,Redis 一个进程里其实就四层:
- 网络层:监听 TCP 端口(默认 6379),用 epoll 做 IO 多路复用,把成千上万个连接上的可读事件收集起来,交给主线程按顺序处理。
- 命令执行层:单线程串行执行命令,一条命令从解析、查找 key、执行到写回响应,全程不切线程。慢命令会堵住后面所有请求,这是 Redis 最重要的脾气。
- 数据结构层:对外是五种基本类型,对内是一堆精心设计的编码(SDS、listpack、quicklist、intset、跳表等),同一种类型在不同数据量下会自动换编码,在不同场景下用空间换时间或反过来。
- 存储与持久化层:数据主体在内存里,由 jemalloc 管理;RDB 快照和 AOF 日志负责落盘;主从复制和 Cluster 负责把数据摊到多台机器上。
单线程为什么快
「单线程还快」是 Redis 最常被问的问题。快不是因为单线程,而是因为它把该省的成本全省了:
- 纯内存操作:一次内存访问是纳秒级,一次机械盘随机读写是毫秒级,差了几个数量级。Redis 的命令绝大多数只碰内存,不走磁盘(AOF 的 fsync 由后台线程或子进程处理),这是快的根本原因。
- IO 多路复用:一个线程用 epoll 同时盯住几万个 socket,谁有数据就处理谁,不需要「一个连接一个线程」。没有线程创建销毁、没有上下文切换,几万并发连接下 CPU 依然平稳。
- 无锁:命令串行执行,同一时刻只有一个命令在改数据,天然没有竞态,也就不需要任何加锁、解锁、CAS 重试。省掉的不只是锁开销,还有排查死锁的头发。
- 协议和实现都很轻:RESP 协议解析极简,核心操作是哈希表 O(1) 查找,数据结构编码针对小对象做了大量优化。
单线程意味着一条慢命令会阻塞所有客户端。KEYS * 扫百万 key、HGETALL 拿几万个字段、DEL 一个几百万元素的集合、复杂 Lua 脚本死循环,都会让整个实例卡住。生产上禁 KEYS、禁大 key、给 Lua 加超时,都是从这条特性推出来的规矩。
Redis 6.0 引入了 IO 多线程:读 socket、解析协议、写响应可以分给多个线程并行做,但命令执行仍然是单线程。所以「单线程」这个结论对数据一致性模型依然成立,只是网络收发的瓶颈被缓解了。相关配置是 io-threads,一般 4 核以上、QPS 打满单核时才值得开。
五大数据结构
每种类型一句话,先建立直觉:
| 类型 | 一句话 | 底层编码(小对象到大对象) | 典型用途 |
|---|---|---|---|
| String | 一个 key 对应一段字节,能存文本、JSON、数字、二进制 | int / embstr / raw(SDS) | 缓存对象、计数器、分布式锁、位图 |
| Hash | 一个 key 下再挂一层 field-value,像一行记录 | listpack 到 hashtable | 存对象的多个字段、购物车 |
| List | 双向链表,两头进出都快 | listpack 到 quicklist | 简单队列、最新列表、时间线 |
| Set | 无序不重复集合,支持交并差 | intset / listpack 到 hashtable | 去重、标签、共同好友 |
| ZSet | 每个元素带 score,按 score 自动排序 | listpack 到 skiplist + dict | 排行榜、延时队列、范围查询 |
选型口诀:
- 存整个对象、只读不改 → String 存 JSON,一次网络往返拿全量,简单直接。
- 对象字段频繁单独更新 → Hash,
HSET user:1 age 20只改一个字段,不用读出整个 JSON 再写回。 - 要顺序、要两端进出 → List;要「多个消费者各消费一份、支持 ACK 和回溯」→ Stream。
- 只要去重、要集合运算 → Set。
- 要排名、要按分数范围取 → ZSet。
Bitmap 用位存签到、活跃标记,一亿用户一年只要 4.5 GB;HyperLogLog 用 12 KB 估算亿级 UV,误差 0.81%;GEO 底层就是 ZSet,存经纬度算附近的人;Stream 是 5.0 引入的正经消息队列。它们不算「五大数据结构」,但都是同一套 key 体系下的命令组,遇到对应场景优先用,别自己拿 String 硬拼。
过期与淘汰
过期删除
EXPIRE key 60 给 key 挂一个 TTL,到期后 Redis 用两种方式清理:
- 惰性删除:访问到这个 key 时先检查是否过期,过期就删掉并返回空。好处是不用扫全库,坏处是「再也不被访问的过期 key」会一直占内存。
- 定期删除:后台每隔一段时间随机抽一批设置了 TTL 的 key,删掉其中过期的;如果这批里过期比例超过 25%,就继续抽下一批。抽样强度由
hz(默认 10)和active-expire-effort(默认 1,可调到 10)控制。
两种策略配合,过期 key 不会长期堆积,但内存不会立刻归还给操作系统——jemalloc 释放的内存留在自己的池子里复用,used_memory_rss 一时降不下来是正常现象。
淘汰策略
内存不是无限的,maxmemory 划出上限后,写满时就得按 maxmemory-policy 决定删谁。Redis 一共 8 种:
| 策略 | 淘汰范围 | 挑选方式 | 适用场景 |
|---|---|---|---|
noeviction | 不淘汰 | 写入直接报错 | 数据不能丢、宁可写失败(默认值) |
allkeys-lru | 所有 key | 最近最少使用 | 纯缓存,最常用 |
allkeys-lfu | 所有 key | 访问频率最低 | 热点集中、有长尾冷数据 |
allkeys-random | 所有 key | 随机 | 访问概率均匀,几乎不用 |
volatile-lru | 只挑设了 TTL 的 | 最近最少使用 | 缓存和持久数据混布 |
volatile-lfu | 只挑设了 TTL 的 | 访问频率最低 | 同上,对热点敏感 |
volatile-random | 只挑设了 TTL 的 | 随机 | 同上,几乎不用 |
volatile-ttl | 只挑设了 TTL 的 | 剩余 TTL 最短优先 | 希望快过期的先走 |
几个实操要点:
- 纯缓存实例用
allkeys-lru,别再给每个 key 都设 TTL 又用volatile-*——一旦漏设了 TTL,那部分 key 就永远淘汰不掉。 volatile-*在没有任何 key 设 TTL 时退化成noeviction,写满后写入直接报 OOM,这是线上最常见的「莫名其妙写不进去」。- LRU 是近似 LRU:每个 key 记一个 24 位的时钟,淘汰时随机采样
maxmemory-samples(默认 5)个 key 挑最旧的,采样数越大越接近真 LRU,代价是 CPU。 - LFU 需要额外维护访问频率计数器,适合「少量热点被反复访问、大量冷数据偶尔被扫」的分布,从 4.0 开始支持。
# 查看当前策略与上限
redis-cli CONFIG GET maxmemory maxmemory-policy

# 在线调整:4GB 上限 + allkeys-lru
redis-cli CONFIG SET maxmemory 4gb
redis-cli CONFIG SET maxmemory-policy allkeys-lru
持久化:RDB 与 AOF
内存数据断电就没,持久化解决「重启后数据还在不在」。Redis 给了两条路,可以单用也可以混用。
RDB 快照
某一时刻把整个内存 dump 成二进制文件(默认 dump.rdb)。触发方式有三种:SAVE(前台阻塞,生产禁用)、BGSAVE(fork 子进程写,主进程继续服务)、配置文件里的定时规则(如 save 900 1,900 秒内至少 1 次写就触发)。
优点是文件紧凑、加载极快,适合做备份和全量同步;缺点是两次快照之间的数据会丢,fork 时还有一次明显的延迟毛刺——这两点第 6 篇会展开。
AOF 日志
把每条写命令追加到日志文件,重启时重放。appendfsync 决定落盘时机:
always:每条命令都 fsync,最安全,性能最差(QPS 掉一个数量级)。everysec:每秒 fsync 一次,最多丢 1 秒数据,生产默认选它。no:交给操作系统,通常 30 秒左右才落盘,性能最好,丢数据最多。
AOF 文件会越写越大,Redis 通过重写(BGREWRITEAOF)把它压缩成「恢复当前数据集所需的最小命令集」。7.0 起 AOF 变成多部分(multi-part):一个 base 文件(RDB 或 AOF 格式)+ 若干 incr 增量文件 + 一个 manifest 清单,统一放在 appenddirname(默认 appendonlydir)目录里,重写时不再需要把整个文件读进内存拼一遍。
怎么选
| 对比项 | RDB | AOF |
|---|---|---|
| 数据安全 | 差,丢最后一次快照之后的数据 | 好,everysec 最多丢 1 秒 |
| 恢复速度 | 快,直接加载二进制 | 慢,逐条重放命令 |
| 文件体积 | 小,压缩存储 | 大,重写后才收敛 |
| 对性能影响 | fork + COW,有延迟毛刺 | 持续追加写,everysec 影响小 |
| 适用场景 | 备份、主从全量同步、能容忍丢数据 | 对数据安全有要求的业务实例 |
生产推荐两个都开:appendonly yes + 保留 RDB 定时快照。7.x 默认 aof-use-rdb-preamble yes,AOF 的 base 文件本身就是 RDB 格式,重启时先加载 RDB 再重放增量,兼顾恢复速度和数据安全。
# 当前持久化状态
redis-cli INFO persistence

# 手动触发快照 / AOF 重写
redis-cli BGSAVE
redis-cli BGREWRITEAOF
小结
- Redis 的定位是内存数据结构服务器,主业是缓存、会话、轻量队列、计数器四类场景,不适合当唯一数据源。
- 快的原因是纯内存 + IO 多路复用 + 无锁串行;代价是单线程怕慢命令,大 key 和
KEYS是头号杀手。 - 五种基本类型各有适用面,选型看「读全量还是改字段」「要不要顺序」「要不要排序」。
- 过期靠惰性 + 定期两种删除,写满靠 8 种
maxmemory-policy淘汰,纯缓存认准allkeys-lru。 - 持久化两条路:RDB 快、AOF 稳,生产建议都开,7.x 的 AOF 已经是多部分结构。
概念清楚了,下一篇直接动手:用 apt、源码、Docker 三种方式把 Redis 装起来,跑通第一次连接,见 安装与快速上手。