Alertmanager 核心概念与架构
Prometheus 系列的告警规则与 Alertmanager一篇讲过告警规则的写法和 alertmanager.yml 的入门配置,这篇开始换个主角:把 Alertmanager 本体拆开,讲清楚它到底在告警链路里扮演什么角色、内部是怎么处理一条告警的。后续的配置细节、高可用部署都建立在这篇的心智模型上。
为什么告警需要「调度台」
先想象一下没有 Alertmanager 的时代:Prometheus 评估出告警,直接发邮件。这套直连方案在小团队能凑合,规模一上来立刻崩坏:
- 告警轰炸:一台宿主机宕机,上面 20 个 Pod 各自触发一条告警,值班人瞬间收到 21 封邮件。每一条单独看都没错,合在一起就是噪音。
- 重复发送:Prometheus 每次评估都推一次 firing 状态的告警,不做收敛的话,一条不恢复的告警按评估间隔不停轰炸。
- 没有分级:磁盘 85% 和数据库主库挂了走同一个通道、同一个音量。什么都急等于什么都不急。
- 没有豁免机制:计划内发布、维护窗口,只能把告警规则整个删掉,事后还经常忘记加回来。
Alertmanager 就是为解决这些问题生的。它的定位一句话:Prometheus 只管「该不该报」,Alertmanager 决定「报给谁、怎么报、什么时候闭嘴」。它是告警链路上的调度台——上游来的原始告警在这里被分组、去重、按路由分发、该压制的压制,最后组装成一条像样的通知发出去。
与 Prometheus 的分工
这是最容易被初学者搞混的地方,先把边界划死:
| 职责 | Prometheus | Alertmanager |
|---|---|---|
| 评估告警规则 | 是,按 evaluation_interval 周期性求值 PromQL | 否,完全不管表达式 |
| 维护告警状态 | 是,inactive → pending → firing 都在它内存里 | 否,只接收已经 firing 的告警 |
| 接收告警 | 推送方 | 接收方,暴露 /api/v2/alerts 等接口 |
| 分组与去重 | 否 | 是,核心职责 |
| 决定发给谁 | 否 | 是,路由树按标签分发 |
| 抑制与静默 | 否 | 是 |
| 发通知 | 否 | 是,邮件、webhook、PagerDuty 等 |
记住这个分工,排障时就不容易找错地方:触发条件不对去查 Prometheus 的规则,通知行为不对去查 alertmanager.yml。
值得一提的是,Alertmanager 的入口并不只对 Prometheus 开放——任何能按 API 格式 POST 告警的系统都能接入。Grafana 自研的告警引擎就可以把通知交给统一的 Alertmanager 处理(或者直接用它内嵌的 Alertmanager 实现),多个告警源头共用一个调度台,路由和静默只维护一份,详见 Grafana 告警与通知。
告警源可以有很多个(多套 Prometheus、Grafana、业务自研检测),但通知策略只应该有一份。所有告警汇到同一个 Alertmanager(集群),分组、抑制、静默全局生效,不会出现「Prometheus 的告警静默了,Grafana 的还在响」这种分裂状态。
整体架构
Alertmanager 内部的处理流水线一图看懂:
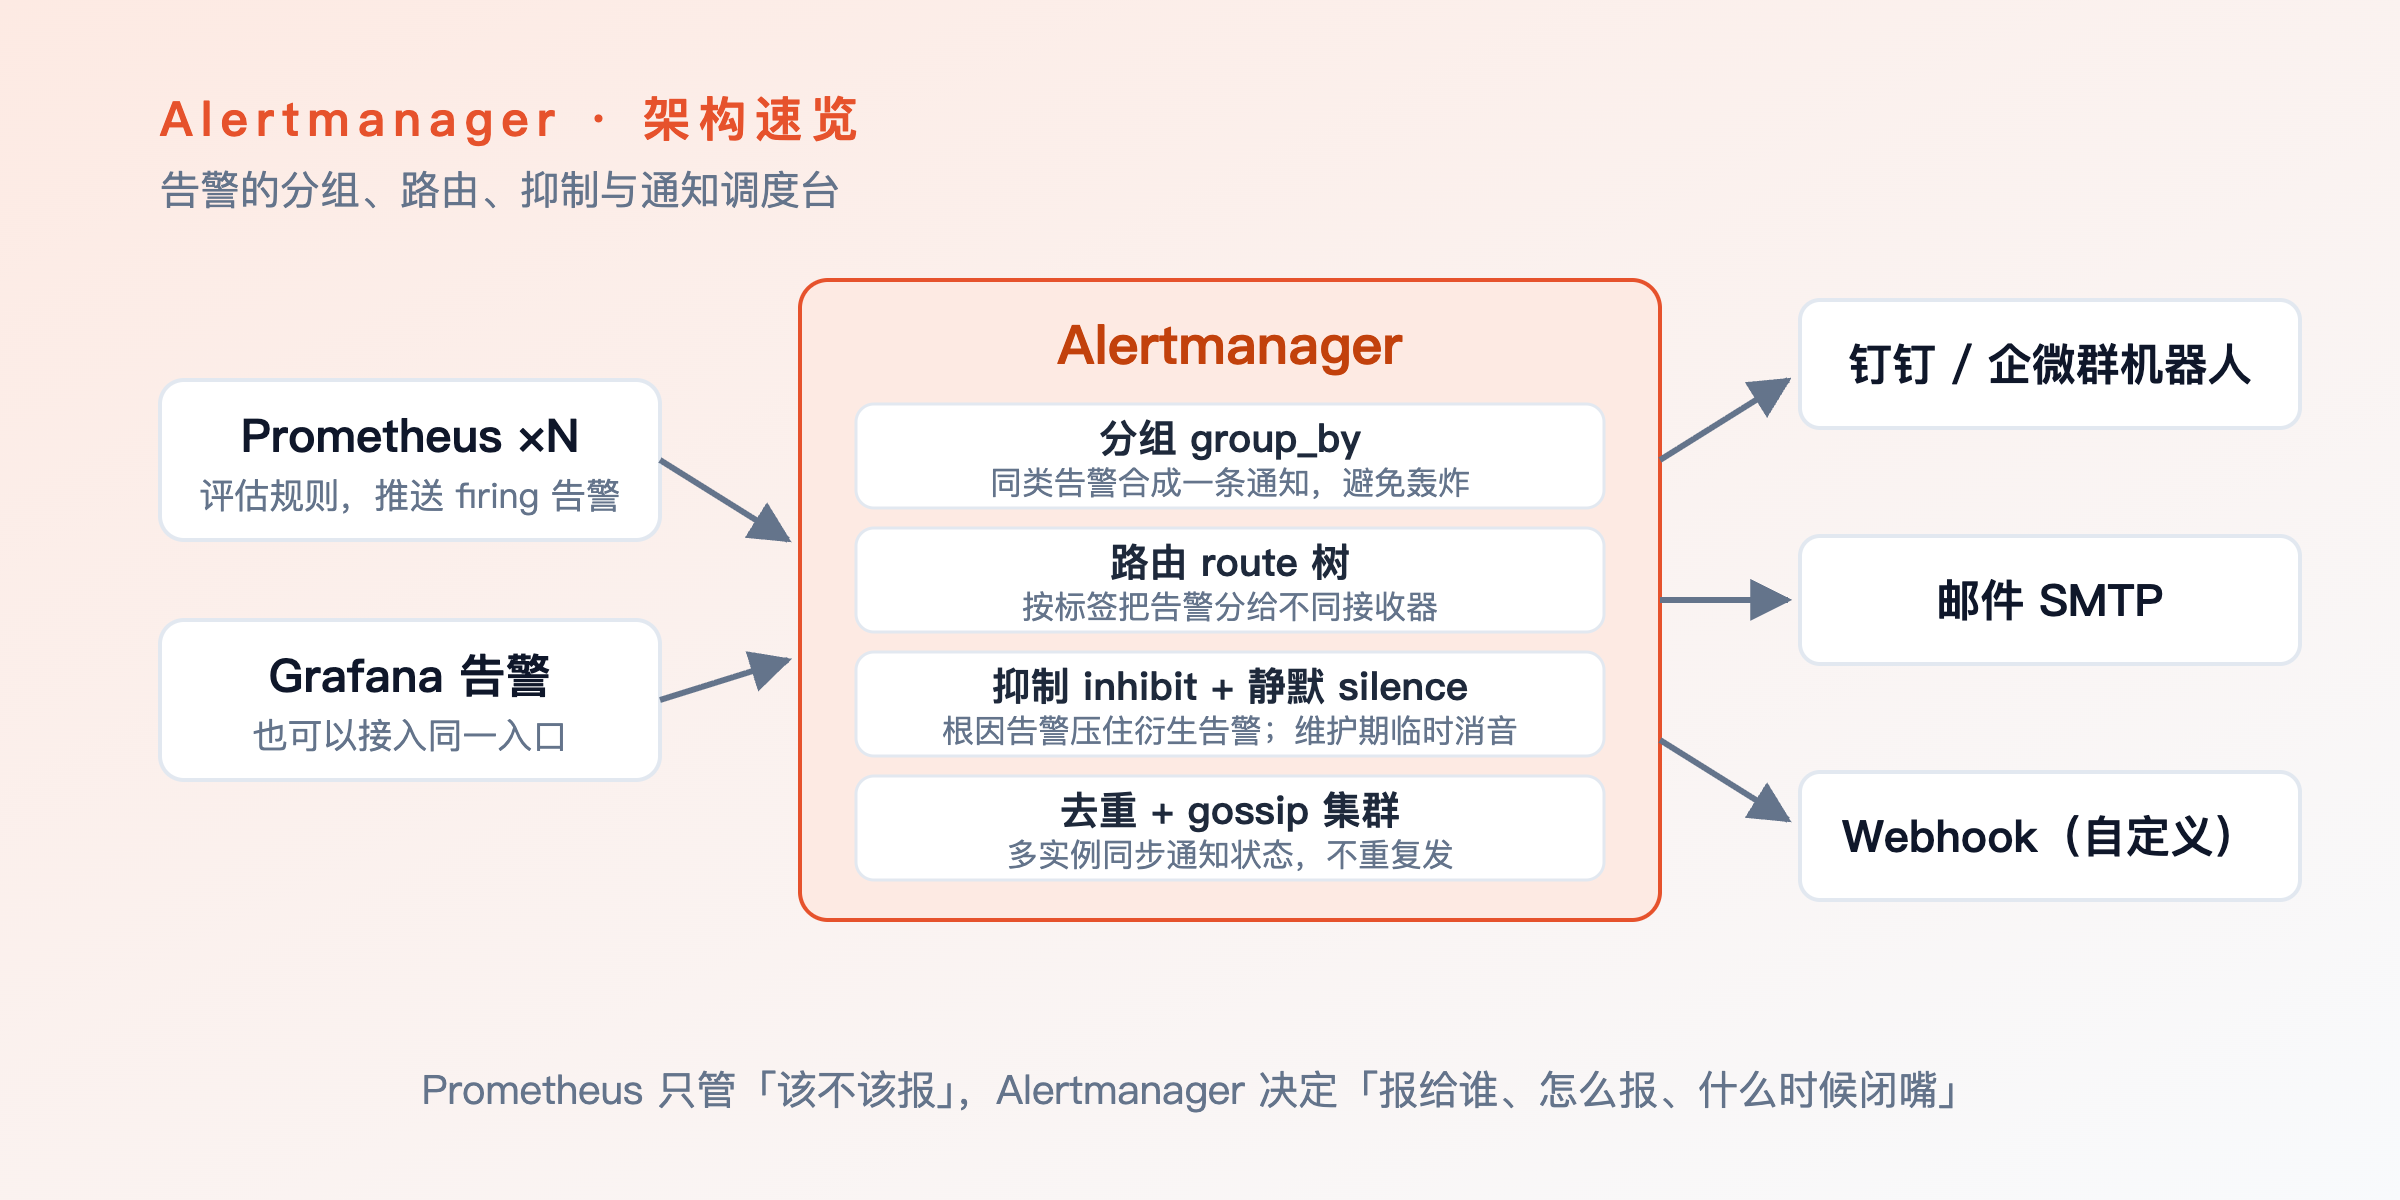
一条告警从进来到出去,数据流是这样的:
- 接收:上游(Prometheus、Grafana、任何客户端)把 firing/resolved 告警 POST 到
/api/v2/alerts。Alertmanager 不做任何条件判断,照单全收。 - 去重:多条相同标签集的告警合并成一条(多副本 Prometheus 场景的关键,下文细讲)。
- 分组:按路由节点上的
group_by标签,把告警归进不同的组。一组共享同一条通知。 - 路由:沿 route 树从上到下匹配,决定这条告警归哪个接收器(receiver)、走哪个分组节奏。
- 抑制与静默:通知发出前的最后两道闸——被抑制的告警不发声,命中静默规则的告警不发声。
- 通知:组内告警攒够等待时间(
group_wait)后,组装成消息发给接收器;之后按group_interval和repeat_interval的节奏续发。
整个过程可以理解为一条流水线:告警是原料,路由树是分拣线,分组是打包,抑制和静默是质检拦截,receiver 是快递发货。
Alertmanager 自己不存指标、不评估表达式,它的全部「记忆」就是当前活跃告警的集合、静默列表和通知日志(nflog,记录哪组告警发到什么阶段了)。这几个状态通过 gossip 在集群内同步,下文高可用一节细说。
五大核心机制
这五个机制是 Alertmanager 的全部精华,后面所有配置文章都是在给它们填参数。逐个建立直觉:
分组(group_by)
把「标签相似」的告警打包成一条通知。路由节点上配 group_by: ["alertname", "namespace"],同一告警名、同一命名空间下的 N 条告警合成一条消息发出。
一句话例子:K8s 集群里 shop 命名空间同时 15 个 Pod 报 KubePodCrashLooping,不分组是 15 条消息,按 namespace 分组后值班人只收到一条「shop 命名空间 15 个 Pod 崩溃」的汇总。
去重(dedup)
多个 Prometheus 副本(HA 部署)会向 Alertmanager 推送完全相同的告警。Alertmanager 按告警的标签集指纹判断:同一条告警来几次只处理一次,通知只发一份。
一句话例子:两台 Prometheus 各自评估出 NodeDown 告警推过来,值班人只收到一条通知,而不是重复的两条。
两个 Prometheus 副本如果外部标签(external_labels)配置不同,推来的告警标签集就有差异,指纹不同,去重失效,一条告警变两条。HA 场景下 external_labels 要保持一致——这是部署篇会展开的坑。
路由(route 树)
一棵按标签匹配的路由树,从根节点开始自上而下匹配:每个节点声明匹配条件(matchers)和目标接收器,告警标签命中哪个节点就走哪个接收器。默认命中即停,continue: true 可以让一条告警继续往下匹配、同时进入多个渠道。
一句话例子:severity=critical 的走电话值班群,severity=warning 的走 IM 普通群,team=infra 的不管级别都抄送基础设施组——三层逻辑就是路由树上的三个分支。
抑制(inhibit)
「根因已经报了,衍生的就别报了」。inhibit_rules 定义:当满足 source 条件的告警正在 firing 时,压掉满足 target 条件的告警,两边按 equal 里列的标签对齐到同一对象上。
一句话例子:NodeDown(critical)已经着火,那么同一台机器上的 DiskUsageHigh(warning)就没有再报的必要——机器都没了,磁盘高不高级别没意义。
静默(silence)
「我知道它在报,这段时间别烦我」。按标签匹配器圈一批告警,在起止时间内照常评估、照常 firing,但不发通知,过期自动失效。
一句话例子:周末凌晨给 shop 命名空间做发布,提前打一条 2 小时的静默,发布期间的告警全部消音,窗口结束自动恢复——不用改任何配置,也不会忘。
容易混。一句话区分:抑制是告警压告警(A 在着火,所以 B 闭嘴),静默是人主动消音(我知道 B 会响,先捂上)。抑制是自动的逻辑关系,静默是手动的运维操作。
高可用与 gossip
单点 Alertmanager 是告警链路的隐形单点:Prometheus 做了双副本、Exporter 层层监控,结果 Alertmanager 只有一台——它挂了,所有告警静默失败,你以为系统岁月静好,其实是没人报信。
Alertmanager 的高可用方案很简单:起多个实例组成集群,用 gossip 协议互相同步状态。同步的内容包括:
- 通知日志(nflog):哪个告警组已经发过通知、发到哪个阶段。保证一条通知不会被集群里多个实例重复发出。
- 静默列表:在任何一个实例上创建的静默,几秒内扩散到整个集群。
每个实例独立接收告警、独立做分组路由,靠 nflog 的 gossip 收敛避免重复通知。Prometheus 侧把所有实例地址都配上,推给任何一个(或全部)都行。
gossip 是最终一致的:静默创建后有几秒的扩散窗口,极端情况下个别实例可能短暂多发一条通知。对告警场景来说,「偶尔多发一条」远好过「一条都不发」,这是有意的取舍。
告警的生命周期
把 Prometheus 侧和 Alertmanager 侧串起来,一条告警的完整一生:
Prometheus 侧:
  表达式不成立          → inactive
  表达式成立,未满 for  → pending(不推送给 Alertmanager)
  持续满 for           → firing(开始推送)

Alertmanager 侧:
  接收 firing 告警
    → 去重合并
    → 按 group_by 归组,等待 group_wait(攒同组告警)
    → 路由匹配,选定接收器
    → 检查抑制规则和静默(命中则本次不发声)
    → 发出通知

恢复:
  表达式不再成立 → resolved 状态推给 Alertmanager
    → 接收器配了 send_resolved 则发一条「已恢复」通知
    → 告警从活跃列表移除
几个容易记错的点:
- pending 不会推送:只有 firing 状态的告警才会发给 Alertmanager,所以
for期间的「预热」在 Alertmanager 侧是完全不可见的。 - inactive/pending/firing 是 Prometheus 侧的状态机,规则评估、
for防抖的细节见 告警规则与 Alertmanager,这里不重复。 - resolved 通知默认不开:每种接收器类型有自己的默认值(webhook 默认发、邮件默认不发之类),想要「恢复提醒」就在接收器上显式配
send_resolved: true。
告警 10:00:00 触发、10:00:45 才收到通知,先别慌:去 Prometheus 的 Alerts 页确认 firing 时间点,差值对得上 group_wait(默认 30s)就是分组攒单的正常等待,不是链路故障。
小结
- 直连发邮件的时代死于轰炸、重复、没分级;Alertmanager 是告警调度台:Prometheus 管「该不该报」,它管「报给谁、怎么报、什么时候闭嘴」。
- 分工边界:规则评估和状态机归 Prometheus,分组、去重、路由、抑制、静默、发通知归 Alertmanager;改通知行为别去动规则文件。
- 数据流一条线:接收 → 去重 → 分组 → 路由 → 抑制/静默 → 通知。
- 五大机制一句话:分组打包、去重去重、路由分拣、抑制根因压衍生、静默手动消音。
- 单点 Alertmanager 是告警链路的隐形单点;多实例靠 gossip 同步通知日志和静默列表,最终一致。
- 生命周期里 pending 不推送、resolved 默认不发恢复通知,通知延迟先对
group_wait。
概念齐了,下一篇安装与快速上手直接把 Alertmanager 跑起来:最小配置、连上 Prometheus、端到端发出第一条测试告警。