prometheus-operator 与 kube-prometheus-stack
前面那套手写 prometheus.yml + 规则文件 + alertmanager.yml 的玩法,在虚拟机上没问题,进了 K8s 就捉襟见肘:Pod 朝生暮死、服务上下线频繁,每加一个监控对象都要改配置、reload Prometheus。prometheus-operator 把这件事彻底换了个思路——监控配置也是 K8s 资源:用 CRD 声明「要抓什么、要报什么」,operator 自动生成配置并让它生效。这篇从安装 kube-prometheus-stack 讲起,把核心 CRD 逐个过一遍,最后给一份定制和排坑清单。示例基于 kube-prometheus-stack 6x + K8s 1.30。
不熟悉 K8s 对象模型的先看 K8s 核心概念与架构;operator 底层依赖的服务发现与标签改写机制,原理见本系列[服务发现与 relabeling](/docs/observability/prometheus/服务发现与 relabeling)。
为什么需要 operator
手写方式在 K8s 里的痛点,踩过都知道:
- 每上一个新服务要抓指标,就得改
prometheus.yml,然后kill -HUP或调/-/reload让它生效——改配置的频率和发版频率挂钩,纯体力活。 - 配置写错没有校验环节,reload 完才发现 scrape job 没生效,开始翻日志。
- 规则文件、告警配置散落在各个 ConfigMap/Secret 里,没有版本、没有归属,团队协作全靠口头约定。
operator 模式的解法一句话:用 CRD 声明期望状态,controller 持续 watch 这些资源、把实际状态调和到期望状态。
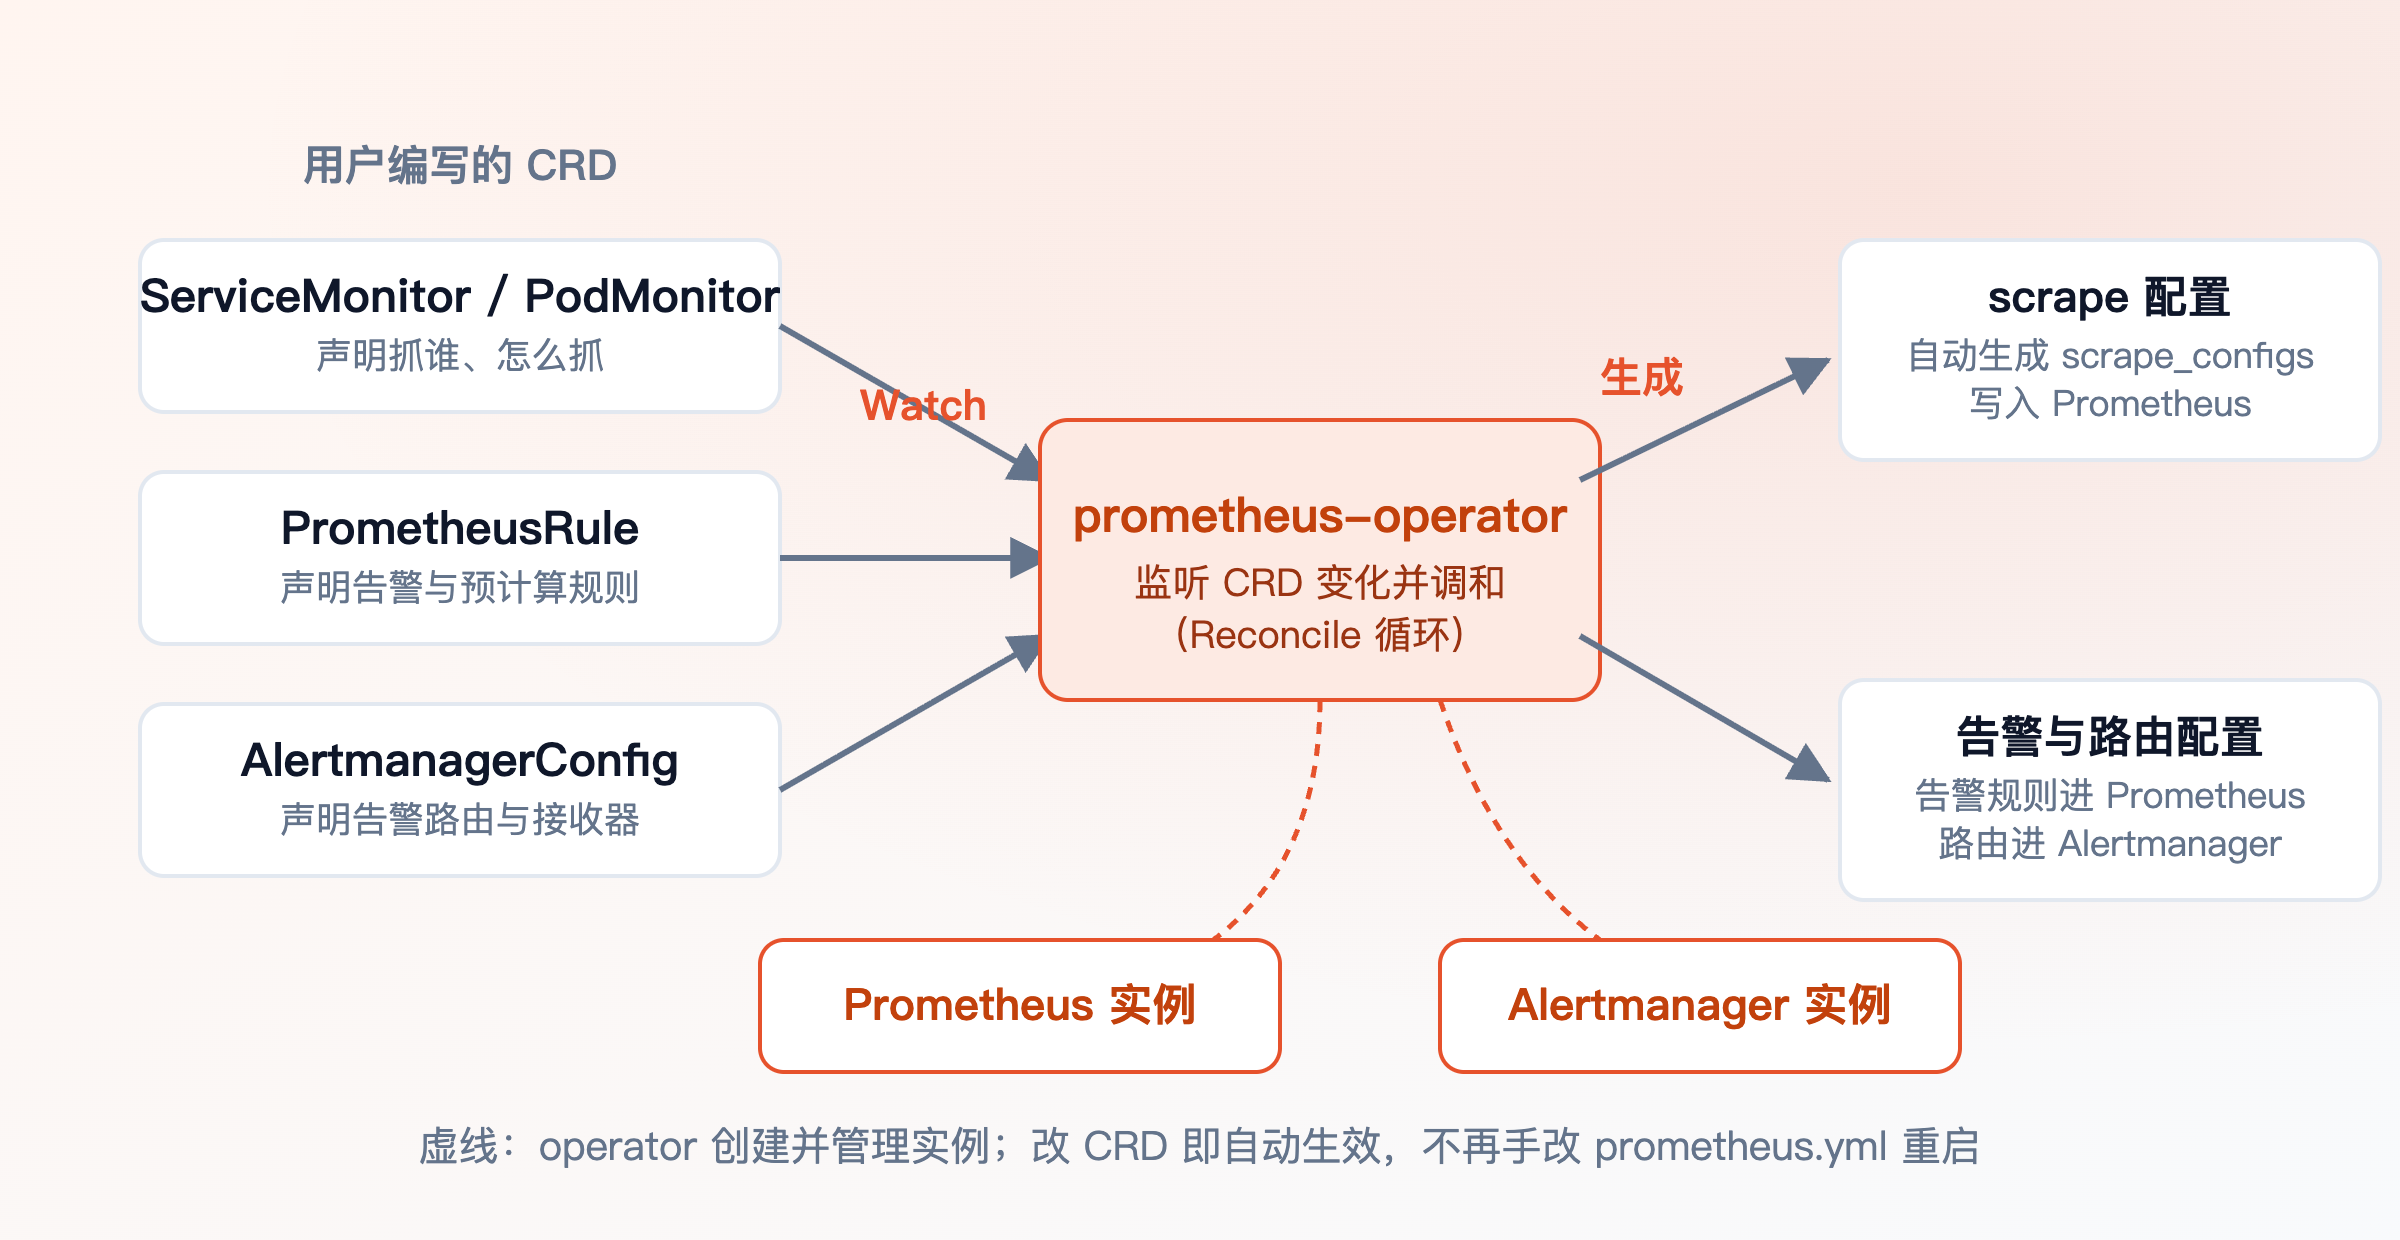
对应到 prometheus-operator,这个循环是:
- 你创建或修改一个 CR(比如
ServiceMonitor:我要抓带app: demo标签的 Service)。 - operator watch 到变化,把所有相关 CR 翻译成一份完整的
prometheus.yml,写进一个 Secret。 - Prometheus Pod 里的 config-reloader sidecar 发现 Secret 变了,调用 Prometheus 的
/-/reload接口热加载。
全程不用手改配置、不用重启进程。Prometheus 实例自己也只是 CRD 的一种——Prometheus CR 描述「几个副本、数据留多久、存储多大」,operator 负责把 StatefulSet 建出来。改 CR 等于改监控,GitOps 流程(Argo CD / Flux)天然能接住这套东西。
安装 kube-prometheus-stack
prometheus-operator chart 只装 operator 本身,实操中几乎没人单独装它——直接用 kube-prometheus-stack,一个 chart 把整套监控栈打包。两条命令:
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo update

helm install prometheus prometheus-community/kube-prometheus-stack \
  --namespace monitoring --create-namespace
装完看看得到了什么:
kubectl get pods -n monitoring
NAME                                                     READY   STATUS    RESTARTS   AGE
alertmanager-prometheus-kube-prometheus-alertmanager-0   2/2     Running   0          3m
prometheus-grafana-xxxxxxxxxx-xxxxx                      3/3     Running   0          3m
prometheus-kube-prometheus-operator-xxxxxxxxxx-xxxxx     1/1     Running   0          3m
prometheus-kube-state-metrics-xxxxxxxxxx-xxxxx           1/1     Running   0          3m
prometheus-prometheus-kube-prometheus-prometheus-0       2/2     Running   0          3m
prometheus-prometheus-node-exporter-xxxxx                1/1     Running   0          3m
一套栈直接齐活:
- Prometheus / Alertmanager:以 StatefulSet 运行,配置全部由 operator 生成。
- Grafana:已配好 Prometheus 数据源和 Kubernetes 系列官方面板。
- node-exporter:DaemonSet,每个节点一份,采主机指标。
- kube-state-metrics:把 K8s 对象状态翻译成指标(监控、日志与可观测性里讲过它和 Metrics Server 的分工)。
- 一堆默认 ServiceMonitor 和 PrometheusRule:kubelet、cAdvisor、apiserver、CoreDNS 的抓取与告警开箱即有,
kubectl get servicemonitor -A能看到全部。
升级就是改 values 再 helm upgrade:
helm upgrade prometheus prometheus-community/kube-prometheus-stack \
  -n monitoring -f values.yaml
Grafana 默认账号 admin,密码从 Secret 里取:
kubectl get secret -n monitoring prometheus-grafana -o jsonpath='{.data.admin-password}' | base64 -d
核心 CRD 逐个讲
kube-prometheus-stack 6x 注册的核心 CRD 五张,先有全局印象:
| CRD | 干什么 | 生成什么 |
|---|---|---|
Prometheus | 定义 Prometheus 实例本身 | StatefulSet + 主配置 |
ServiceMonitor | 声明抓哪些 Service | scrape_configs |
PodMonitor | 声明直接抓哪些 Pod | scrape_configs |
PrometheusRule | 声明告警/记录规则 | rule files |
AlertmanagerConfig | 声明告警路由与接收器 | alertmanager.yml 片段 |
Prometheus
apiVersion: monitoring.coreos.com/v1
kind: Prometheus
metadata:
  name: main
  namespace: monitoring
spec:
  replicas: 2                       # 双副本 HA,Alertmanager 侧自动去重
  retention: 15d                    # 数据保留时长
  storage:
    volumeClaimTemplate:
      spec:
        storageClassName: ssd
        resources:
          requests:
            storage: 50Gi
  serviceMonitorSelector: {}        # 匹配所有 ServiceMonitor(生产建议按标签圈定)
  podMonitorSelector: {}
  ruleSelector:
    matchLabels:
      role: alert-rules
用 chart 装的时候不用手写这个 CR——values 里 prometheus.prometheusSpec 下的字段会渲染成它。手写场景出现在不经过 chart 自行拼装栈的时候。
ServiceMonitor
最常用的一张 CR,声明「抓带某某标签的 Service 的某某端口」:
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: demo-app
  namespace: monitoring
  labels:
    release: prometheus            # 关键:和 Prometheus 实例的 selector 对上
spec:
  selector:
    matchLabels:
      app: demo-app                # 选中带这个标签的 Service
  namespaceSelector:
    matchNames:
      - default                    # 在哪些 namespace 里找这些 Service
  endpoints:
    - port: metrics                # Service 里名为 metrics 的端口
      interval: 30s
      path: /metrics
PodMonitor
没有 Service 的组件(比如 DaemonSet 形态的采集器)直接抓 Pod:
apiVersion: monitoring.coreos.com/v1
kind: PodMonitor
metadata:
  name: node-log-agent
  namespace: monitoring
  labels:
    release: prometheus
spec:
  selector:
    matchLabels:
      app: log-agent
  namespaceSelector:
    matchNames:
      - logging
  podMetricsEndpoints:
    - port: metrics
      interval: 30s
PrometheusRule
告警规则包在 CRD 里,spec.groups 下就是普通的规则语法:
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: demo-app-alerts
  namespace: monitoring
  labels:
    release: prometheus            # 同样要被 ruleSelector 选中
spec:
  groups:
    - name: demo-app
      rules:
        - alert: DemoAppDown
          expr: up{job="demo-app"} == 0
          for: 2m
          labels:
            severity: critical
          annotations:
            summary: "demo-app 实例 {{ $labels.instance }} 抓取失败"
AlertmanagerConfig
告警路由和接收器也变成了 CR,不用再手改 alertmanager.yml:
apiVersion: monitoring.coreos.com/v1alpha1
kind: AlertmanagerConfig
metadata:
  name: demo-app-route
  namespace: monitoring
  labels:
    release: prometheus
spec:
  route:
    receiver: demo-webhook
    groupBy: ["alertname", "namespace"]
    groupWait: 30s
    repeatInterval: 4h
  receivers:
    - name: demo-webhook
      webhookConfigs:
        - url: http://alert-gateway:8080/demo
          sendResolved: true
operator 会把各处选中的 AlertmanagerConfig 合并进 Alertmanager 主配置,并按 CR 所在 namespace 自动加路由约束——A 团队的配置默认只能路由 A 团队 namespace 的告警,多团队共用时这层隔离是白送的。
ServiceMonitor 实战
走一遍完整闭环:让一个 demo 服务的指标出现在 Prometheus 里。这是日常最高频的操作,照抄可用。
第一步:应用暴露 /metrics。假设 demo-app 已在 8080 端口的 /metrics 路径暴露 Prometheus 格式指标(应用侧怎么埋点见核心概念与架构)。
第二步:Service 给端口起名、打标签。ServiceMonitor 按端口名引用端口,按标签选中 Service,两个都要对:
apiVersion: v1
kind: Service
metadata:
  name: demo-app
  namespace: default
  labels:
    app: demo-app                  # ServiceMonitor 的 selector 要匹配它
spec:
  selector:
    app: demo-app
  ports:
    - name: metrics                # ServiceMonitor 的 endpoints.port 引用这个名字
      port: 8080
      targetPort: 8080
第三步:写 ServiceMonitor。注意两个 selector:spec.selector 选 Service,spec.namespaceSelector 圈定查找范围:
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: demo-app
  namespace: monitoring
  labels:
    release: prometheus            # chart 装的 Prometheus 只选带这个标签的 CR
spec:
  selector:
    matchLabels:
      app: demo-app
  namespaceSelector:
    matchNames:
      - default                    # Service 在 default;不写默认只找 CR 自己的 namespace
  endpoints:
    - port: metrics
      interval: 30s
kubectl apply -f servicemonitor-demo.yaml
第四步:验证 target UP。等十几秒(operator 重新生成配置 + reload + 下一个抓取周期),到 Prometheus UI 的 Status → Targets 搜 demo-app,状态应为 UP。命令行验证直接查 up:
up{job="demo-app", namespace="default"}
值为 1 即闭环完成,接下来就能配面板和告警了。
标签匹配是这条链路最常见的翻车点,集中说三个:
release标签缺失:chart 默认让 Prometheus 只管理带release: <release名>标签的 ServiceMonitor / PodMonitor / PrometheusRule。CR 建了半天 targets 不出现,第一件事就查这个标签。namespaceSelector没配:CR 建在monitoringnamespace,要监控的 Service 在default,不配namespaceSelector就永远找不到——它默认只看 CR 自己所在的 namespace。- Service 标签和 selector 对不上:
spec.selector.matchLabels匹配的是 Service 的 metadata labels,不是 Pod 的标签,也不是 Service 的spec.selector。改 Deployment 标签不顶用,要改的是 Service 自己的标签。
PrometheusRule 实战
自定义告警规则同样包进 CRD,规则语法和上一篇手写规则文件完全一致,只是外面套了一层 spec.groups:
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: shop-alerts
  namespace: monitoring
  labels:
    release: prometheus
spec:
  groups:
    - name: shop
      rules:
        - alert: ShopOrderSuccessRateLow
          expr: |
            sum(rate(shop_orders_total{status="success"}[5m]))
              /
            sum(rate(shop_orders_total[5m])) < 0.95
          for: 5m
          labels:
            severity: critical
            team: shop
          annotations:
            summary: "下单成功率低于 95%"
            description: "shop 服务最近 5 分钟下单成功率 {{ $value | humanizePercentage }},已持续 5 分钟"
kubectl apply -f prometheusrule-shop.yaml

# 确认 CR 已入库
kubectl get prometheusrule -n monitoring shop-alerts
Prometheus UI 的 Alerts 页能看到这条规则的 pending/firing 状态即为生效。规则写错(比如表达式语法错误)不会搞挂 Prometheus——operator 会拒掉校验失败的规则并在日志里报错,看 operator 日志即可定位(排坑一节细说)。
告警规则变成 CRD 之后,可以和服务代码放在同一个仓库、同一个 Helm chart 里发布——应用上新版本,配套告警一起上线。这是 operator 模式相比「规则文件集中堆放」最实在的收益之一。
values 常用定制
chart 默认配置能跑,生产上常改的就那么几项,集中在一个 values.yaml 里:
prometheus:
  prometheusSpec:
    retention: 15d                     # 数据保留 15 天
    retentionSize: 40GB                # 双保险:容量到限也触发清理
    storageSpec:                       # 不配就是 emptyDir,Pod 重建数据全没
      volumeClaimTemplate:
        spec:
          storageClassName: ssd
          resources:
            requests:
              storage: 50Gi
    resources:
      requests:
        cpu: 500m
        memory: 2Gi
      limits:
        memory: 4Gi

grafana:
  adminPassword: "change-me-now"       # 生产别用默认密码
  persistence:
    enabled: true                      # 持久化 dashboard,重启不丢
    size: 5Gi
    storageClassName: ssd

alertmanager:
  config:                              # 等价于手写 alertmanager.yml
    global:
      smtp_smarthost: smtp.exmail.qq.com:465
      smtp_from: alert@example.com
      smtp_auth_username: alert@example.com
      smtp_auth_password: xxxxxxxx
    route:
      receiver: default
      group_by: ["alertname", "namespace"]
      repeat_interval: 4h
    receivers:
      - name: default
        webhook_configs:
          - url: http://alert-gateway:8080/alert

defaultRules:
  create: true                         # 自带几十条 K8s 告警规则
  rules:
    etcd: false                        # 托管 K8s(EKS/ACK)摸不到 etcd,关掉
    kubeScheduler: false               # 同理,调度器不可达

kube-state-metrics:
  enabled: true

nodeExporter:
  enabled: true
改完 helm upgrade ... -f values.yaml 生效。几个提醒:
prometheusSpec.storageSpec必配:默认 emptyDir 意味着 Prometheus Pod 一重建历史数据清零,任何正式环境都不能接受。- 托管集群关掉摸不到的组件:EKS/ACK/TKE 这类托管 K8s,etcd、scheduler、controller-manager 不暴露给你,对应的抓取任务只会持续报错。除了上面关掉默认规则,还要把对应 ServiceMonitor 用
kubeEtcd.enabled: false、kubeScheduler.enabled: false这类开关一并摘掉。 - Grafana 自带的几十块 Kubernetes 面板是排障的第一手材料,别急着删。
与手写方式的取舍
operator 不是银弹,复杂度是真实代价:多一层 CRD 抽象、多一个 controller 要维护、chart 升级偶尔要手动先升 CRD、排查问题要看两层(CR 状态和 operator 日志)。
什么情况下裸写 prometheus.yml 反而简单:
- 单虚拟机 / 几台虚拟机的监控:没有 K8s,operator 无从谈起,二进制或 docker-compose 起一个 Prometheus + Alertmanager 足够。
- 极简需求:就抓三五个固定 target,一年不改一次配置,手写文件加 reload 的心智成本更低。
- 非 K8s 环境的混合采集:要监控交换机、带外管理口、老系统,这些本来就得靠
static_configs和 file_sd 写在主配置里。
反过来,只要监控对象长在 K8s 里、团队多人协作、配置变更频繁,声明式 CRD + GitOps 的收益远超那层复杂度。实际中两者经常混用:operator 管 K8s 内部,再用 chart 的 prometheus.prometheusSpec.additionalScrapeConfigs 挂几段手写的外部抓取配置。
常见坑
ServiceMonitor 建了但 targets 里不出现。按出现频率排序的自查清单:
- CR 的
release: prometheus标签有没有(release 名换成你自己的)。 namespaceSelector有没有圈到目标 Service 所在 namespace。spec.selector.matchLabels和 Service 的 metadata labels 对不对得上。endpoints.port引用的端口名在 Service 里存不存在。- 以上都对就去看 operator 日志(见下面第三条),大概率是配置生成环节报错。
CRD 版本和 chart 绑定。kube-prometheus-stack 升级时,monitoring.coreos.com 那批 CRD 不会跟着自动升级——Helm 不管理已安装的 CRD。chart 跨大版本升级前先看它的 README / UPGRADE 说明,按文档先 kubectl apply 新版 CRD 再升 chart;跳步容易撞上「新 chart 用了新字段、旧 CRD 不认」的错。
改了 CR 没生效,先看 operator 日志。operator 是整套系统的中枢,任何「我明明改了怎么没用」都先翻它:
kubectl logs -n monitoring deploy/prometheus-kube-prometheus-operator
典型输出长这样:
level=warn msg="rejected invalid PrometheusRule" ...
level=error msg="sync \"monitoring/main\" failed: ..."
规则语法错、CR 字段写错,这里都有明确报错。operator 日志干净但 Prometheus 里还是没有,再看 Prometheus 容器日志,以及 UI 的 Status → Configuration 里实际生效的配置——那才是真正加载进去的东西。
多 namespace 的监视范围。operator 默认 watch 全集群的 CRD(可用 chart 的 prometheusOperator.namespaces 收窄到指定 namespace)。多团队共用集群时的常见做法:operator 保持全集群 watch,但每套环境各起一个 Prometheus 实例,用 serviceMonitorNamespaceSelector + serviceMonitorSelector 把各实例的职责圈清楚,避免一个实例抓全集群导致基数爆炸。反过来,如果某些 namespace 的 CR 死活不被处理,先确认 operator 的 watch 范围配置有没有把它们排除在外。
小结
- operator 模式:CRD 声明期望状态,controller 生成配置并热加载,监控配置从此进 GitOps 流程。
- 安装直接用 kube-prometheus-stack 一把梭:Prometheus / Alertmanager / Grafana / exporter / 默认规则一站配齐,升级靠
helm upgrade。 - 五张核心 CRD:
Prometheus定义实例,ServiceMonitor/PodMonitor定义抓谁,PrometheusRule定义告警,AlertmanagerConfig定义路由。 - ServiceMonitor 闭环四步:应用暴露
/metrics→ Service 起名打标签 → CR 双 selector 匹配 → 查 target UP;翻车先查release标签和namespaceSelector。 - 生产 values 必改:Prometheus 持久化存储、Grafana 密码与持久化、托管集群关掉 etcd / scheduler 类默认规则。
- 排坑三板斧:查 CR 标签匹配 → 看 operator 日志 → 看 Prometheus 实际生效配置。