Prometheus 核心概念与架构
为什么监控选 Prometheus
Zabbix 时代的监控思路是「主机中心」:每台服务器在监控平台里注册成一个 Host,挂上固定的检查项,出报表、出告警。这套思路在机器固定、业务稳定的年代很好用,但到了云原生环境就开始水土不服:
- 环境是动态的:K8s 里 Pod 随时被调度、销毁、重建,IP 说变就变。按「主机 + IP」维护监控对象,清单永远是过期的。
- 维度是爆炸的:同样是 HTTP 请求数,你可能想按实例看、按接口路径看、按状态码看、按命名空间聚合看。传统监控每一项都要单独配,而 Prometheus 用标签(Label)天然支持多维查询。
- 服务发现是刚需:新实例上线应该自动进入监控,而不是等人手工添加。Prometheus 原生支持 K8s、Consul 等各种服务发现。
Prometheus 用「拉模型 + 标签模型 + 服务发现」这三板斧解决了上述问题,加上它是 CNCF 毕业项目(仅次于 Kubernetes 的第二个毕业项目),生态里的 Exporter 几乎覆盖所有主流中间件,说它云原生监控的事实标准并不夸张。
K8s 里的 Metrics Server 只提供「当前时刻」的 CPU/内存用量,给 kubectl top 和 HPA 用,不存历史数据,详见 监控、日志与可观测性。Prometheus 则是通用的时序数据库 + 告警引擎,两者不是竞争关系,是分工关系。
Pull 拉模型
Prometheus 最标志性的设计:由 Server 主动定期去目标上拉取(scrape)指标,而不是目标把指标推上来。目标只需要暴露一个 /metrics HTTP 端点,剩下的由 Prometheus 控制。
| 对比项 | Pull(Prometheus) | Push(如 Graphite、StatsD) |
|---|---|---|
| 目标健康 | 拉不到就是出问题,「抓取失败」本身就是告警信号 | 收不到数据分不清是目标挂了还是目标没发 |
| 压力控制 | Server 自己决定抓取间隔和超时,节奏可控 | 目标们想推就推,洪峰时服务端被动挨打 |
| 配置位置 | 抓取目标、间隔、标签重写都集中在 Server 配置里 | 分散在每个客户端上,改一次要动所有节点 |
| 短生命周期任务 | 拉不到就跑了的 Job 会丢数据,需要 Pushgateway 兜底 | 天然适合,推完就走 |
Pull 的好处概括成三条:
- 目标健康自明:
up指标直接反映目标能不能被抓到,监控系统的「元监控」不用另外搭。 - 压力自控:
scrape_interval、scrape_timeout都在 Server 端调,目标再多也不会被突发流量冲垮。 - 配置集中:加一个抓取目标只改 Server 的
prometheus.yml,不用登录业务机器。
短生命周期任务(批处理 Job、CI 构建)可能活不到下一次抓取,这类场景把指标推给 Pushgateway,再由 Prometheus 从 Pushgateway 拉。注意它是「例外」不是「常规」:长期在线的服务都应该走标准 Pull,滥用 Pushgateway 会带来数据过期、单点等问题。
核心概念
Prometheus 的数据模型只有四个关键名词,一次记住:
- 时间序列(Time Series):由「指标名 + 一组标签」唯一标识的一条数据流。同一个指标名下,标签组合不同就是不同的序列。
- 样本(Sample):一个具体的数据点 = 时间戳 + float64 数值。3.x 起也原生支持直方图样本和 UTF-8 指标名,但日常打交道最多的还是时间戳 + 数值。
- 指标名(Metric Name):描述被测量的东西,如
http_requests_total、node_cpu_seconds_total,习惯用蛇形小写加单位后缀。 - 标签(Label):键值对,给序列加维度,如
job="node"、instance="10.0.0.1:9100"。查询、聚合全靠它。
拿一个实际的指标写法举例(这类带花括号的写法只会出现在代码块里):
http_requests_total{method="GET", path="/api/users", status="200"} 1027
意思是:指标 http_requests_total,带了 method / path / status 三个标签维度,当前值 1027。查询时按任意标签组合过滤、聚合,这就是标签模型的威力。
四种指标类型(写在 /metrics 输出里的类型声明,客户端库按类型埋点):
| 类型 | 语义 | 典型场景 |
|---|---|---|
| Counter | 只增不减的计数器(重启归零) | 请求总数、错误总数;配合 rate() 算速率 |
| Gauge | 可增可减的瞬时值 | 内存用量、队列长度、温度 |
| Histogram | 把观测值分桶统计,可算任意分位数 | 请求耗时分布、响应大小分布 |
| Summary | 客户端直接算好的分位数 + 总和 + 计数 | 与 Histogram 类似,但分位数不可跨实例聚合,优先选 Histogram |
计数用 Counter,瞬时值用 Gauge,要算 P95/P99 延迟用 Histogram。Summary 的分位数在客户端算死,没法对多个实例聚合,新代码一般直接用 Histogram。
指标类型详解
表格只是速查,这节把四种类型的语义、暴露格式和查询姿势一次讲透。
Counter:只增不减的计数器
语义上是一个只往上走的累加值:从进程启动开始计,重启归零。/metrics 里的样子:
# TYPE http_requests_total counter
http_requests_total{method="GET",path="/api/users",status="200"} 1027
裸值几乎没意义——1027 是「从启动到现在」的总量,你不知道它是今天攒的还是上个月攒的。Counter 的正确打开方式是配速率函数:
# 每秒请求数(QPS)
rate(http_requests_total[5m])

# 最近 1 小时的请求总量
increase(http_requests_total[1h])
两个注意点:进程重启归零时 rate()/increase() 会自动处理这个跳变,不用你操心;increase() 算出来的可能带小数(它是按采样点外推的),不是 bug。
Gauge:可增可减的瞬时值
表示「此刻是多少」的值,能上能下:内存用量、队列长度、温度、在线人数。
# TYPE node_memory_MemFree_bytes gauge
node_memory_MemFree_bytes 3.579312128e+09
Gauge 的裸值就是答案,直接查、直接聚合:
# 当前内存空闲量(直接出值)
node_memory_MemFree_bytes

# 各实例平均值
avg(node_memory_MemFree_bytes)
注意别犯方向性错误:对 Gauge 用 rate() 没有意义(它不是累加量),对 Counter 直接取 avg() 也没有意义。
Histogram:分桶统计的分布
延迟、响应大小这类「每个请求一个数」的观测,平均值会掩盖长尾(1 个 10 秒的请求 + 99 个 10 毫秒的请求,平均 109 毫秒,看起来岁月静好)。Histogram 把观测值按预设的桶边界分桶计数,暴露的是一族序列:
# TYPE http_request_duration_seconds histogram
http_request_duration_seconds_bucket{le="0.1"} 24054
http_request_duration_seconds_bucket{le="0.5"} 25110
http_request_duration_seconds_bucket{le="+Inf"} 25144
http_request_duration_seconds_sum 53423
http_request_duration_seconds_count 25144
桶是累计语义:le="0.5" 的计数包含所有 ≤0.5 秒的请求(含 le="0.1" 的那部分)。_sum 是所有观测值的总和,_count 是总次数。有了这套数据,服务端可以算任意分位数:
# P99 延迟(注意先对桶做 rate,再算分位数)
histogram_quantile(0.99, rate(http_request_duration_seconds_bucket[5m]))

# 平均延迟(sum 除以 count,配 rate)
rate(http_request_duration_seconds_sum[5m]) / rate(http_request_duration_seconds_count[5m])
两个坑:桶边界是你埋点时定的,分位数只能在已有边界间插值估算,边界太稀疏精度就差;每个桶边界都是一条序列,le 太多再乘上其他标签维度,基数会爆炸。3.x 的原生直方图(Native Histograms)改了存储格式缓解这个问题,日常遇到的不多,知道有这回事即可。
Summary:客户端算好的摘要
和 Histogram 目标相同(看分布),但分位数在客户端进程内预先算好,暴露成这样:
# TYPE rpc_duration_seconds summary
rpc_duration_seconds{quantile="0.99"} 0.012
rpc_duration_seconds_sum 1.7560473e+06
rpc_duration_seconds_count 2693
关键差异决定了它的命运:分位数是客户端算死的固定值,没法对多个实例聚合(十台机器的 P99 平均不等于集群 P99),也没法事后换分位点重新算。Histogram 把原始分布(桶计数)交给了服务端,聚合和重算都自由得多。所以结论很简单:新代码用 Histogram,Summary 只在维护老代码时认识它就好。
架构组件
整体架构一张图看懂:
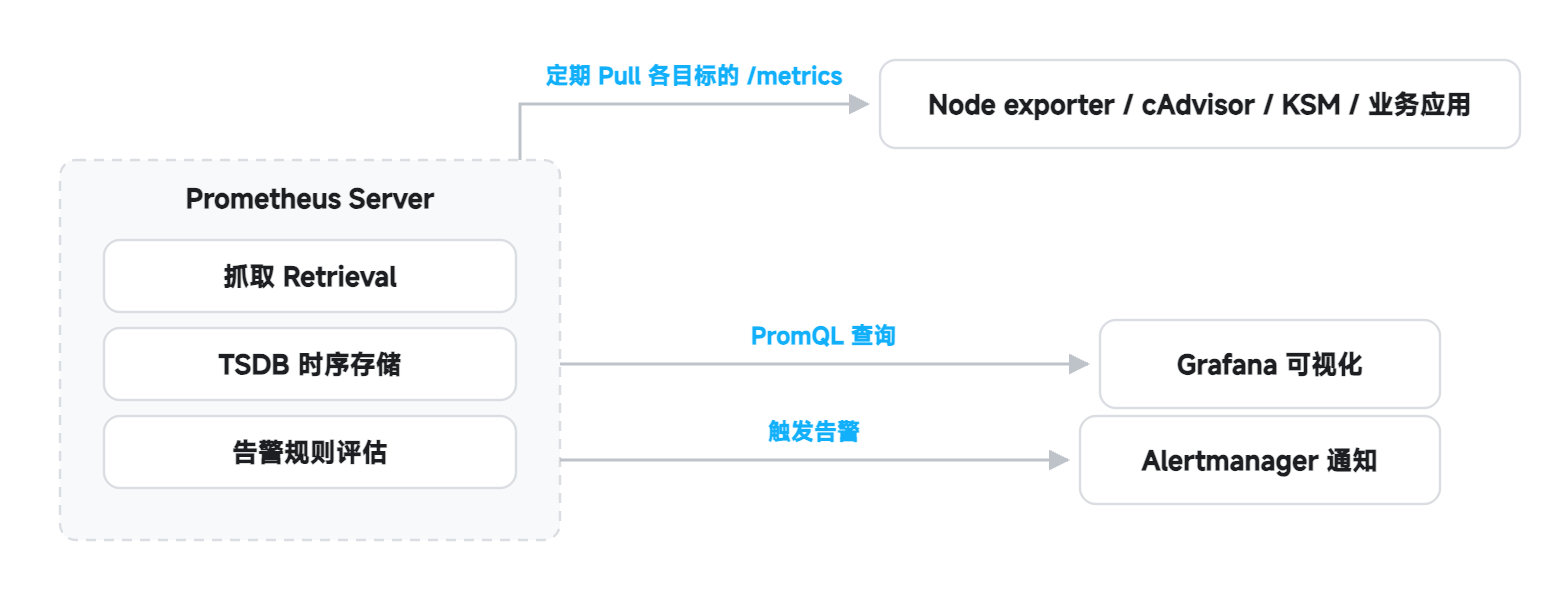
各角色逐个说:
- Prometheus Server:核心,一个进程里打包了三件事——
- Retrieval(抓取):按配置定期去各目标的
/metrics拉数据,支持服务发现动态出目标列表。 - TSDB(时序存储):内置的时序数据库,把样本写到本地磁盘,按时间分块、压缩、建索引。
- HTTP Server + 告警评估:提供 PromQL 查询接口和 Web UI;同时按
evaluation_interval轮询评估告警规则,状态满足就把告警推给 Alertmanager。
- Retrieval(抓取):按配置定期去各目标的
- Exporters(导出器):让「不会说 Prometheus 语言」的系统暴露
/metrics。Node Exporter 暴露主机指标、MySQL Exporter 暴露数据库指标、Blackbox Exporter 做黑盒探测……应用自己的代码则直接用 client library 埋点,不用 Exporter。 - Alertmanager(告警管理器):Server 只负责「判断该不该告」,Alertmanager 负责「怎么告」——去重、分组、静默、按路由发到邮件/钉钉/企业微信/Webhook。生产上通常独立部署,可以起多个做高可用。
- Grafana(可视化):Prometheus 自带的 UI 只适合临时查询和调试,正经的仪表盘交给 Grafana,把 Prometheus 配成数据源即可。
- Pushgateway(推送网关):前面说过的例外角色,承接短生命周期任务推上来的指标,Server 把它当普通目标抓。
把 Prometheus Server 当成「采集器 + 数据库 + 查询引擎 + 告警触发器」四合一;Exporter 是各种系统的「翻译官」;Alertmanager 是「告警调度中心」;Grafana 是「显示器」;Pushgateway 是「临时寄存柜」。
数据流与存储
一条指标从产生到告警的完整链路:
目标 /metrics 端点
  → Retrieval 按 scrape_interval 抓取
  → 样本写入本地 TSDB(先写 WAL 日志再落盘分块)
  → PromQL 查询读 TSDB(UI / Grafana / API)
  → 告警规则按 evaluation_interval 评估,命中则推给 Alertmanager
存储上几个关键点:
- 本地磁盘:TSDB 把数据写在 Server 本机,按 2 小时一个 block 切分,后台做压缩合并。
--storage.tsdb.path指定数据目录,--storage.tsdb.retention.time控制保留期(默认 15 天)。 - WAL 兜底:样本先写预写日志再进 block,进程崩溃重启后能恢复最近两小时的内存数据。
- 查询与告警共用同一份数据:UI/Grafana 的查询和规则的告警评估读的都是本地 TSDB,数据只有一份,不存在两套口径对不上的问题。
- 不是长期存储:本地 TSDB 的设计目标是「单机、高效、够用」,不承诺数据安全性和无限保留。要存一年以上的数据、要跨集群全局查询,得上 Thanos、VictoriaMetrics、Mimir 这类远端存储方案——这是第 8 篇的主题。
它不适合做「唯一事实来源」的持久存储:磁盘满了会停止写入、机器挂了数据就没了。容量规划、定期备份、重要数据走远端存储,都是生产上绕不开的事。
适用边界
Prometheus 强在指标,但也有明确的「不该用它」的场景:
- 日志:日志是非结构化的离散事件,体量比指标大几个数量级。日志交给 Loki / ELK,Prometheus 管不了也不该管。
- 链路追踪:一次请求跨多个服务的调用链,要用 OpenTelemetry + Tempo/Jaeger。指标只能告诉你「慢了」,追踪才能告诉你「慢在哪一跳」。
- 账单级精确计数:抓取是按间隔采样的,两次抓取之间的瞬间波动会被平均掉;抓取失败还会丢窗口。算钱、结算这类「一分钱都不能差」的场景,用账单系统而不是
rate()出来的数字。 - 高基数是头号敌人:每个标签组合都是一条独立序列,序列数 = 内存和磁盘开销。把 user_id、URL 全路径、请求 ID 这类取值近乎无限的维度塞进标签,序列数会爆炸,轻则内存暴涨重则 OOM。标签设计是 Prometheus 使用里最容易踩的坑,第 8 篇专门展开。
Prometheus 是「指标的时序数据库 + 告警引擎」,不是日志系统、不是 APM、不是账本。可观测性三支柱各归各的工具,配合方式见 监控、日志与可观测性。
小结
- 云原生环境动态、多维、需要服务发现,Prometheus 的拉模型 + 标签模型正好对症,是事实标准。
- Pull 模型:Server 主动抓取,目标健康自明、压力自控、配置集中;短任务才用 Pushgateway 兜底。
- 数据模型四件套:时间序列 = 指标名 + 标签,样本 = 时间戳 + 数值;指标类型分 Counter / Gauge / Histogram / Summary。
- 架构上 Server(抓取 + TSDB + 告警评估)是核心,Exporter 做翻译,Alertmanager 管告警分发,Grafana 管看图。
- 本地 TSDB 够用但不是长期存储;日志、追踪、精确计费都不归它管;高基数是要时刻警惕的头号敌人。
概念过完,下一篇《部署与快速上手》直接用 Docker 把 Prometheus 跑起来,完成第一次抓取和第一次查询。